Et hold på ti personer, og halvdelen af det venter. Backend-lederen er blokeret på grund af krav. QA er blokeret på grund af backend. Projektlederen bruger hvert standup-møde på at indsamle status i stedet for at rydde forhindringer af vejen. Estimatet lød på otte måneder, og hver uges koordinering gør det tal sværere at forsvare.
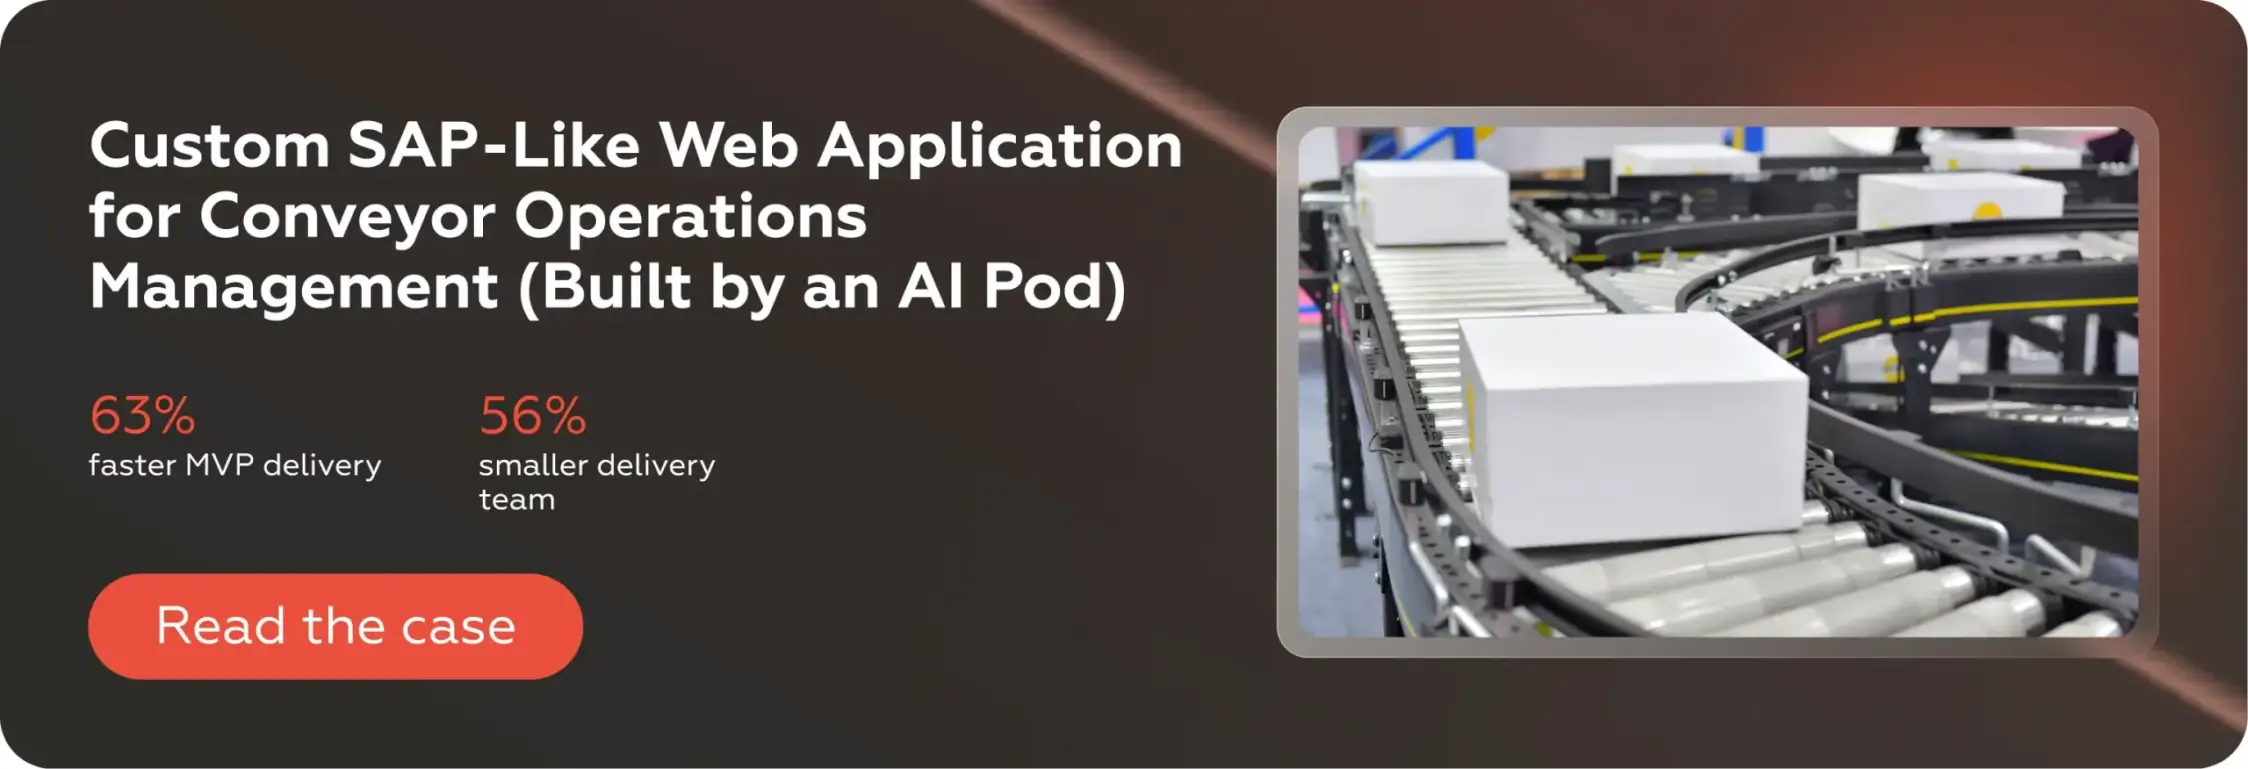
Da en britisk producent bragte os en build af præcis det omfang — et skræddersyet, SAP-integreret system til at erstatte regnearksstyret transportbåndsdrift — ville et traditionelt team have haft brug for de otte måneder. En AI Pod bestående af fire senior-specialister leverede MVP’en på tre, mens anlægget kørte på sine eksisterende SAP- og Google Sheets-data hele vejen igennem.
Det resultat kommer fra en anden måde at strukturere levering på, og denne artikel forklarer, hvordan det fungerer: hvad en AI Pod er, hvor hastigheden kommer fra, hvad det koster i forhold til et traditionelt team, og hvor modellen passer ind.
Hvad er AI Pod-modellen? En AI Pod er et kompakt leveringsteam på 3-5 senior-specialister, der arbejder med AI-agenter integreret gennem hele softwareudviklingens livscyklus. AI’en i softwareudvikling håndterer mængden — kodegenerering, testdækning, dokumentation, kravudkast — mens ingeniørerne ejer hver beslutning: arkitektur, gennemgang og ansvar for hver linje, der leveres. Teamet forbliver lille, så den koordineringsomkostning, der vokser med antallet af medarbejdere, aldrig opstår i første omgang.
For et dybere kig på, hvordan AI integreres på tværs af individuelle SDLC-faser, se vores guide til AI-drevet ingeniørarbejde på tværs af softwareudviklingens livscyklus.
- En AI-pod består af 3-5 seniorspecialister, der arbejder med AI-agenter gennem hele udviklingslivscyklussen. AI’en producerer mængden; ingeniørerne ejer beslutningerne.
- Hastigheden kommer fra at fjerne koordineringsomkostninger frem for at administrere dem. En Pod på fire personer leverede MVP på 3 måneder mod et traditionelt estimat på 8 måneder.
- Kvaliteten holder, fordi gennemgangen er strukturel. Hvert AI-genereret output gennemgår en seniorgennemgang, før det udgives, og den samme disciplin har båret en produktionsmigrering med 40 % over grundlinjehastigheden.
- Modellen passer til afgrænsede builds, MVP’er under deadline og moderniseringsarbejdsstrømme. Store virksomhedsprogrammer med flere arbejdsstrømme kræver stadig en anden struktur — og det siger vi højt.
Hvordan en AI Pod fungerer
En Pod er bevidst lille: 3-5 seniorspecialister, typisk en ledende arkitekt og ingeniører, hvis sammensætning afhænger af opgaven — backend, frontend, QA, data. Der er intet juniorlag at føre tilsyn med og ingen separat dokumentations- eller rapporteringsrolle, fordi det arbejde er flyttet til AI’en.
The AI-agenter opererer på tværs af alle leveringsfaser. Under afgrænsningen udarbejder de krav og grænsetilfælde ud fra kildemateriale, som lederen kan korrigere og godkende. Under opbygningen genererer de implementeringskode, producerer testdækning sideløbende og holder dokumentationen opdateret med kodebasen i stedet for bagefter. Under gennemgangen kører de en første analytisk gennemgang, så senior opmærksomhed går til designbeslutninger frem for syntaks.
Ingeniørerne udfører den del, der ikke kan uddelegeres. De træffer beslutningerne om arkitekturen, definerer hvad “færdigt” betyder for hvert stykke arbejde, gennemgår alt hvad AI’en producerer, og bærer ansvaret for hver eneste linje, der når produktion. Forholdet er pointen: et lille antal erfarne mennesker, der styrer en stor mængde genereret output, uden at noget bliver flettet uden gennemgang.
Fra dag til dag ændrer dette arbejdets form. En specialist tager en funktion fra krav til testet kode uden at overdrage den mellem tre roller, og den feedback-sløjfe, der før strakte sig over en sprint, lukker nu inden for en dag.
De skjulte omkostninger ved traditionelle ingeniørteams
Koordineringsomkostninger Dræber Leveringshastighed
Et ingeniørteam på ti personer producerer ikke ti gange så meget som én ingeniør. Det producerer noget tættere på tre eller fire gange, og forskellen er koordineringstab. Hver overdragelse mellem design, udvikling og QA skaber ventetid. Hver yderligere interessent i en kravdiskussion udvider overfladen for fejljustering. Hvert gennemgangslag tilføjer forsinkelse, før koden sendes.
Brooks’ lov beskriver denne dynamik i sin yderste konsekvens: at tilføje flere personer til et forsinket projekt gør det endnu mere forsinket. Den underliggende mekanisme er dog altid til stede i stor skala. Større teams koster ikke bare mere at bemande — de koster mere at koordinere, og den omkostning vokser hurtigere end produktionen gør.
Hvordan pyramidebemanding oppuster omkostningerne pr. funktion
Traditionelle leveranceteams er bygget som pyramider: en håndfuld senioringeniører i toppen, et bredere mellemniveau og en base af juniorer, der håndterer volumenarbejde under opsyn. Denne model gav mening, da seniortid var flaskehalsen, og juniorproduktion var det billige alternativ.
AI vender logikken om. Pyramidestrukturer med mange juniorer producerer mere kode, der skal gennemgås, flere fejl, der skal fanges, og mere kontekstskift for seniorer, som ender med at styre output i stedet for at lede arkitekturen. BCG’s 2026-forskning i AI-jobtransformation viser, at seniormedarbejdere under AI-adoption udvider deres ansvar og produktivitet, mens indgangsstillinger indskrænkes i omfang. Pyramidemodellen spreder omkostningerne ud over antallet af medarbejdere uden at fokusere på kvalitet, og økonomien bliver kun værre, efterhånden som AI-assisteret softwareudvikling bliver standarden.
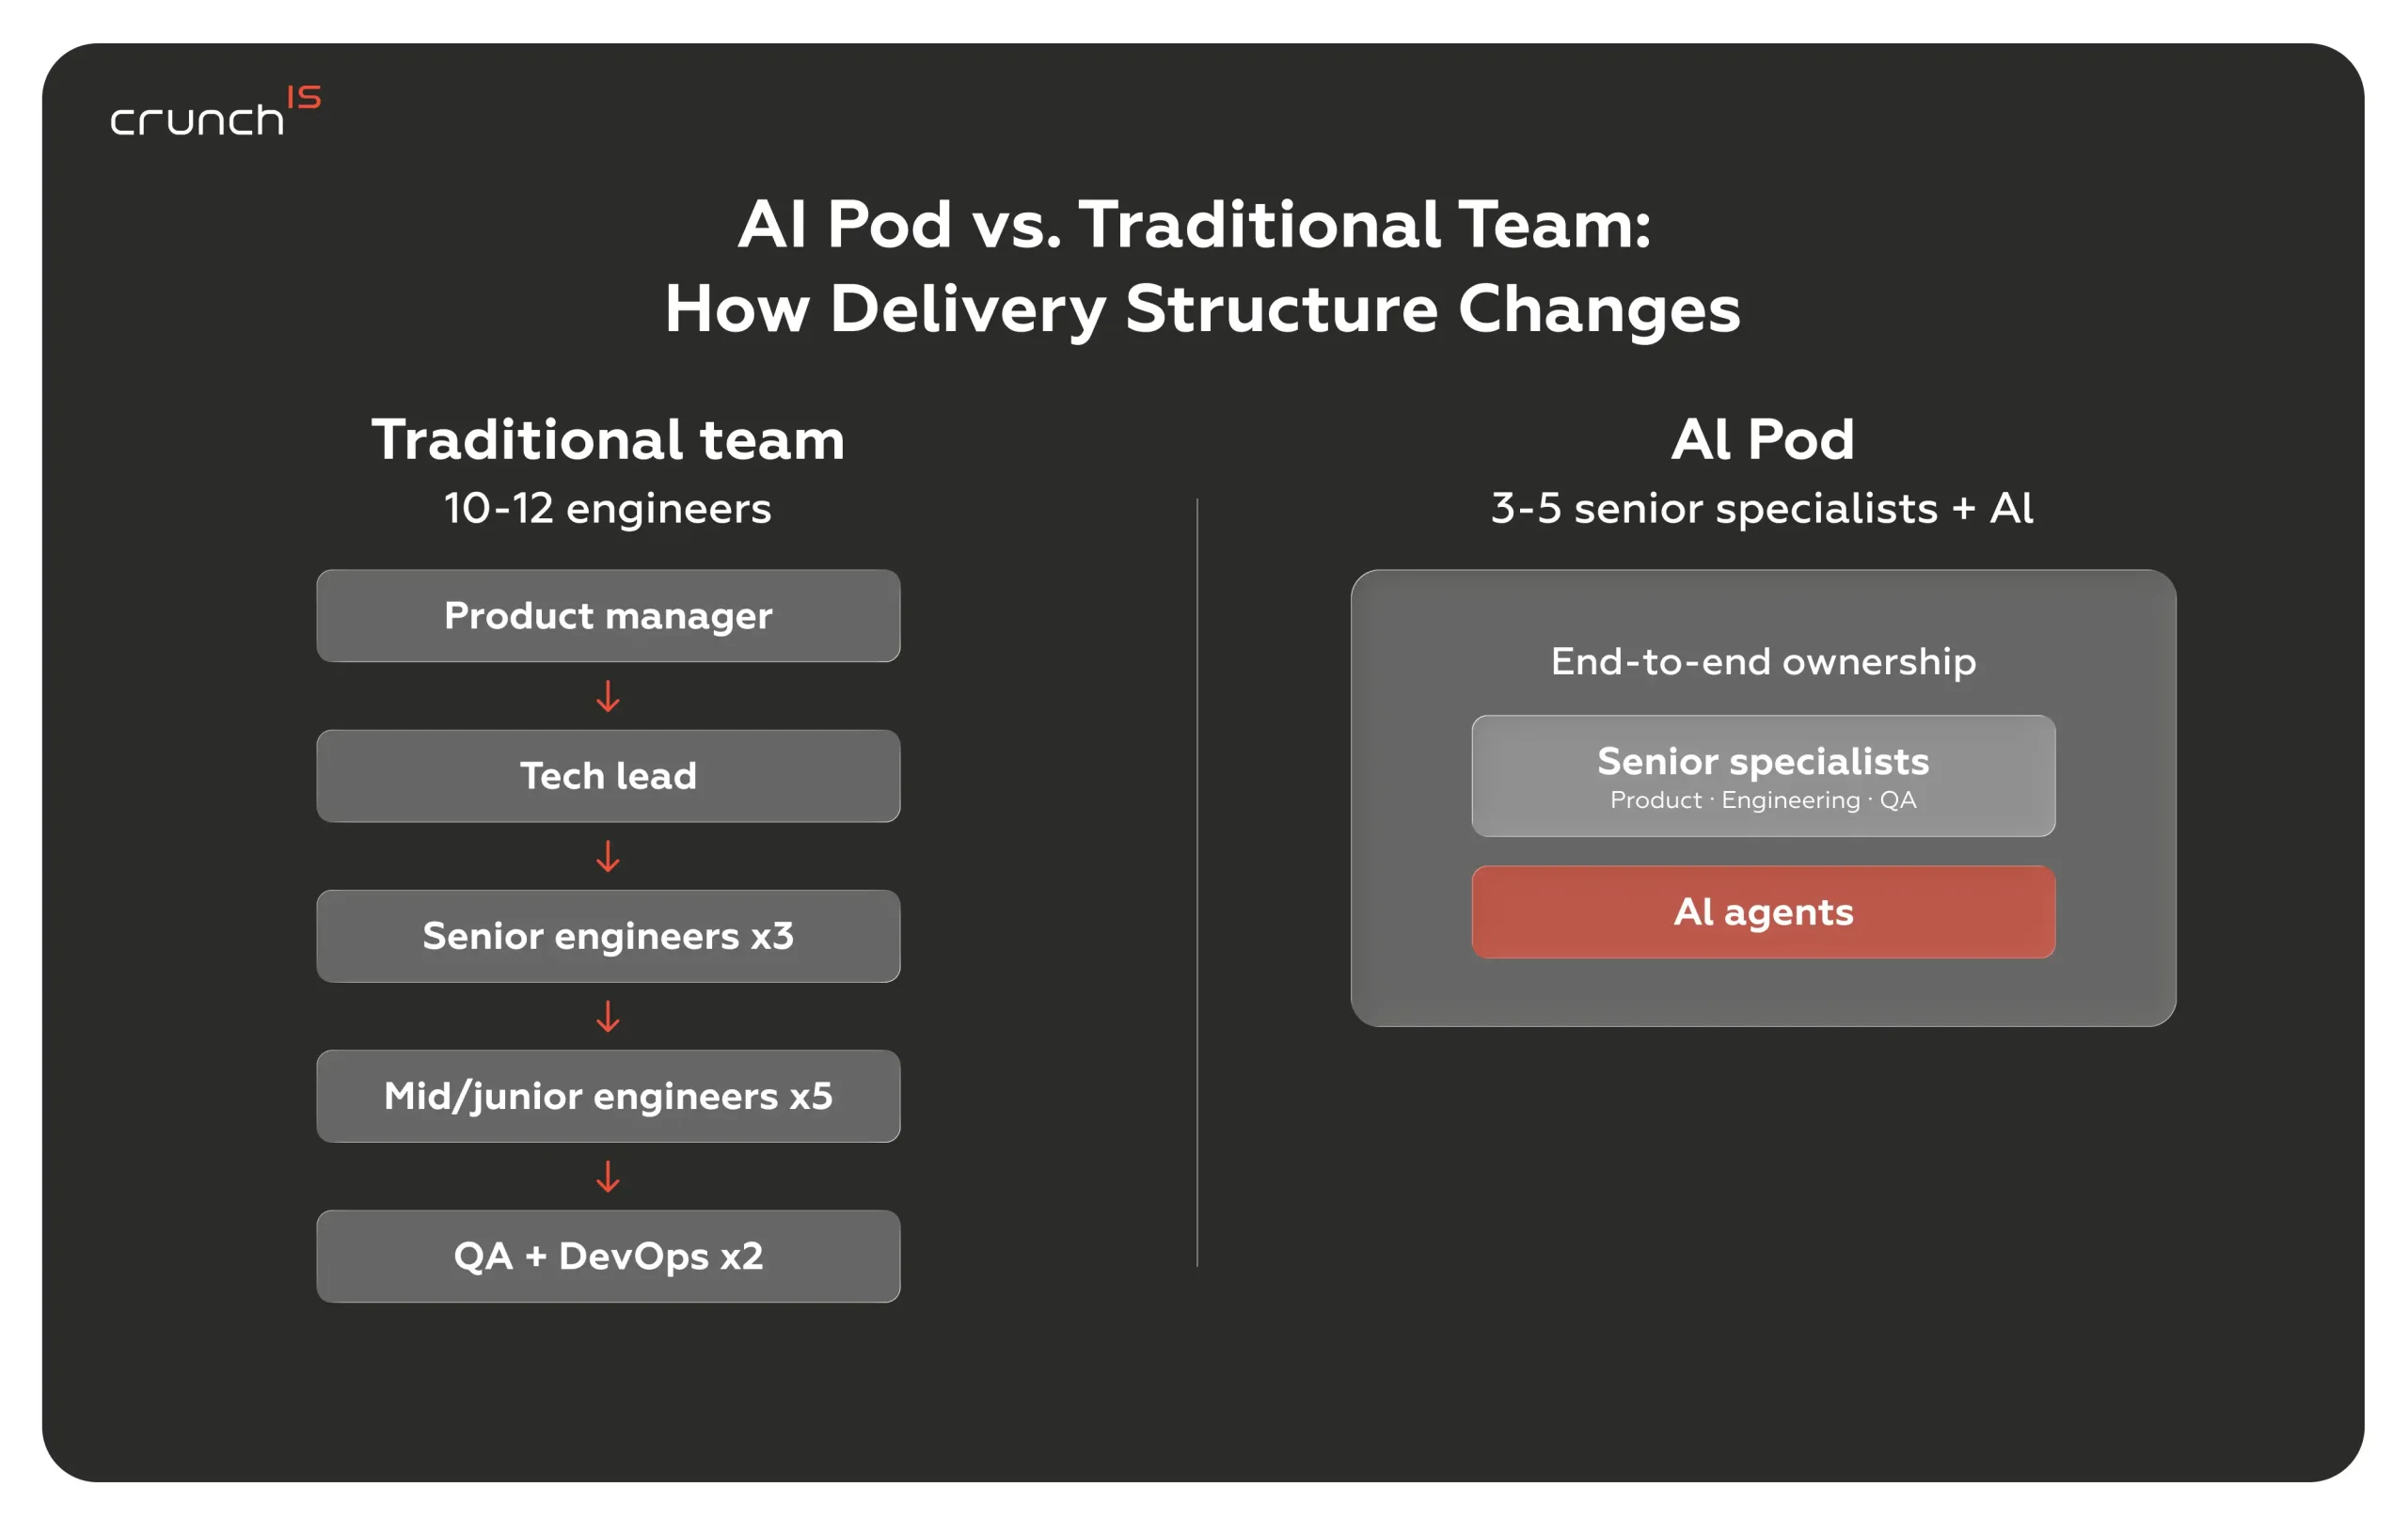
Sådan genbalancerer AI Pod-modellen leveringsøkonomien
En kompakt AI Pod — typisk 3-5 seniorspecialister med AI integreret på tværs af leveringsarbejdsgangen — producerer output, der tidligere krævede teams, der var dobbelt eller tre gange så store. BCG anslår, at AI-drevet augmentering af udviklere alene giver produktivitetsgevinster på 30-50%. McKinsey forskning, baseret på data fra over 600 organisationer, viste, at virksomheder, der opnår 80-100% AI-adoption på tværs af engineering, rapporterer gevinster på over 110%.
Det retningsmæssige skift er synligt i den måde, hvorpå førende organisationer omdesigner deres egne teams. I et McKinsey-webinar fra 2026 om virksomheders AI-transformation beskrev McKinsey senior partner Rob Levin den fremvoksende model som at “reducere to-pizza-teamet på omkring otte personer til to: en produktejer, der ved, hvordan godt ser ud, og en full-stack-ingeniør, der kan arbejde med kodeskrivende systemer, fejlfinde dem og indarbejde dem i arkitekturen.”
Kun-Senior Teams: Lavere Omkostning Per Resultat
AI Pods kører på en sammensætning kun bestående af seniorer — ikke fordi juniore ingeniører mangler værdi, men fordi AI nu håndterer den mængde arbejde, der retfærdiggjorde at ansætte dem: boilerplate, testgenerering, dokumentation og indledende kodeudkast. Det, der er tilbage på Pod-niveau, kræver dømmekraft.
Seniorteams koster mere pr. hoved, men mindre pr. resultat. Færre ingeniører betyder færre lønninger, færre onboarding-cyklusser, mindre administrativ overhead og en kortere vej fra krav til produktion. Omkostningsmodellen skifter fra at betale for kapacitet til at betale for levering.
Traditionelt Team vs. AI Pod: Hvad du betaler for
Kompromitterer AI-drevet udvikling kvaliteten?
Instinktet er at antage, at mindre teams producerer output af lavere kvalitet. Beviserne understøtter det ikke. I en kontrolleret undersøgelse foretaget af GitHub med 243 udviklere viste kode produceret med AI-assistance forbedringer i læsbarhed (3,6 %), pålidelighed (2,9 %) og vedligeholdelsesscorer sammenlignet med baselines udelukkende lavet af mennesker. Udviklere var også 5 % mere tilbøjelige til at godkende AI-assisteret kode i peer review.
Test, kodegennemgang og dokumentation sker løbende i en AI Pod — indbygget i arbejdsgangen, ikke planlagt til ugen før lancering. Fejl dukker op, når de er billige at rette, ikke efter de er blevet sendt i produktion. Når koden når produktion, har den været igennem mere granskning, end de fleste traditionelt bemandede teams kører i en hel sprint.
Dette har kommerciel betydning. Færre produktionsfejl betyder mindre omarbejde, færre hændelsesresponscyklusser og lavere samlede ejeromkostninger — gevinster, der akkumuleres med hver udgivelse.
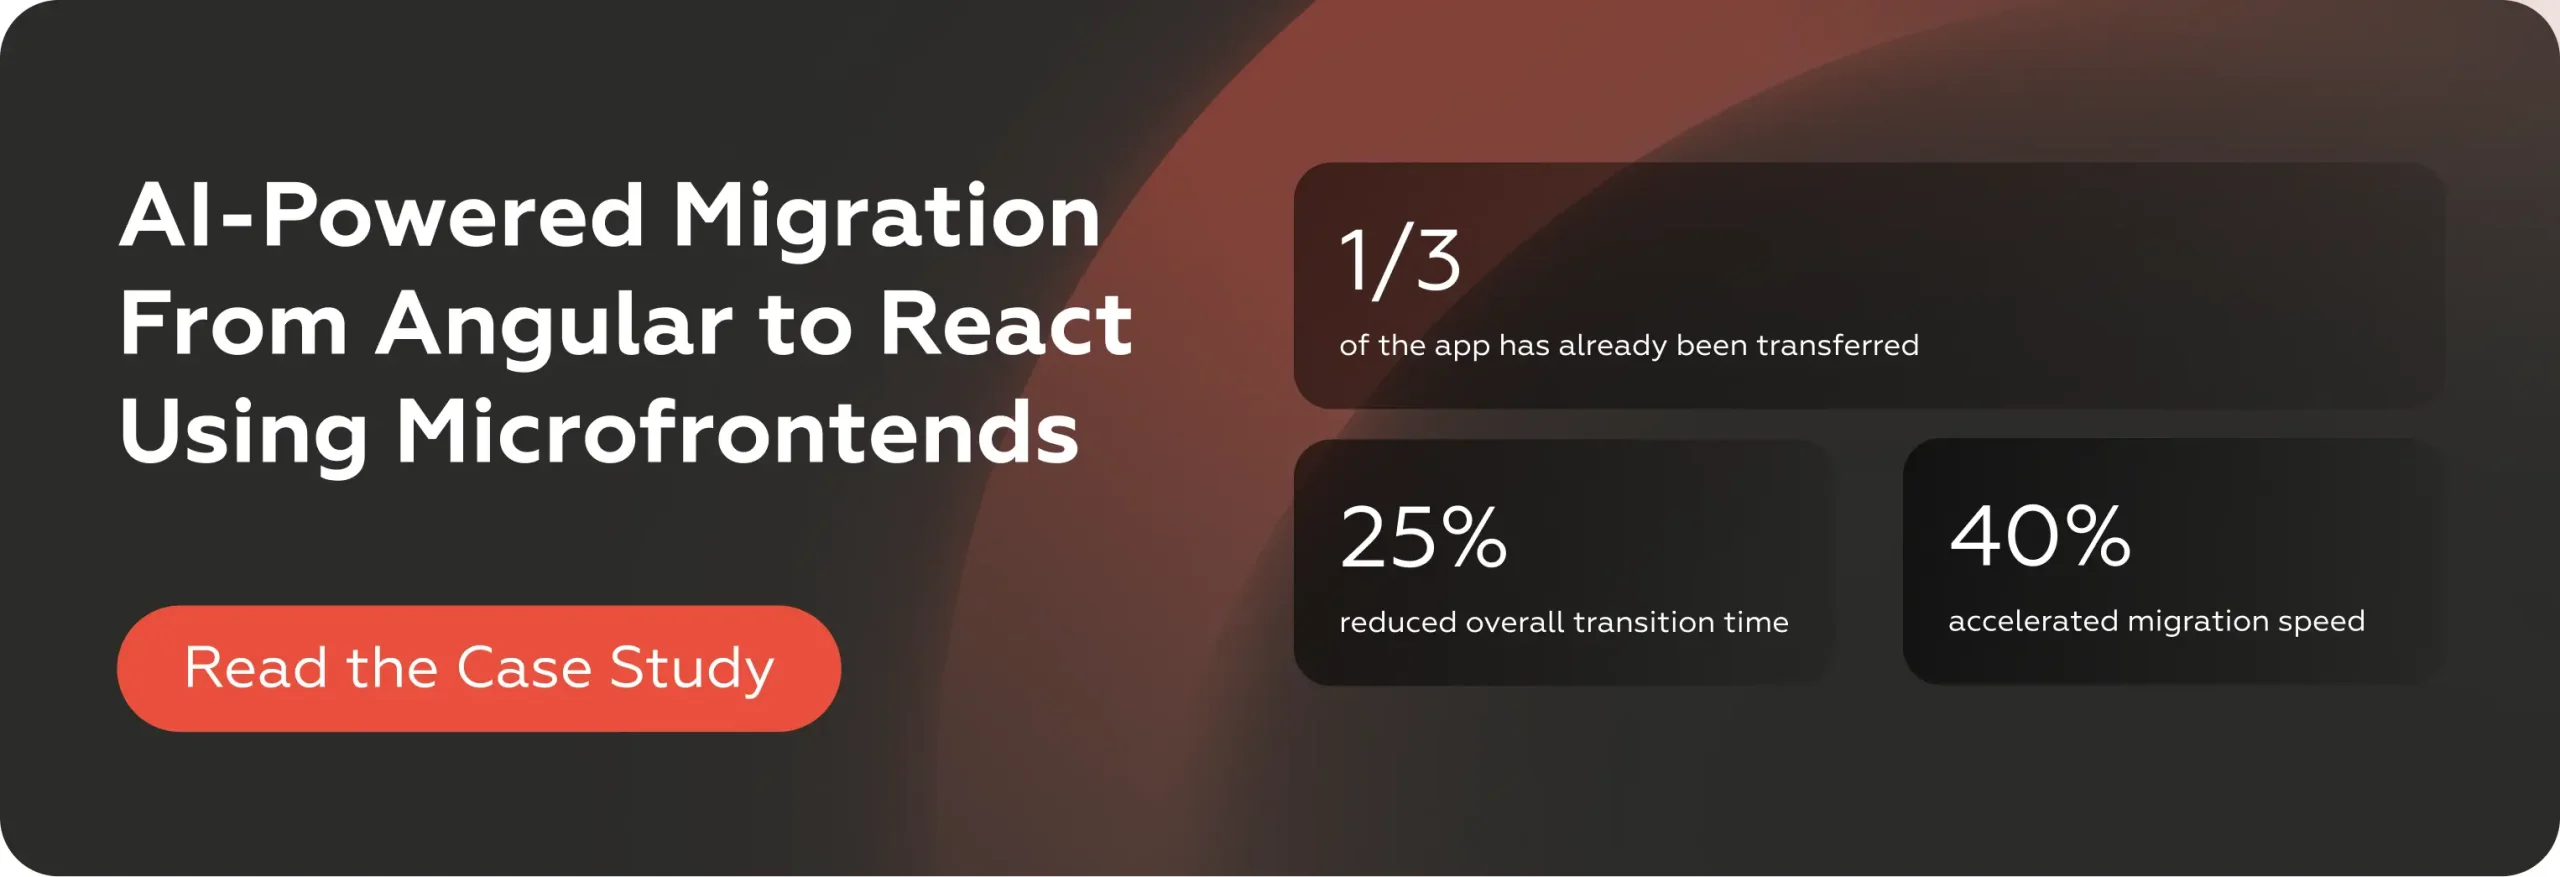
Vores eget bevispunkt kører i produktionsskala. I en live Angular-til-React-migrering af en produktionsapplikation flyttede Pod-tilgangen 1/3 af applikationen, mens den kørte 40 % hurtigere end projektets pre-AI-baseline — målt på den samme kodebase, det samme team, de samme standarder.
Hvor Modellen Passer — og Hvor Den Ikke Gør
The Pod model is strongest where scope is defined and the deadline is close: an MVP that has to reach the market, a system replacement that cannot pause operations, a modernization stream inside a larger platform, or a new product line the organization wants to build without expanding the org chart to do it.
Det er ikke svaret på alt. Et virksomhedsprogram med flere spor og omfattende interessenthåndtering på tværs af afdelinger kræver stadig en større struktur, og vi afgrænser det på den måde. At tilpasse leveringsmodellen til opgaven er en del af ingeniørarbejdet.
Konklusion
Mindre teams leverer hurtigere, når strukturen fjerner koordinering i stedet for at styre den. AI Pod-modellen gør netop det: seniorspecialister, der dirigerer AI-genereret volumen, med gennemgang indbygget i hvert trin og resultater målt i produktion — et tre-måneders MVP mod et otte-måneders estimat, en live-migrering, der kører 40% over baseline.