Computer vision-software gør det muligt for maskiner at fortolke og analysere visuelle data og omdanne billeder og video til handlingsrettede indsigter. Anvendelsen breder sig hurtigt på tværs af brancher: fra kvalitetskontrol i produktionen til realtidsovervågning og selvkørende køretøjer.
In this guide, you’ll learn what it takes to build a computer vision solution in 2025 – including system architecture, development timelines, tech stacks, hiring tips, cloud deployment strategies, and real-world costs.
Trin-for-trin softwareudviklingsproces for computersyn
At bygge et computervisionssystem er en pipeline i flere trin, der kræver præcision ved hvert eneste trin. Sådan udfolder processen sig typisk:
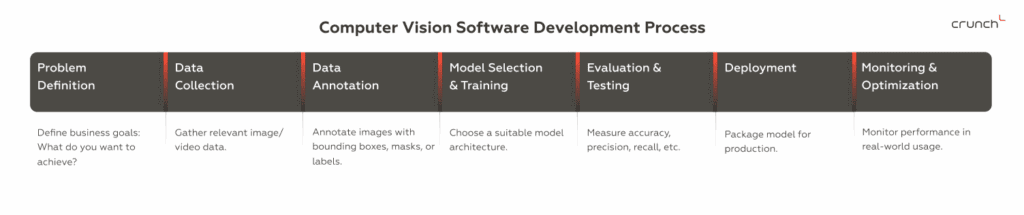
1. Problemdefinition
At klart definere forretningsproblemet og succeskriterierne, uanset om det handler om at opdage defekter på en produktionslinje eller genkende ansigter i sikkerhedsoptagelser.
2. Dataindsamling
Indsamling af relevante billed- eller videodatasæt af høj kvalitet, der er skræddersyet til din anvendelse. Dette kan omfatte offentlige datasæt, syntetiske data eller brugerdefineret billedoptagelse.
3. Dataannotering
Mærkning af dataene for at lære modellen, hvad den skal kigge efter. Dette kan involvere afgrænsningsbokse, segmenteringsmasker eller klassifikationsmærker ved hjælp af værktøjer som CVAT eller Label Studio.
4. Modelvalg & Træning
Valg af den rette arkitektur og træning af den. Dette trin omfatter ofte tuning af hyperparametre.
5. Evaluering & Test
Validerer modellens ydeevne og tester det på usete data for at undgå overfitting.
6. Udrulning
Exporting and integrating the model into a production environment. This could be in the cloud (AWS, GCP, Azure), on edge devices, or embedded systems. At this stage, MLOps becomes essential, ensuring smooth version control, continuous integration and deployment (CI/CD), performance monitoring, and scalability of your computer vision models in real-world applications.
7. Overvågning og optimering
Sporing af ydeevne i den virkelige verden, genoptræning med nye data om nødvendigt og optimering af latenstid, gennemløb eller nøjagtighed, efterhånden som brugen skaleres.
Detaljerede omkostningskomponenter for computer vision-software
At skabe og implementere skræddersyet computervisionssoftware indebærer en række indbyrdes forbundne omkostningsdrivere, der spænder over udvikling, data, infrastruktur og langsigtet vedligeholdelse. Disse omkostninger kan variere betydeligt afhængigt af projektets kompleksitet, det krævede nøjagtighedsniveau, og om løsningen bygges fra bunden eller udnytter eksisterende værktøjer og modeller.
Udviklingsomkostninger
Kernen udgøres af udviklingsomkostninger, som omfatter både at skrive koden til computer vision-modeller og at designe det bredere system (grænseflader, API’er, datapipelines og realtidsintegration). Anvendelse af forudtrænede modeller som YOLO eller ResNet kan reducere tid og udgifter, men brugerdefinerede modeller, der er skræddersyet til specifikke opgaver, kræver ofte yderligere ingeniørarbejde og eksperimentering, hvilket øger de samlede omkostninger. Desuden har beslutninger om, hvor systemet kører (i skyen, on-premise eller på kanten), store økonomiske konsekvenser i forhold til latenstid, skalerbarhed og hardwarebehov.
Data
En anden væsentlig omkostningskategori er data, som omfatter indsamling, rensning og annotering af visuelle datasæt. Data af høj kvalitet med etiketter er afgørende for at træne effektive modeller, og selvom åbne datasæt kan hjælpe, kræver de fleste applikationer tilpassede datasæt, der er indsamlet i specifikke miljøer. Annotering, især til komplekse opgaver som segmentering eller objektsporing, kan være tidskrævende og dyr. Generering af syntetiske data ved hjælp af 3D-miljøer eller simuleringer er et alternativ, selvom det kræver specialiserede værktøjer og ekspertise.
Infrastruktur og computerressourcer
Træning af vision-modeller i stor skala kræver kraftfulde GPU’er eller TPU’er, som ofte lejes fra cloud-udbydere såsom AWS, Google Cloud eller Azure. Cloud-platforme tilbyder fleksibel adgang efter behov til højtydende databehandling uden de indledende kapitalomkostninger ved at opbygge fysisk infrastruktur. Disse tjenester kan dog blive dyre over tid, især under langvarig modeltræning, hyppig batch-inferens eller kontinuerlig behandling af videostrømme.
Implementering af computersyn i skyen indebærer også tilvejebringelse af lagerplads til store datasæt, opsætning af skalerbare inferenspipelines og sikring af svar med lav latenstid til realtidsapplikationer. Organisationer anvender ofte containerisering (f.eks. Docker) og orkestreringsværktøjer (f.eks. Kubernetes) til at administrere implementeringer effektivt, mens hybride edge-cloud-arkitekturer bruges, når noget behandling skal foregå lokalt. Efterhånden som systemet modnes, bliver driftsværktøjer som MLOps platforme afgørende for at automatisere versionsstyring, A/B-test af modeller, overvågning for anomalier og udløsning af genoptræningsarbejdsgange.
Over tid skal organisationer også planlægge vedligeholdelse af modeller, tilpasse sig datadrift, håndtere ydelsesforringelse og opdatere systemer, så de opfylder skiftende forretningsmål. Den dynamiske natur i produktionsmiljøer betyder, at cloudbaserede systemer skal bygges til modstandsdygtighed, skalerbarhed og overholdelse af standarder for databeskyttelse, hvilket hver især tilføjer lag af kompleksitet og omkostninger.
Langtidsvedligeholdelse
Endelig er der løbende udgifter forbundet med softwarelicenser, SaaS-værktøjer, support og personale. Fra open source-frameworks til annoteringsplatforme på virksomhedsniveau og cloud-API’er kan licens- og abonnementsgebyrer hurtigt hobe sig op. Dygtige fagfolk (ML-ingeniører, softwareudviklere, dataannotatorer) er afgørende for både den indledende lancering og systemets udvikling, hvilket gør bemanding til en stor og tilbagevendende investering.
Computervisionssystemarkitektur: Hardware- og softwarestak
Bag ethvert succesfuldt computervisionssystem ligger en kombination af hardwarekomponenter og softwareværktøjer.
Hardwareessentials til computervision
De mest almindelige hardwarekomponenter, der bruges, omfatter:
- Grafikprocessorer (GPU’er) (afgørende for parallel behandling af billeder og acceleration af træning af neurale netværk)
- Edge-enheder (til realtidsbehandling ved kanten som kameraer, mobiltelefoner, robotter eller indlejrede systemer)
- Højtydende CPU’er & RAM. Billedforbehandling, dataforøgelse og nogle inferensopgaver er stadig afhængige af stærke CPU’er og tilstrækkelig hukommelse (især under batchoperationer).
- Kamera- & sensorsystemer
Computer Vision Software
Software er det, der driver kritiske funktioner som ansigtsgenkendelse, objektdetektion og billedklassificering. Uden det kan hardwarekomponenter som kameraer og chips ikke fungere effektivt.
Her er et kig på kernelagene i computer vision-softwarestakken:
- Programmeringssprog (Python, C++)
- Frameworks & Biblioteker (OpenCV, PyTorch / TensorFlow, Detectron2 / MMDetection, MediaPipe, Albumentations, ONNX Runtime)
- Værktøjer til modeltræning & -implementering (Weights & Biases, MLflow, NVIDIA TensorRT / OpenVINO, Docker & Kubernetes)
- Cloud & lagringstjenester:
- Til datalagring i stor skala og fjerntræning af modeller: AWS S3, GCP Cloud Storage, Azure Blob Storage
- Til modeltræning og udrulning:
- AWS EC2 (med GPU), Google Colab Pro, Azure ML Studio
- GCP Vertex AI (til administreret modeltræning, implementering og MLOps)
- (Valgfrit: AWS SageMaker til end-to-end machine learning, herunder computer vision)
- Til modelbetjening og skalerbar implementering: Docker & Kubernetes
Hvis du vil forstå, hvordan CV fungerer, eller er ivrig efter at udforske, hvordan forskellige sektorer bruger det i dag, så tjek vores tidligere artikel: Hvordan fungerer computervision? 6 anvendelser fra den virkelige verden fordelt på brancher.
Hvor lang tid tager udvikling af computer vision-software?
Et af de mest almindelige spørgsmål, vi hører fra virksomheder, der udforsker AI-løsninger, er: “Hvor lang tid vil det tage at bygge dette?” Men der findes ikke noget universelt svar. Udviklingstiden afhænger i høj grad af projektets kompleksitet, datatilgængelighed, implementeringsmetode og teamsammensætning.
Her er et groft tidslinjeestimat for et typisk CV-projekt:
- PoC: 2-4 måneder
- Enkel CV-app produktionsklar (som stregkodescanning, OCR, grundlæggende klassificering): 3-6 måneder
- Moderat CV-system klar til produktion (som ansigtsgenkendelse og objektgenkendelse): 6+ måneder
- Avanceret CV-løsning klar til produktion (brugerdefinerede modeller, sporing i realtid, 3D-syn): 12+ måneder

Hvor Meget Koster Det at Bygge Computer Vision-software?
Mange virksomheder tøver med at udforske computervisionsløsninger af frygt for uoverkommelige omkostninger. Er computervision dyrt? Med strategisk planlægning og de rette partnerskaber kan implementeringen af sådan teknologi være mere tilgængelig end forventet.
Som et eksempel vil vi dele en case om en fransk AI-startup, der samarbejdede med os om at forbedre deres autonome sikkerhedsrobot med ansigts- og persondetektion i realtid. Projektet integrerede med succes avancerede funktioner såsom portdetektion og rumlig bevidsthed. Den positive modtagelse på teknologikonferencen både validerede løsningen og tiltrak investorinteresse, hvilket demonstrerede projektets værdi og potentiale for skalerbarhed.
Estimeret omkostningsopdeling af et brugerdefineret computer vision-projekt:

It’s important to factor in cloud service expenses, which can vary significantly based on the amount of data processed, storage needs, and your choice of cloud provider.
I betragtning af projektets kompleksitet og integrationen af avancerede funktioner er de samlede omkostninger for udvikling af skræddersyet computer vision-software falder sandsynligvis inden for $100.000 til $350.000 intervallet. Men hvis du starter med et MVP, kan omkostningerne starte fra omkring $80.000.
At udvikle en funktionsrig mobilapplikation kan koste mellem $100.000 og $200.000. At ansætte en fuldtidsansat erfaren softwareudvikler i USA koster i gennemsnit omkring $120.000 årligt.
I betragtning af disse tal kan investering i skræddersyede computer vision-softwareløsninger være en omkostningseffektiv strategi, især når man tager højde for potentialet for automatisering, forbedret sikkerhed og driftseffektivitet.
Vil du implementere computervision uden at bruge for mange penge?
Vi har samlet en praktisk guide der sammenligner cloud-, edge- og indlejrede CV-arkitekturer, sammen med gennemprøvede tips til at reducere omkostninger for hver enkelt.
Ansættelse af en Computer Vision-ingeniør: Hvilke færdigheder kræves der til Computer Vision?
Når du opbygger et computer vision-team, har du brug for nogen med et stærkt greb om grundlæggende teknikker, et skarpt blik for modelydelse og evnen til at implementere løsninger i virkelige miljøer. Her er en oversigt over de kernekompetencer, du bør prioritere, når du beslutter dig for at ansætte computer vision-ingeniører:
Kerneprogrammering & Framework-kompetence
I hjertet af enhver computer vision-rolle ligger en robust programmeringsevne. Kandidaten skal være flydende i Python, C++, OpenCV og bekendt med TensorFlow eller PyTorch.
Deep Learning-ekspertise
Som vi allerede ved, drives moderne computer vision-opgaver i vid udstrækning af deep learning. Se efter kandidater med:
- en solid forståelse af Convolutional Neural Networks (CNNs) og deres arkitekturer
- praktisk erfaring med billedklassificering, billedsegmentering og objektdetekteringssoftware
- forståelse af transformer-baserede modeller
Grundlæggende om computervision
- Billedbehandlingsteknikker (filtrering, kantdetektering, støjreduktion)
- Dataaugmentering og forbehandling
- Feature extraction og matching (ved brug af teknikker som SIFT eller ORB)
- Eksponering for optisk flow, stereosyn og 3D-syn-applikationer
Data- og modelstyring
En effektiv CV-ingeniør ved, hvordan man omhyggeligt evaluerer modelydeevne, har ekspertise i modelevalueringsmetrikker og praktisk erfaring med datasætforberedelse. Derudover har vedkommende kendskab til annoteringsværktøjer som CVAT, Label Studio eller Roboflow.
Færdigheder i modeludrulning
Og selvfølgelig skal de også vide, hvordan man implementerer computer vision-modeller. Nogle vigtige færdigheder inkluderer:
- evnen til at eksportere og optimere modeller med formater som ONNX eller frameworks som TensorRT
- viden om edge computing til inferens på enheden
- oplevelse med at integrere modeller i applikationer
- og for at bygge skalerbar computervisionssoftware skal en ingeniør have færdigheder i at bruge cloud-platforme (AWS, Azure)
Bløde kompetencer
Og jeg vil kort nævne vigtigheden af bløde kompetencer. Tænk kritisk over, hvad dit team værdsætter mest: er det kommunikation? ejerskab? smidighed? Din arbejdspladskultur bør guide din endelige beslutning.
Har du brug for hjælp til at samle dit drømmehold inden for computer vision? Hvis du søger en erfaren partner, kan vores team støtte dig med eksperttalent eller end-to-end-udvikling. Book et gratis konsultationsopkald for at ansætte computer vision-eksperter.
Konklusion
Computer vision er en aktiv drivkraft for innovation på tværs af næsten alle brancher. Men at bygge en succesfuld computer vision-løsning i 2025 kræver den rette blanding af strategi, talent, infrastruktur og udførelse.
Whether you’re a startup founder planning your first MVP or an enterprise leader looking to automate visual tasks at scale, knowing what goes into these systems is key to setting realistic expectations and avoiding costly missteps.
Med vores gennemprøvede erfaring og skræddersyede tilgang til levering af tilpassede computer vision-udviklingstjenester kan din virksomhed udnytte kraften i visuel intelligens.
Kontakt os i dag for et personligt projektestimat.