
Computer Vision wird zunehmend in Arbeitsprozessen verschiedener Branchen eingesetzt. Die Entwicklung und Implementierung von KI-gestützten Bildverarbeitungssystemen kann jedoch kostspielig sein. Zwar ist die Modellentwicklung dank vorgefertigter Architekturen und Open-Source-Bibliotheken leichter zugänglich geworden, doch die eigentliche Kostenherausforderung liegt oft in der Implementierung. Entscheidungen über Hosting, Inferenz, Speicherung und Infrastruktur können Ihren langfristigen ROI erheblich beeinflussen.
In diesem Artikel werden wir untersuchen, wie sich die verschiedenen Bereitstellungsstrategien (Cloud-basiert, On-Edge und eingebettet) auf Kosten und Leistung auswirken. Sie erfahren, woher die Kosten kommen, welche Architektur für Ihren Anwendungsfall geeignet ist und wie Sie klügere Entscheidungen treffen können, um Ihr Budget für Computer Vision im Rahmen zu halten.
- Die Bereitstellungsarchitektur ist der entscheidende Kostenfaktor im Bereich Computer Vision, wobei Hosting, Inferenz, Datenübertragung und Wartung den langfristigen ROI bestimmen.
- Cloud-basierte Bildverarbeitung bietet unübertroffene Skalierbarkeit und schnelle Iterationen, doch eine unkontrollierte GPU-Nutzung, kontinuierliches Videostreaming und wachsende Speicheranforderungen können die Betriebskosten schnell in die Höhe treiben.
- Durch den Einsatz am Netzwerkrand verlagern sich die Kosten von laufenden Cloud-Ausgaben hin zu einmaligen Hardware-Investitionen, was geringere Latenzzeiten, mehr Datenschutz und langfristig planbare Kosten für Echtzeit-Anwendungsfälle ermöglicht.
- Embedded Computer Vision erzielt bei großem Maßstab die niedrigsten Stückkosten, indem hochoptimierte Modelle auf Hardware mit extrem geringem Stromverbrauch ausgeführt werden (unterstützt jedoch nur eng gefasste, aufgabenspezifische Workloads).
- Hybride Architekturen sind zunehmend leistungsfähiger als reine Edge-Lösungen, da sie die Echtzeit-Inferenz auf Edge- oder eingebetteten Geräten belassen, während Training, Analyse und Überwachung in der Cloud zentralisiert werden.
- Eine spürbare Kostensenkung lässt sich erzielen, indem man die Anforderungen an Latenz, Datenschutz und Leistung mit dem einfachsten praktikablen Bereitstellungsmodell in Einklang bringt.
Was treibt die Kosten für Computer Vision an?
Die Gesamtkosten für die Entwicklung und den Betrieb eines Computer Vision Systems setzen sich aus vier Hauptbereichen zusammen: Entwicklung, Daten, Infrastruktur und langfristige Wartung.
- Der Entwicklungsprozess umfasst die Erstellung von maßgeschneidertem Code, die Schulung von Modellen und die nahtlose Integration von CV in bestehende Systeme.
- Datenkosten entstehen durch das Sammeln und Beschriften von visuellen Datensätzen, insbesondere wenn die Genauigkeit benutzerdefinierte, domänenspezifische Daten erfordert.
- Die Infrastruktur umfasst die notwendigen Rechenkapazitäten und Speicherkapazitäten, die zum Trainieren und Bereitstellen von Modellen erforderlich sind, sei es in der Cloud oder auf dem Gerät.
- Die Wartung umfasst laufende Aktualisierungen, Überwachung, MLOps-Workflows und die Sicherstellung, dass das Team die Kapazität hat, das System langfristig zu unterstützen.
Jede dieser Komponenten lässt sich unterschiedlich skalieren, je nachdem, wie und wo Sie Ihre Modelle einsetzen, insbesondere wenn Sie sich zwischen Edge-Geräten und Cloud-basierten Inferenzen entscheiden.
Eine vollständige Aufschlüsselung der einzelnen Kostenkategorien finden Sie in unserem ausführlichen Leitfaden: Der Leitfaden 2025 zur Entwicklung von Computer Vision: Kosten, Prozess & Technologie-Stack
Wie wählt man den richtigen Ansatz für die Bereitstellung von Computer Vision: Cloud, Edge oder eingebettet?
Beim Einsatz von Computer Vision kann die von Ihnen gewählte Architektur (Cloud, Edge oder Embedded) die Leistung, Skalierbarkeit und Kostenstruktur erheblich beeinflussen.
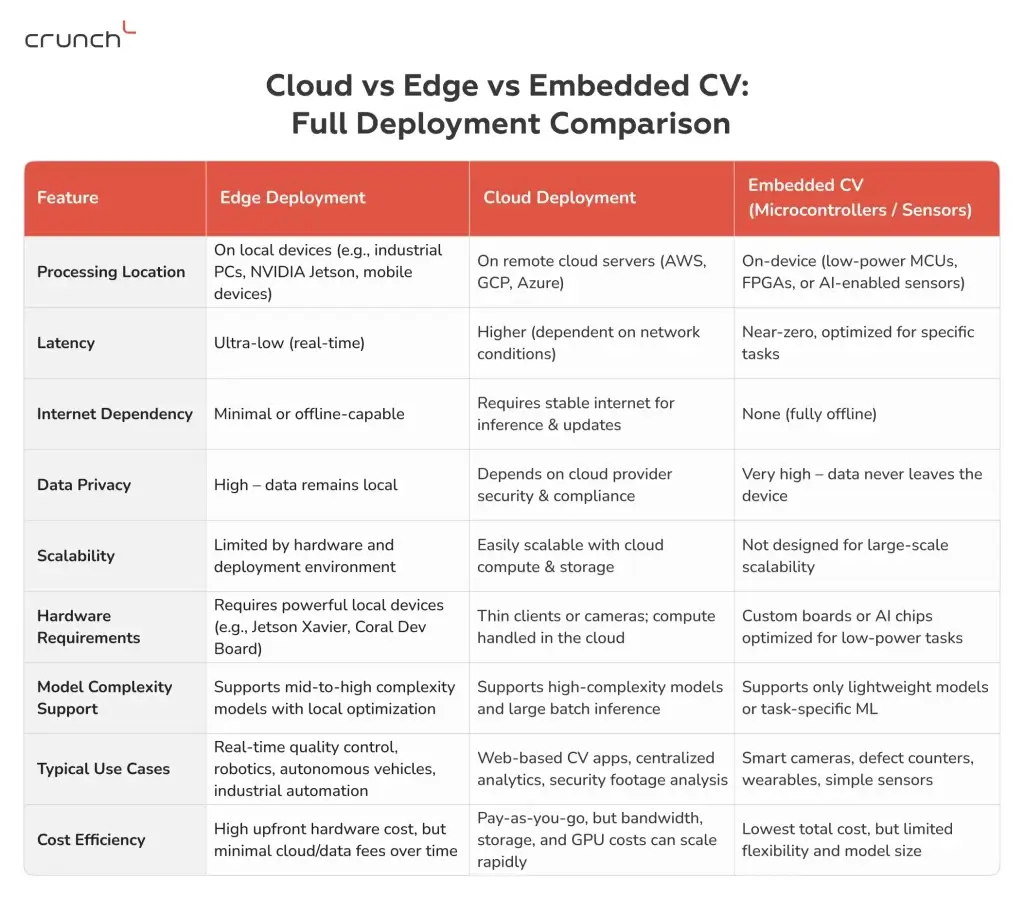
Cloud-basierte Computer Vision ist oft die erste Wahl für Unternehmen, die Skalierbarkeit und einfache Integration suchen. Sie können hochkomplexe Modelle trainieren und bereitstellen, auf praktisch unbegrenzten Speicher und Rechenleistung zugreifen und verwaltete Dienste nutzen. Diese Vorteile haben jedoch ihren Preis: Abrechnungsmodelle, die nach dem Prinzip „pay-as-you-go“ funktionieren, können bei wachsendem Datenvolumen schnell skalieren, insbesondere bei kontinuierlichem Videostreaming, GPU-Inferenzzeit und Speicherplatz.
Bei der Edge-Bereitstellung hingegen werden die Modelle direkt auf lokalen Geräten ausgeführt. Die anfänglichen Hardwarekosten sind zwar beträchtlich, aber es handelt sich um eine langfristige Investition, die sich aufgrund der geringen Latenzzeit und der minimalen laufenden Datenübertragungsgebühren auszahlt. Diese Architektur eignet sich gut für CV-Anwendungen in Echtzeit, z. B. für die Qualitätskontrolle in einer Produktionslinie oder die autonome Navigation.
Eingebettete Bildverarbeitungssysteme (die oft auf Mikrocontrollern oder spezialisierten KI-Chips laufen) sind auf lange Sicht am kosteneffizientesten. Diese Systeme sind für bestimmte Aufgaben konzipiert und unterliegen strengen Beschränkungen in Bezug auf Leistung, Speicher und Modellgröße. Sie eignen sich zwar nicht für komplexe Arbeitslasten, sind aber ideal für einfache, kostengünstige Aufgaben mit hohem Volumen, wie das Zählen von Objekten, die Erkennung einfacher Defekte oder das Scannen von Barcodes. Es fallen keine Cloud-Gebühren an, es besteht keine Konnektivitätsabhängigkeit und die Latenzzeit ist nahezu null.
Jeder Ansatz bietet Kompromisse bei Flexibilität, Leistung und Kosteneffizienz. Aus diesem Grund verwenden viele moderne Systeme eine hybride Architektur, bei der einfache Aufgaben vor Ort oder auf eingebetteten Geräten erledigt werden, während umfangreiche Schulungen und Analysen in der Cloud stattfinden.
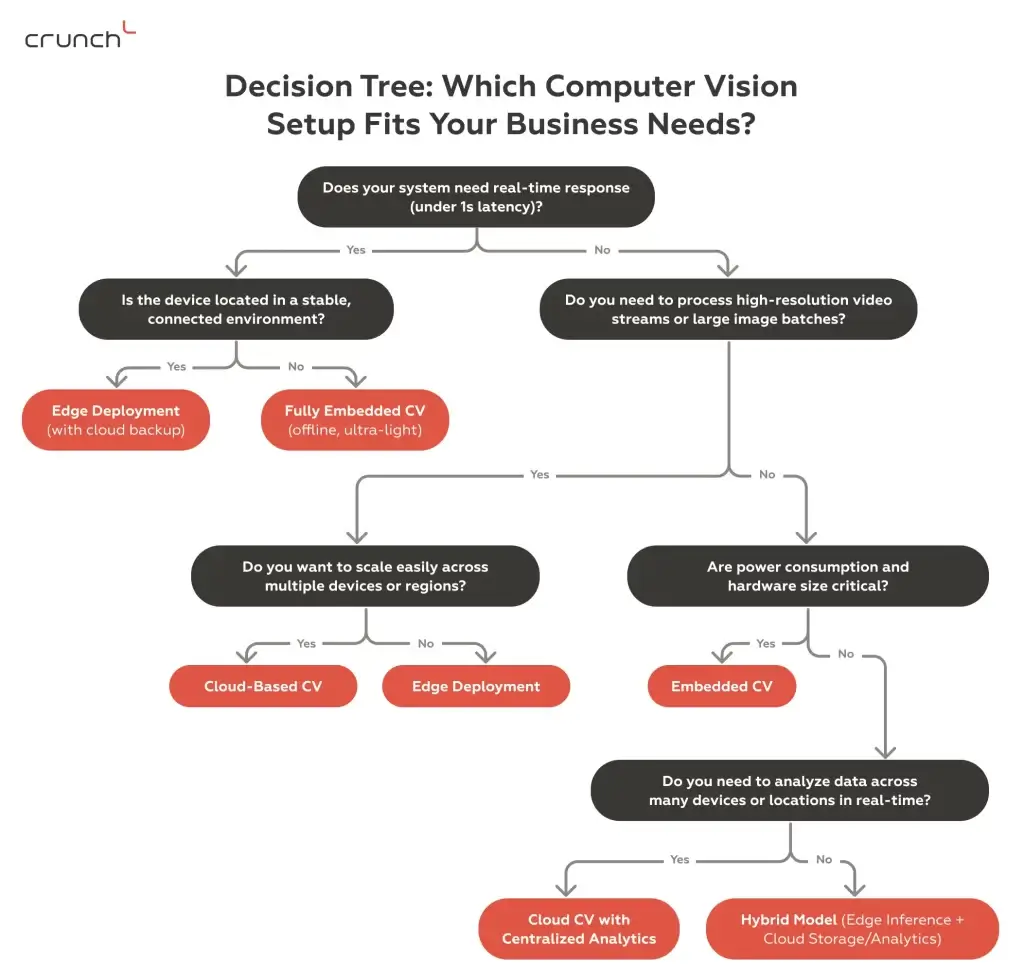
Verwenden Sie dieses Flussdiagramm, um die am besten geeignete Bereitstellungsarchitektur (Cloud, Edge oder Embedded) auf der Grundlage von Latenz, Stromverbrauch, Datenschutz, Skalierung und Anwendungsfällen zu bestimmen.
Cloud-basierte Computer Vision: AWS, GCP, Azure
Der Einsatz von Cloud-basierter Computer Vision bedeutet, dass Sie Ihre KI-Modelle wie Bilderkennung, Objekterkennung oder Videoanalyse auf entfernten Cloud-Servern statt auf lokalen Geräten ausführen. Dabei werden visuelle Daten an die Cloud gesendet, wo leistungsstarke GPUs oder TPUs die Daten verarbeiten und Erkenntnisse, Vorhersagen oder Warnungen zurückgeben.
Im Folgenden finden Sie eine Übersicht darüber, wie Computer-Vision-Systeme in der Regel auf den wichtigsten Cloud-Plattformen wie Amazon Web Services (AWS), Google Cloud Platform (GCP) und Microsoft Azure bereitgestellt werden:
AWS für die Bereitstellung von Computer Vision
Benutzerdefinierte Modelle werden in der Regel mit GPU-gesteuerten EC2-Instanzen oder Amazon SageMaker trainiert und dann als skalierbare Endpunkte über SageMaker bereitgestellt oder mit ECS/EKS containerisiert. Modellartefakte und Datensätze werden in S3 gespeichert. Für Bild- oder Videoströme in Echtzeit können Rekognition oder Kinesis in hybriden Setups neben Ihren eigenen Modellen verwendet werden.
Google Cloud für Computer Vision Anwendungen
Mit Vertex AI können Entwickler Computer-Vision-Modelle mit einer vollständig verwalteten Infrastruktur trainieren, feinabstimmen und bereitstellen. Die Modelle werden über Endpunkte bereitgestellt und über REST-APIs in Anwendungen integriert. Google Cloud Storage wird in der Regel zum Speichern von Bilddaten verwendet. CV-Modelle können auch mit vorgefertigten Tools, wie der Cloud Vision API, kombiniert werden, wenn nur eine teilweise Anpassung erforderlich ist.
Azure für benutzerdefinierte Vision-Workloads
Azure unterstützt die Bereitstellung von benutzerdefinierten Computer-Vision-Modellen mit Azure Machine Learning und Kubernetes Service. Modelle werden entweder in Jupyter-basiertem ML Studio oder in Docker-Containern trainiert und in Blob Storage gespeichert. Die Inferenz kann in der Cloud oder auf Edge-Geräten mit Azure IoT Edge und ONNX Runtime erfolgen.
Die Wahl der richtigen Cloud hängt von den Latenzanforderungen Ihres Projekts, dem Budget und der Bereitstellungsstrategie (zentralisiert oder Edge) ab.
Cloud-basierte Computer Vision bietet mehrere entscheidende Vorteile. Erstens können Sie dank der hohen Skalierbarkeit große Datensätze verarbeiten und viele Benutzer problemlos bedienen. Zweitens unterstützt sie sofortige Updates, so dass Modelle und Funktionen ohne Hardwareänderungen eingeführt werden können. Außerdem ist es durch den Fernzugriff ideal für globale Teams und die nahtlose Integration mit anderen Cloud-Tools steigert die Effizienz der Automatisierung insgesamt.
Wenn Sie erfahren möchten, wie wir mit einem Cloud-basierten Computer Vision-Projekt eine Personenerkennung von über 95% und eine Gesichtserkennungsgenauigkeit von 98% erreicht haben, lesen Sie bitte unsere vollständige Erfolgsgeschichte.
Tipps zur Kostenoptimierung für Cloud-basierte Computer Vision
Cloud CV bietet zwar erhebliche Flexibilität, kann aber auch erhebliche Kosten verursachen, wenn es nicht richtig optimiert wird. Im Folgenden finden Sie einige Empfehlungen zur Verbesserung der Kosteneffizienz:
1. Verwenden Sie Spot-Instanzen oder preemptible VMs
Plattformen wie AWS und GCP bieten für nicht kritische Aufgaben wie Modelltraining oder Batch-Verarbeitung stark vergünstigte Rechenleistungen an.
2. Daten auf der Client-Seite vorverarbeiten
Schneiden Sie Bilder vor dem Hochladen zu, ändern Sie die Größe oder komprimieren Sie sie, um die Kosten für die Datenübertragung und die Speichernutzung zu reduzieren.
3. Verwenden Sie Serverless & On-Demand-Inferenz
Anstatt GPUs rund um die Uhr laufen zu lassen, verwenden Sie serverlose Endpunkte (wie AWS Lambda oder den Prediction Service von Vertex AI), die nur bei Bedarf aktiviert werden.
4. Alte Daten archivieren
Verschieben Sie selten genutzte Bild-/Videodateien in den kalten Speicher, um langfristig Kosten zu sparen.
Was ist die On-Edge-Computer-Vision-Entwicklung?
Bei der Edge-Bereitstellung wird das Computer-Vision-Modell direkt auf lokalen Geräten wie Kameras, Industrierobotern, Drohnen oder IoT-Geräten platziert. Anstatt visuelle Daten an einen zentralen Server zu senden, wird die Inferenz in Echtzeit (direkt an der Quelle) durchgeführt.
Dieser Ansatz ist besonders wertvoll, wenn extrem niedrige Latenzzeiten, begrenzte Konnektivität oder der Datenschutz entscheidend sind. Anwendungsfälle wie autonome Fahrzeuge, industrielle Sicherheitsüberwachung und mobile Robotik können es sich oft nicht leisten, auf Antworten aus der Cloud zu warten.
Kantenbasierte Computer Vision ist die ideale Wahl, wenn:
- Echtzeit-Entscheidungen sind erforderlich (sofortiges Anhalten einer Maschine, wenn ein Fehler entdeckt wird)
- Die Konnektivität ist unzuverlässig oder teuer (in abgelegenen Fabriken, auf Bohrinseln oder in der Landwirtschaft)
- Datenschutzbestimmungen schränken die Cloud-Nutzung ein (Gesundheitswesen oder Verteidigungseinrichtungen)
Trotz seiner langfristigen Vorteile ist der Einstieg in die Edge-Computer Vision mit einigen Herausforderungen verbunden:
1) Spezialisierte Hardware. Die lokale Ausführung von KI-Modellen erfordert kompakte und dennoch leistungsstarke Geräte wie den NVIDIA Jetson Nano/Xavier oder die Google Coral Edge TPU. Diese Edge-Beschleuniger bieten GPU-ähnliche Leistung in kleinen Formfaktoren, aber die Hardware selbst treibt die Kosten in die Höhe, insbesondere bei einer Skalierung auf Hunderte oder Tausende von Einheiten.
2) Overhead bei der Modelloptimierung. Nicht alle CV-Modelle können auf Edge-Hardware von Anfang an effizient ausgeführt werden. Um Speicher-, Energie- und Latenzbeschränkungen einzuhalten, müssen Entwickler oft Modelle quantisieren, unnötige Schichten oder Neuronen entfernen und in Formate wie TensorRT, ONNX oder TFLite konvertieren.
Tipps zur Kostenoptimierung für Edge Computer Vision
Um die Gesamtbetriebskosten für Edge-basierte CV-Systeme zu senken, sollten Sie sich auf intelligente Kompromisse zwischen Leistung, Stromverbrauch und Funktionalität konzentrieren:
Verwenden Sie leichtgewichtige Modelle
Um die Effizienz zu optimieren und den Rechenaufwand zu verringern, sollten Sie den Einsatz effizienter Architekturen wie MobileNet oder YOLO-Nano in Betracht ziehen, die auf kostengünstigeren Edge-Geräten laufen können.
Modell-Optimierungstechniken anwenden
Es ist möglich, die Modellgröße und den Stromverbrauch erheblich zu reduzieren und gleichzeitig Kompromisse bei der Genauigkeit einzugehen, indem Techniken wie Quantisierung und Pruning eingesetzt werden.
Wählen Sie die richtige Hardware-Ebene
Es ist wichtig, dass Sie die Hardware auf Ihre tatsächlichen Leistungsanforderungen abstimmen. Es ist ratsam zu überlegen, ob die Investition in leistungsstärkere Geräte notwendig ist, da kleinere Boards wie der Jetson Nano oder Coral für die anstehende Aufgabe ausreichen können.
Funktionalität auf dem Gerät einschränken
Behalten Sie nur kritische Inferenzaufgaben auf dem Gerät. Entlasten Sie nicht benötigte Arbeitslasten (z.B. Protokollierung, Berichterstattung), um den Speicher- und Verarbeitungsbedarf zu reduzieren.
Was ist Embedded Computer Vision Deployment?
Eingebettete Computer Vision ist die ressourceneffizienteste Art, visuelle Intelligenz zu betreiben. Sie führt Inferenzen direkt auf Mikrocontrollern oder Chips mit extrem niedrigem Stromverbrauch durch, die in Geräte wie intelligente Schlösser, Barcode-Scanner und bewegungsaktivierte Sicherheitskameras integriert sind.
Dieser Ansatz unterscheidet sich von der herkömmlichen Implementierung von Edge Computing. Es handelt sich um eine Technologie, mit der Modelle für maschinelles Lernen komprimiert und für Geräte mit begrenztem Arbeitsspeicher und begrenzter Rechenleistung optimiert werden können (TinyML).
Eingebettete Bildverarbeitungssysteme sind ideal für die folgenden Situationen:
- Der Stromverbrauch muss auf ein absolutes Minimum reduziert werden.
- Diese Geräte sind so konzipiert, dass sie sowohl im Offline- als auch im Fernbetrieb funktionieren.
- Es ist nur eine einfache visuelle Analyse erforderlich, z. B. das Erkennen einer einfachen Form oder eines Musters.
- Cloud-Kommunikation in Echtzeit ist weder möglich noch notwendig
Aber ein eingebetteter Lebenslaufist nicht für jeden Anwendungsfallgeeignet. Er tauscht Tiefe gegen Effizienz:
- Kann keine großen oder tiefen neuronalen Netzwerke ausführen
- Begrenzt auf einfache Klassifizierung oder regelbasierte Sehaufgaben
- Probleme mit variabler Beleuchtung, Bewegungsunschärfe oder komplexen Hintergründen
- Erfordert stark optimierte Modelle, oft in Formaten wie TFLite Micro oder CMSIS-NN
Kurz gesagt, eingebettete Bildverarbeitung eignet sich gut für Anwendungen, die ein Minimum an Intelligenz in großem Maßstab erfordern, bei geringen Kosten und niedrigem Energieverbrauch.
Tipps zur Kostenoptimierung für eingebettete Computer Vision
Um eingebettete Computer Vision Lösungen kosteneffektiv und nachhaltig zu machen, ist es entscheidend, jedes Element zu optimieren:
TinyML-Frameworks nutzen
Um ultraleichte Modelle auf minimaler Hardware auszuführen, verwenden Sie optimierte Frameworks wie TensorFlow Lite für Mikrocontroller oder Edge Impulse.
Design für eine Einzweckaufgabe
Um die Effizienz zu optimieren und den Ressourcenverbrauch zu minimieren, ist es wichtig, eine eng fokussierte Bildverarbeitungsaufgabe beizubehalten, wie z.B. das Lesen von Barcodes oder die Formerkennung. Dieser Ansatz vereinfacht das Modell, reduziert den Speicherbedarf und senkt den Stromverbrauch.
Wählen Sie Ultra-Low-Power-Hardware
Wählen Sie MCUs mit integrierter Bildverarbeitungsunterstützung, die ausreichend Rechenleistung für die Inferenz bieten und gleichzeitig einen minimalen Energieverbrauch aufweisen.
Optimieren Sie Datenfluss und Speicherung
Es ist wichtig, dass Sie eine übermäßige Pufferung oder Protokollierung vermeiden. Bitte beachten Sie, dass die Bilder im Stream verarbeitet und nur die wichtigsten Metadaten oder Ereignisse gespeichert werden. Dies hilft, Speicherplatz zu sparen und die Lebensdauer des Geräts zu verlängern.
Für welche Art von Computer Vision sollten Sie sich im Jahr 2025 entscheiden?
Im Jahr 2025 werden hybride Architekturen an Bedeutung gewinnen, indem sie die Echtzeit-Reaktionsfähigkeit des Edge Computing mit der Leistung und Skalierbarkeit der Cloud-Infrastruktur verbinden.
Moderne CV-Lösungen bevorzugen zunehmend hybride Bereitstellungsmodelle:
- Die Inferenz wird an der Schnittstelle (intelligente Kameras, Industrieroboter) durchgeführt, um eine extrem niedrige Latenzzeit zu gewährleisten.
- Die Daten werden sicher in die Cloud übertragen, wo sie zentral gespeichert, umgeschult, analysiert und auf dem Dashboard angezeigt werden.
Diese Kombination bietet das Beste aus beiden Welten: schnelle, lokale Entscheidungen und langfristige strategische Erkenntnisse bei gleichzeitiger Senkung der Cloud-Kosten für bandbreitenintensive Workloads wie Videostreams.
Welche Art von Computer Vision Architektur passt am besten zu Ihrem Unternehmen?
- Cloud-basiertes CV ist ideal für Unternehmen, die große Datenmengen verarbeiten, komplexe Analysen durchführen oder schnell über mehrere Standorte hinweg skalieren müssen. Es wird häufig von SaaS-Plattformen für Unternehmen, Anbietern von Einzelhandelsanalysen und Herstellern mit mehreren Standorten gewählt.
- Edge CV eignet sich gut für Branchen, in denen Entscheidungen in Echtzeit getroffen werden müssen und ein hohes Maß an Datenschutz erforderlich ist, z. B. in der Automobilindustrie, im Gesundheitswesen und in intelligenten Fabriken. Es funktioniert am besten, wenn eine Infrastruktur vor Ort vorhanden ist (Strom und Rechenleistung), die Internetverbindung jedoch unterbrochen ist oder Latenzzeiten nicht toleriert werden können.
- Embedded CV eignet sich gut für Nischenanwendungen mit extrem niedrigem Stromverbrauch wie intelligente Schlösser, Barcode-Lesegeräte, Wearables und IoT-Sensoren. Sie eignet sich für Unternehmen, die eine einfache visuelle Erkennung in abgelegenen oder eingeschränkten Umgebungen benötigen, ohne auf die Cloud angewiesen zu sein.
Bitte beachten Sie, dass Sie nicht verpflichtet sind, nur eine Option zu wählen. Viele der effektivsten Lösungen von heute beinhalten eine Kombination von Einsatzmethoden.
Sind Sie noch unsicher, welches Setup für Ihren Anwendungsfall das richtige ist?
Unsere Ingenieure können Ihnen helfen, Ihren Bedarf zu ermitteln und die kosteneffektivste Implementierungsstrategie zu empfehlen. Buchen Sie eine kostenlose Beratung und lassen Sie sich von Experten bei der Entwicklung skalierbarer, effizienter Bildverarbeitungssysteme mit künstlicher Intelligenz beraten.
Fazit
Bei der Entwicklung von Computer Vision ist die Einsatzarchitektur ein strategischer Hebel. Die Wahl zwischen Cloud-, Edge- und Embedded-Implementierung kann sich langfristig stärker auf die Kosten auswirken als die Modellkomplexität oder die Anzahl der Funktionen.
Indem Sie die Latenzanforderungen Ihres CV-Systems, die Anforderungen an den Datenschutz und die Rechenbeschränkungen mit dem richtigen Setup in Einklang bringen, können Sie die Infrastrukturkosten erheblich senken, ohne dabei Abstriche bei der Leistung oder Skalierbarkeit zu machen.