Prediktiv analys förändrar hur olje- och gasoperatörer planerar, underhåller och avvecklar tillgångar. I den här artikeln förklarar vi de grundläggande begrepp bakom prediktiv analys inom olja och gas, visa praktiska användningsfall (från prediktivt underhåll till produktionsprognoser och utsläppsövervakning), och gå igenom ett verkligt exempel på AI inom olja och gas – ett projekt som bedömde risken och kostnadsuppskattningen för brunnsövergivning.
- Prediktiv analys gör det möjligt för olje- och gasverksamheter att förutse och åtgärda utrustningsproblem innan de uppstår. Detta minimerar oplanerade driftstopp, bevarar tillgångarnas integritet och minskar underhålls- och driftskostnader (särskilt i stora, komplexa tillgångsportföljer).
- Prediktiv analys med stor genomslagskraft har användningsfall som sträcker sig över hela tillgångens livscykel. Till exempel kan modeller identifiera potentiell korrosion eller defekter innan fel uppstår.
- En AI-fallstudie om plugghantering av brunnar uppnådde 84,4 % noggrannhet (±0,25 pluggfel). Detta möjliggör mer tillförlitlig P&A-riskbedömning, kostnadsuppskattning och kapitalplanering i stor skala.
- Nästa våg av prediktiv analys inom olja och gas fokuserar på teknologier såsom hybrida digitala tvillingar, edge-analys och förklarbar AI.
Vad är prediktiv analys inom olje- och gasindustrin?
Prediktiv analys är ett delområde av olja och gas analys som hjälper företag att omvandla rå operativ data till användbara insikter.
Prediktiv analys är processen att använda historiska data och realtidsdata, i kombination med statistiska algoritmer, maskininlärning (ML) och artificiell intelligens (AI), för att förutsäga framtida händelser eller utfall.
Inom olje- och gasindustrin innebär detta att analysera data från källor som SCADA-system, IoT-sensorer, borrloggar och underhållsregister för att förutse utrustningsfel, optimera produktionsscheman, upptäcka säkerhetsrisker och stödja kostnadseffektivt beslutsfattande.
Genom att gå från reaktiv till proaktiv drift kan företag minska driftstopp, förbättra tillgångarnas livslängd, och öka driftsäkerheten (även i komplexa miljöer såsom offshore-plattformar eller åldrande brunnnätverk).
Viktiga fördelar med prediktiv analys inom olja och gas
Att implementera prediktiv analys ger konkreta fördelar inom drift, underhåll, säkerhet och hållbarhet. Bland de mest effektfulla fördelarna är:
Minskad oplanerad driftstopptid
Minskad oplanerad stilleståndstid är en viktig fördel med prediktiva underhållsinitiativ inom olja och gas.
Prediktiva modeller gör det möjligt för team att planera insatser vid optimal tidpunkt genom att förutse utrustningsfel innan de inträffar. Detta minimerar oväntade driftstopp, håller produktionsscheman på rätt spår och minskar ekonomiska förluster från stoppad verksamhet.
Förlängd tillgångslivslängd
Kontinuerlig övervakning och proaktivt underhåll hjälper till att förhindra överdrivet slitage på utrustning. Prediktiva insikter gör det möjligt för operatörer att åtgärda små problem innan de eskalerar, vilket maximerar den användbara livslängden för tillgångar som pumpar, kompressorer och rörledningar.
Lägre underhålls- och driftskostnader
Detta är en av de tydligaste fördelarna med prediktivt underhåll inom olje- och gasindustrin. Att gå från tidsbaserat till tillståndsbaserat underhåll minskar onödigt servicearbete och undviker kostsamma akutreparationer. Riktade åtgärder säkerställer att underhållsbudgetar används effektivt, samtidigt som optimerad utrustningsprestanda sänker energiförbrukningen och andra driftskostnader.
Förbättrad säkerhet och regelefterlevnad
Tidig upptäckt av avvikelser (såsom tryckvariationer, korrosion eller gasläckor) minskar risken för olyckor som kan skada personal eller miljö. Prediktiv analys stöder även efterlevnad av branschregler genom att tillhandahålla dokumenterade, datadrivna bevis på operativa säkerhetsåtgärder.
Bättre överensstämmelse med hållbarhets- och utsläppsmål
Optimerad utrustningseffektivitet och tidig läckagedetektering bidrar till lägre växthusgasutsläpp. Prediktiv analys möjliggör en mer hållbar resursanvändning, stödjer ESG-åtaganden och hjälper företag att uppfylla stränga miljöstandarder utan att kompromissa med produktiviteten.
Kärnmodelltyper av prediktiv analys inom olja och gas
Kärnan i prediktiv analys inom olja och gas utgörs av tre huvudkategorier av analysmodeller, där var och en tjänar ett olika syfte i att lösa branschens utmaningar:
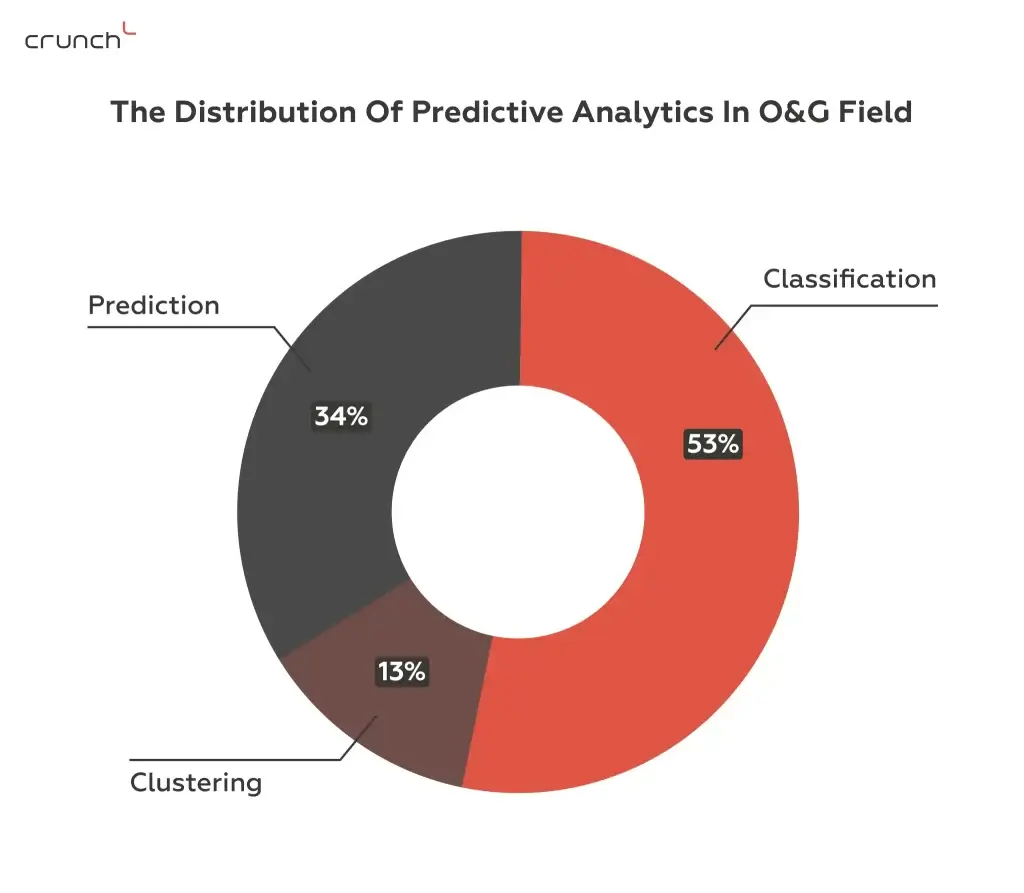
- Klassificeringsmodeller – används för att sortera data i fördefinierade kategorier, till exempel högriskkontra lågriskbrunnar, eller normal kontra felaktig utrustningsstatus. Enligt aktuell branschforskning är dessa modeller de vanligaste inom olja och gas och utgör cirka 53 % av tillämpningarna för prediktiv analys. De är särskilt värdefulla för uppgifter som feldetektering och förutsägelse av säkerhetsincidenter.
- Prediktionsmodeller (regression) – inriktade på att prognostisera kontinuerliga värden, såsom bottenhålstryck, utrustningens återstående livslängd, eller förväntade produktionstakter. Dessa modeller står för ungefär 34 % av prediktiva användningsfall inom olja och gas och är väsentliga för uppgifter inom produktionsoptimering och kostnadsuppskattning.
- Klustringsmodeller – grupperar liknande datapunkter tillsammans utan fördefinierade etiketter, vilket avslöjar mönster som kanske inte är omedelbart uppenbara. Även om det är mindre vanligt (omkring 13 % av applikationerna), är klustring användbart för att identifiera reservoarzoner, segmentera beteendeprofiler för utrustning, eller gruppera brunnar med liknande prestandamönster.
Vanliga AI- och maskininlärningstekniker för prediktiv analys inom olja och gas
För att bygga dessa modeller förlitar sig branschen ofta på en blandning av ML och AI tekniker, inklusive:
- Artificiella neurala nätverk (ANN) – flexibla, kraftfulla algoritmer för att modellera komplexa samband i stora datamängder.
- Long Short-Term Memory (LSTM) nätverk – en typ av djupinlärningsmodell som är idealisk för tidsseriedata, såsom sensoravläsningar eller produktionsloggar.
- Random Forest – en ensembleinlärningsmetod som är robust mot brusiga data, vanligen tillämpad i klassificerings- och regressionsuppgifter.
- Fuzzy logic-system – hanterar osäkerhet och oprecishet, vilket gör dem värdefulla i miljöer med ofullständiga eller inkonsekventa data.
- Hybridmodeller – kombinerar maskininlärning med fysikbaserade simuleringar (digitala tvillingar) för att förbättra noggrannhet och tolkbarhet.
Användningsområden för prediktiv analys inom olje- och gasindustrin
Prediktiv analys driver ett brett spektrum av praktiska lösningar inom olje- och gasindustrin och hjälper operatörer att förbättra säkerhet, effektivitet och kostnadseffektivitet. Nedan följer flera användningsfall som belyser dess mångsidighet:
Rörledningskorrosion och defektprognos
Korrosion är ett stort hot mot rörledningars integritet och miljösäkerhet. Prediktiva modeller använder sensordata, såsom CO₂-koncentration, tryck, flödeshastighet och pH-nivåer, för att identifiera avsnitt med hög risk för korrosion eller defekter. Genom att analysera dessa parametrar kan företag proaktivt schemalägga underhåll innan läckor eller fel uppstår, minska driftstopp och förhindra kostsamma incidenter. Dessa modeller har visat hög noggrannhet i att förutsäga korrosionstrender, vilket möjliggör riktade inspektioner och förlänger rörledningars livslängd.
Prestandaprognoser för brunnar
Att noggrant förutsäga brunnsbeteende är avgörande för att optimera produktionen och planera insatser. Prediktiva modeller uppskattar viktiga parametrar, såsom bottenhålstryck i vertikala brunnar, med hjälp av historiska produktionsdata och sensordata från brunnshuvudet. Detta hjälper ingenjörer att förutse förändringar i reservoarförhållanden och anpassa utvinningsstrategier därefter. Sådan prognostisering hjälper till att maximera produktionen samtidigt som reservoarens hälsa hanteras, vilket därigenom förbättrar lönsamhet och hållbarhet.
Gas- och föroreningsdetektering
Utsläppsövervakning blir allt viktigare för miljöefterlevnad och arbetstagarnas säkerhet. AI-modeller analyserar sensoravläsningar av farliga gaser som svavelväte och flyktiga organiska föreningar (VOC) för att upptäcka läckor tidigt. Genom att modellera rumsliga och tidsmässiga koncentrationsmönster möjliggör dessa verktyg snabb identifiering och lokalisering av föroreningar. Tidig upptäckt hjälper till att förhindra miljöskador och säkerställer efterlevnad av regelverk.
Produktionsoptimering
Genom att kombinera artificiella neurala nätverk med optimeringsalgoritmer, såsom genetiska algoritmer, kan operatörer finjustera kompressorinställningar och annan utrustning för att uppnå maximal effektivitet. Dessa modeller bearbetar komplexa indata (temperatur, tryck och driftsparametrar) för att rekommendera justeringar som maximerar produktionen och minimerar energiförbrukningen. Resultatet är förbättrade produktionshastigheter och minskade driftskostnader, vilket stödjer mer hållbara och lönsamma verksamheter.
AI-fallstudie: Prediktiv analys för risk vid brunnsavveckling och kostnadsuppskattning inom olja och gas
För att omsätta teorin om prediktiv analys i praktiken, låt oss utforska en nyligen AI proof-of-concept utvecklad för riskbedömning och kostnadsberäkning vid brunnsavveckling av en ledande leverantör av datalösningar för olje- och gasindustrin i Texas, USA.
Kontext och utmaning
Eftersom många operatörer möter växande eftersläpningar av äldre brunnar som kräver plugging and abandonment (P&A) blir korrekt riskbedömning och kostnadsprognostisering avgörande. Utmaningen var att hantera tusentals brunnsregister, ofta utspridda, ofullständiga och inkonsekventa, vilket gör traditionell manuell bedömning kostsam och felbenägen. Kunden ville bygga en skalbar AI-driven lösning som kunde leverera tillförlitliga prognoser för att stödja budgetplanering och resursallokering.
Angreppssätt & teknisk stack
Det fyra månader långa projektet inleddes med rigorös datastrukturering och rensning. Teamet integrerade flera olika datakällor till ett enhetligt, konsekvent dataset. Utforskande dataanalys (EDA) kombinerad med avancerad funktionsutveckling avslöjade viktiga samband och möjliggjorde skapandet av ett ”platt” dataset lämpligt för ML.
Träningen av AI-modellen använde XGBoost. Arbetsflödet var värd på AWS SageMaker, med PostgreSQL för datahantering och verktyg som Featuretools och Pandas för tolkningsbarhet och automatiserad feature engineering. Lösningen designades för API-baserad driftsättning, vilket säkerställer smidig integration i befintliga operativa arbetsflöden.
Resultat och effekt
AI-modellen uppnådde 84,4 % prediktionsnoggrannhet för risk för övergivande och kostnadsuppskattning, med en smal prediktionsfelmarginal på ±0,25 pluggar. Denna höga precisionsnivå ger operatörer handlingsbar vägledning för komplexa P&A-processer.

Detta projekt illustrerar den växande mognaden hos dataanalys olje- och gasprojekt och deras förmåga att automatisera komplexa tekniska beslut.
Kontakta våra experter för att diskutera en skräddarsydd metod för dina brunnar, rörledningar eller produktionstillgångar.
Utmaningar med prediktiv analys inom olje- och gasindustrin
1. Datakvalitet och tillgänglighet
Utmaning:
En stor barriär för att implementera prediktiv analys inom olje- och gassektorn är dålig datakvalitet och ofullständiga dataset. I många uppströms-/mellanströms-/nedströmsverksamheter kommer data från äldre system, många sensorer, olikartade format, saknade värden eller inkonsekventa register.
Lösning:
Establish rigorous data governance frameworks: audit and cleanse historical and real-time data, standardize formats, enforce data validation rules, and develop pipelines for continuous data ingestion.
- Börja i liten skala med en specifik tillgång eller ett delsystem.
- Bygg en ”golden record” för en domän.
- Skala.
2. Äldre system och integration
Utmaning:
Många olje- och gasbolag arbetar med äldre system, isolerad infrastruktur, föråldrad hårdvara och mjukvara som inte var utformade för avancerad olje- och gasanalys. Detta gör integration av lösningar för prediktiv analys svår och dyr.
Lösning:
Anta en fasindelad integrationsstrategi:
- implementera mellanprogram eller API-lager för att brygga gamla system med nya analysverktyg;
- gradvis migrera kritiska delsystem;
- använd edge computing där uppkopplingen är dålig;
- bygg integrationsmallar och återanvänd dem över tillgångar.
3. Kompetens- och kulturbarriärer
Utmaning:
Även de bästa modellerna misslyckas om organisationskulturen inte stödjer dem. Det finns ofta motstånd mot förändring, brist på tillit till ”black box”-modeller och en brist på människor som kombinerar domänkunskap (olja och gas) med kompetens inom datavetenskap.
Lösning:
Bygg tvärfunktionella team som inkluderar dataforskare, petroleum-/produktionsingenjörer, underhållspersonal och IT:
- kör utbildningssessioner;
- pilotprojekt som bevisar värde, så att intressenter litar på resultaten;
- inkludera metoder som gör analysen lätt att förstå, såsom feature importance och tydliga dashboards.
Hur man implementerar prediktiv analys inom olja och gas: En steg-för-steg-guide
Att implementera prediktiv analys inom olje- och gasindustrin innebär att skapa ett kontinuerligt, datadrivet arbetsflöde som integrerar sensorer, system och beslutsprocesser.
Nedan följer ett strukturerat tillvägagångssätt som är utformat för att hjälpa operatörer och analysteam samtidigt som mätbara resultat uppnås.
Steg 1: Definiera affärsmål
Börja med att specificera vad du vill att prediktiv analys ska förbättra, till exempel utrustningens drifttid, reservoarprestanda eller minskade utsläpp. Omvandla sedan varje mål till ett mätbart nyckeltal, till exempel färre kompressorfel per månad eller färre timmar av driftstopp.
Steg 2: Granska och integrera dina datakällor
Dataanalys inom olje- och gasindustrin bygger på att förena fragmenterade datamängder, vilka inkluderar SCADA-avläsningar, sensorloggar, borrningsrapporter, underhållshistorik och geologiska undersökningar. Genom att integrera dessa datamängder kan du skapa en enhetlig datamiljö som underlättar korrekt modellträning och korsvalidering.
Till exempel kombinerar dataanalys inom olje- och gasindustrin ofta data från både undergrund och yta för att korrelera reservoarens beteende med utrustningens prestanda. Ju färre datasilos det finns, desto mer tillförlitliga blir förutsägelserna.
Steg 3: Förbered och rensa data
Dålig datakvalitet är ett av de vanligaste hindren i projekt för prediktiv analys inom olje- och gasindustrin. Saknade värden, inkonsekventa format och sensorbrus kan förvränga modellresultat. Tillämpa förbehandlingstekniker (såsom normalisering, funktionsskalning, borttagning av avvikande värden) för att säkerställa att datauppsättningar är konsekventa och redo för maskininlärning.
Team som arbetar med projekt inom dataanalys för olje- och gasindustrin automatiserar ofta detta steg med hjälp av verktyg som Featuretools, PySpark eller AWS Glue för att förbättra pipelineeffektiviteten.
Steg 4: Välj rätt modell och algoritmer
Som nämnts tidigare kräver olika användningsfall skilda modelleringsmetoder:
- Klassificeringsmodeller är effektiva för att upptäcka risker såsom utrustningsfel eller korrosion.
- Regressionsmodeller är bättre lämpade för att förutsäga kontinuerliga utfall, såsom produktionsprognoser och kostnadsuppskattningar.
- Klustringsmodeller är användbara för att upptäcka dolda operativa mönster.
I miljöer med mycket varierande geologi erbjuder hybridmodeller som kombinerar fysikbaserade simuleringar med AI, kända som digitala tvillingar, större noggrannhet. Till exempel, inom prediktiv analys för oljeraffinaderier kan integrering av neurala nätverk med termodynamiska simuleringar optimera processförhållanden, säkerställa säkerhet och maximera utbytet.
Steg 5: Validera, testa och tolka resultaten
Innan en modell driftsätts är det viktigt att validera den med hjälp av historiska data och faktiska fältresultat. Tekniker som korsvalidering, förvirringsmatriser och analys av variablers betydelse kan hjälpa till att säkerställa modellens tillförlitlighet.
Målet är att uppnå både statistisk noggrannhet och tolkningsbarhet, så att ingenjörer kan lita på modellens resultat. Transparens är avgörande eftersom det bygger förtroende, särskilt under regulatoriska revisioner och driftsgenomgångar.
Steg 6: Distribuera och skala
Efter validering, integrera modellen i befintliga system via API:er, molnbaserade instrumentpaneler eller fältövervakningsapplikationer. En skalbar infrastruktur (såsom AWS SageMaker eller Azure Machine Learning) möjliggör uppdateringar i realtid och säkerställer att systemet kan hantera ökande datavolymer.
Med tiden är det avgörande att träna om modellen med nya sensordata för att bibehålla korrekta prognoser. Detta är särskilt viktigt inom prediktiv analys vid olje- och gasprospektering, där de geologiska förhållandena förändras med varje borrfas.
Steg 7: Övervaka prestanda och iterera
Prediktiv analys är en dynamisk process. Kontinuerlig övervakning av noggrannhet, datadrift och latens säkerställer att din modell anpassar sig till förändrade driftförhållanden. Att etablera en återkopplingsslinga mellan dataforskare, fältingenjörer och beslutsfattare hjälper till att förfina prognoser och identifiera nya möjligheter.
Hur använder man prediktiv analys inom olja och gas? Viktiga lärdomar
Prediktiv analys erbjuder kraftfulla verktyg för att omvandla data till värdefulla insikter, men dess effektivitet beror på vilken metod du väljer för att hantera dina unika utmaningar. Här är viktiga lärdomar att ha i åtanke:
Lektion 1: Matcha modellen till uppdraget
Att välja rätt modelltyp är avgörande. Klassificeringsmodeller fungerar bäst när data ska sorteras i kategorier, till exempel för att identifiera högriskbrunnar eller feltillstånd. Regressionsmodeller är utmärkta för att prognostisera kontinuerliga värden, såsom produktionstakt eller avvecklingskostnader. Klustring hjälper till att upptäcka dolda mönster genom att gruppera liknande datapunkter utan fördefinierade utfall. Anpassa ditt val av modell noga efter det problem du behöver lösa för maximal effekt.
Lektion 2: Behandla datakvalitet som icke förhandlingsbar
Kvaliteten på dina förutsägelser beror på kvaliteten på dina data. Noggrann datarengöring och feature engineering lägger grunden för tillförlitlig analys. Att hantera inkonsekvenser, fylla luckor och integrera olika källor säkerställer att din datamängd återspeglar verkligheten. Automatiserad feature engineering kan avslöja subtila, värdefulla prediktorer som förbättrar modellens noggrannhet och robusthet.
Lektion 3: Bygg förtroende genom transparens
Tolkningsbara modeller bygger förtroende bland intressenter och möjliggör handlingskraftigt beslutsfattande. När domänexperter förstår ”varför” bakom förutsägelser är det mer sannolikt att de anammar och förlitar sig på AI-insikter. Verktyg som förklarar egenskapers betydelse eller modellbeteende förbättrar samarbetet och säkerställer att insikterna är relevanta och användbara.
Lektion 4: Tänk bortom bygget
Att bygga modeller är bara det första steget. Molnbaserade, API-baserade lösningar, såsom de som distribueras på AWS SageMaker, möjliggör skalbar integration med befintliga operativa system. Detta stöder kontinuerliga modelluppdateringar, realtidspoängsättning och sömlös användaråtkomst (avgörande för att bädda in prediktiv analys i det dagliga arbetsflödet).
Lektion 5: Gör det till en laginsats
Framgångsrika projekt inom prediktiv analys kräver ett nära samarbete mellan ML-ingenjörer, ämnesexperter (SME:er) och operativa planerare. Denna samordning säkerställer att modellerna hanterar verkliga behov, integrerar domänkunskap och levererar insikter som kan tillämpas praktiskt, vilket påskyndar införandet och driver mätbart affärsvärde.
Genom att omfamna dessa principer kan olje- och gasföretag utnyttja prediktiv analys för att förbättra säkerheten, optimera produktionen och fatta smartare, datadrivna beslut genom hela tillgångars livscykler.
Framväxande trender inom prediktiv analys för olja och gas
Framtiden för analys inom olja och gas rör sig mot mer integrerade, transparenta och hållbarhetsfokuserade lösningar. Ett stort skifte är framväxten av hybrida digitala tvillingar, som förenar operativa realtidsdata med fysikbaserade simuleringar för att leverera mer pålitliga och kontextmedvetna prognoser.
Samtidigt edge-analys vinner mark, vilket möjliggör databehandling vid källan — en avgörande fördel för offshore-riggar och andra avlägsna verksamheter där bandbredd och latens kan vara begränsande faktorer.
En annan viktig utveckling är den ökande betoningen på förklarbar AI (XAI), som säkerställer att ingenjörer och beslutsfattare kan förstå och lita på resonemanget bakom varje förutsägelse.
Slutligen anpassas prediktiva modeller alltmer till hållbarhetsinitiativ, vilket stödjer utsläppsövervakning, förbättringar av energieffektivitet och efterlevnad av nettonollmål inom hela sektorn.
Slutsats
Prediktiv analys håller snabbt på att bli ett oumbärligt verktyg inom olje- och gasindustrin. Den gör det möjligt för operatörer att gå från reaktivt till proaktivt beslutsfattande. Genom att utnyttja rätt modeller, upprätthålla hög datakvalitet, säkerställa transparens och implementera skalbara lösningar kan företag minska operativa risker, optimera resurser och förbättra säkerheten.
Som nästa steg kan du överväga att testa prediktiva analysprojekt som är anpassade efter dina behov. Att börja i liten skala med proof-of-concept-initiativ gör att du kan påvisa värde, förfina din strategi och bygga tvärfunktionell fart mot ett fullskaligt införande.
Våra specialister kan vägleda dig genom valet av analysmodeller för olja och gas, dataintegration och driftsättning, oavsett om du börjar med ett litet pilotprojekt eller skalar upp för hela företaget. Boka en kostnadsfri konsultation för att utforska dina alternativ.