Running enterprise IT on-premises costs more than most finance teams realize — and the gap widens every year. Hardware refresh cycles, underutilized servers, and the engineering hours spent keeping legacy systems alive all compound into a structural cost problem that capital investment alone can’t fix.
Cloud-migrering ændrer ligningen. Det flytter infrastruktur fra et fast, værdiforringende aktiv til en variabel, forbrugsbaseret ressource — og det gør det, samtidig med at den operationelle byrde på IT-teams reduceres. Resultatet er lavere samlede ejeromkostninger, hurtigere leveringscyklusser og evnen til at skalere uden proportionale udgifter.
Denne artikel gennemgår, hvor lokal infrastruktur taber penge, hvordan en veludført migrering håndterer hver kilde til spild, og hvordan de langsigtede økonomiske resultater ser ud, når cloud-native drift er etableret.
- On-premise infrastructure drains budget in three ways: over-provisioned hardware that sits idle, maintenance costs that run regardless of usage, and engineering hours lost to legacy upkeep.
- Elastic cloud resources scale with demand, without a proportional increase in infrastructure spend.
- Cloud-native architectures reduce operational overhead through automation, managed services, and infrastructure-as-code.
- Accurate ROI measurement tracks both direct savings and indirect gains.
Omkostningsudfordringerne ved traditionel lokal IT-infrastruktur
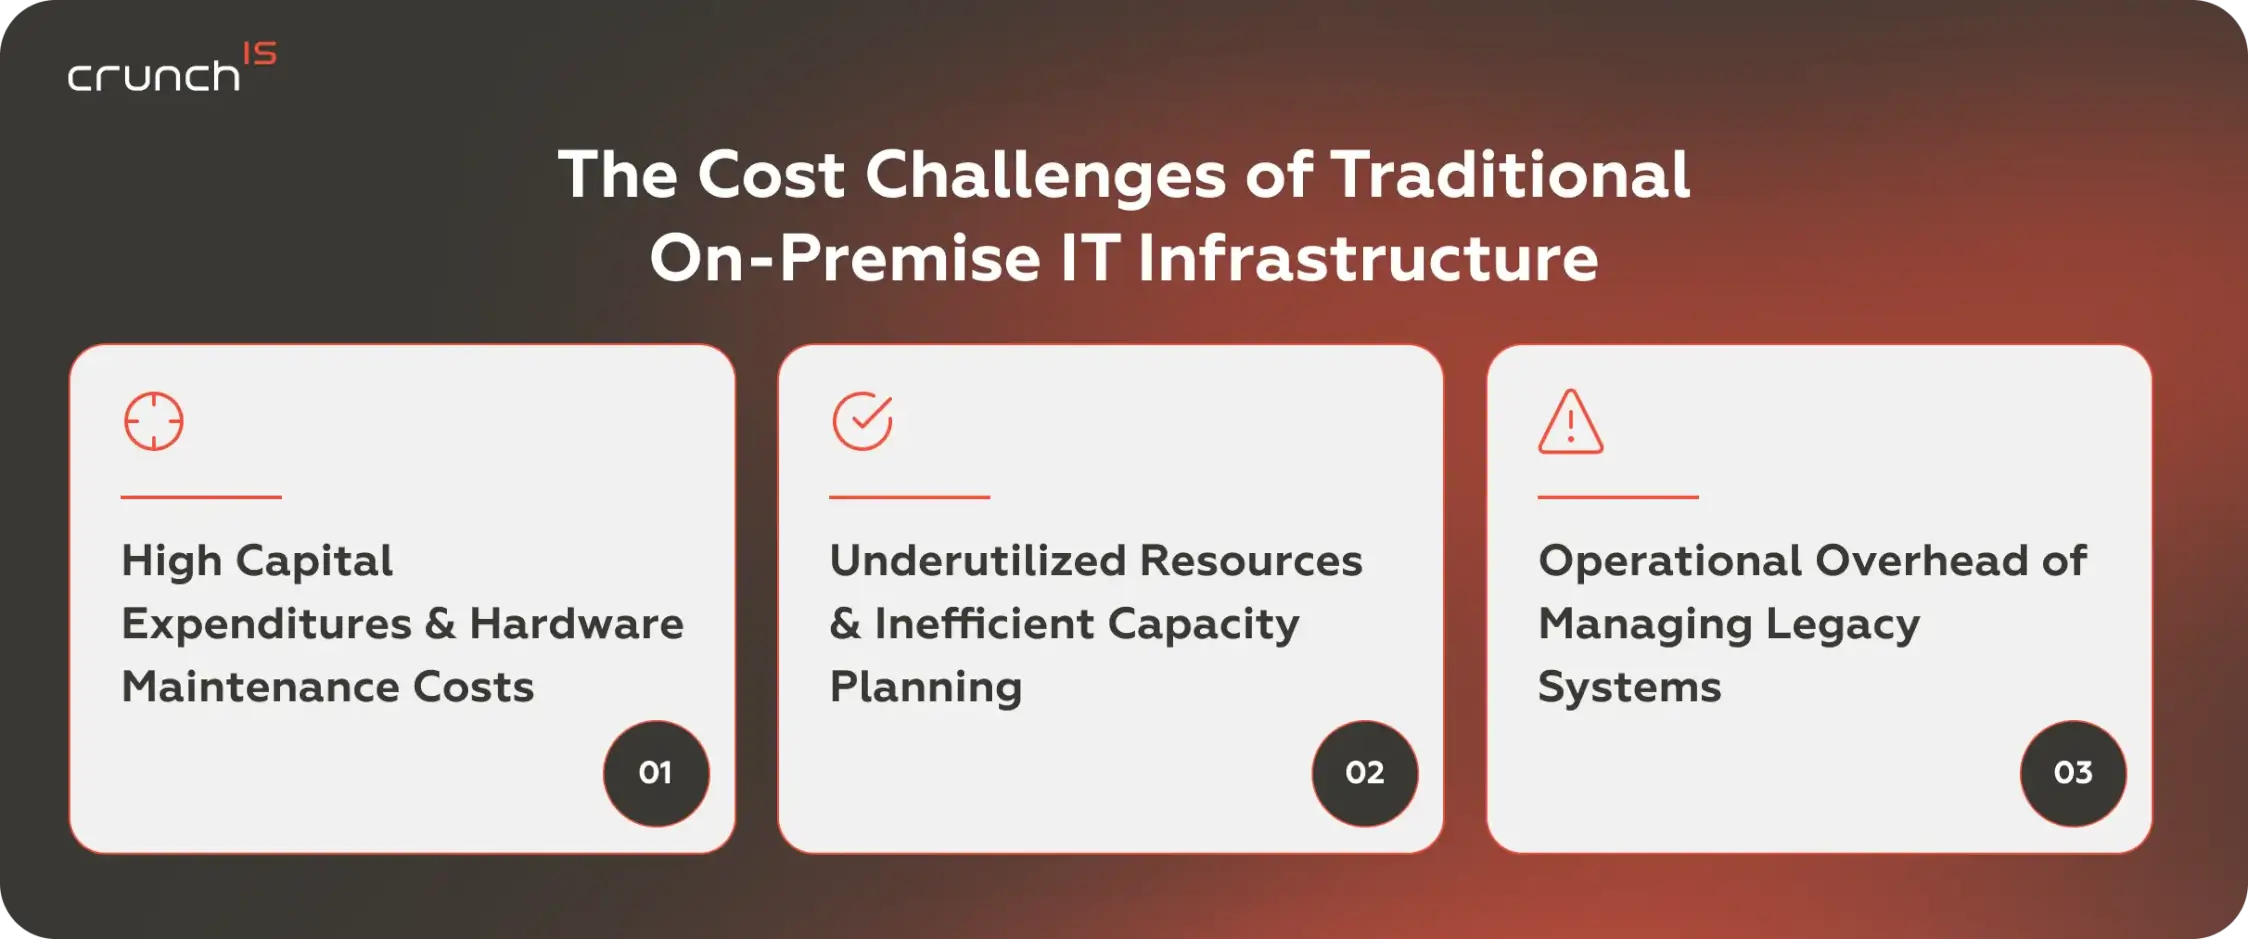
Før man undersøger, hvad skyen sparer, er det værd at forstå, hvor omkostningerne til lokal infrastruktur egentlig stammer fra — for problemet stikker dybere end hardwarefakturaer. Der er tre forskellige omkostningskilder, og hver enkelt forstærker de andre:
1. Høje kapitaludgifter og vedligeholdelsesomkostninger for hardware
Den første omkostning er synlig og uundgåelig: lokal infrastruktur kræver betydelig kapital på forhånd. Servere, lagerarrays, netværksudstyr og datacenterfaciliteter skal alle indkøbes, installeres og afskrives over flerårige cyklusser. Hardware-opdateringscyklusser løber typisk over tre til fem år — men forretningskrav ændrer sig hurtigere end indkøbsplaner.
Resultatet: virksomheder enten overprovisionere (køber kapacitet, de ikke vil bruge i årevis) eller underprovisionere (skaber flaskehalse i ydeevnen på det værst tænkelige tidspunkt).
Ud over anskaffelse forværrer vedligeholdelse problemet. Garantikontrakter, licenserede supportaftaler, fysisk udskiftning af defekte komponenter og faciliteternes omkostninger til at drive og køle hardwaren løber alle kontinuerligt. Disse omkostninger eksisterer uanset, hvor meget af infrastrukturen der rent faktisk er i brug.
2. Underudnyttede ressourcer og ineffektiv kapacitetsplanlægning
Den anden omkostning er mindre synlig, men lige så skadelig: det meste af den hardware står inaktiv det meste af tiden. On-premise-miljøer klargøres til spidsbelastning (en kvartalsvis behandlingsstigning, en produktlancering, en periode med mange samtidige brugere) og bærer derefter den fulde kapacitet som overhead resten af året.
Det er en iboende begrænsning ved fast infrastruktur. Når efterspørgslen falder, gør omkostningerne det ikke. Når efterspørgslen stiger ud over det forventede, kan infrastrukturen ikke reagere hurtigt nok til at undgå forringet ydeevne.
For IT-teams skaber dette en evig balancegang mellem omkostningseffektivitet og risikoreduktion. Ledig infrastruktur skal stadig patches, overvåges og vedligeholdes — og det arbejde falder på ingeniører, som kunne bygge noget i stedet. Hvilket bringer os til den tredje omkostning.
3. Driftsomkostninger ved administration af ældre systemer
Legacysystem vedligeholdelse optager en uforholdsmæssig stor andel af IT-ressourcerne. Patch-håndtering, versionsopgraderinger, integrationsfejlfinding, manuel provisionering og hændelsesrespons kræver alle dygtig ingeniørtid.
Jo ældre systemet er, jo værre er ekstraomkostningerne:
- dokumentation eroderer,
- ingeniører, der byggede den oprindelige arkitektur forlade, og
- afhængigheder akkumulere.
Det, der startede som et vedligeholdelsesvenligt system, bliver en skrøbelig, svær-at-ændre begrænsning for hele organisationens tekniske hastighed.
Tilsammen er disse tre omkostningskilder præcis det, en velstruktureret cloud-migrering er designet til at eliminere.
Hvordan Cloud-migrering Reducerer IT-omkostninger og Forbedrer Effektiviteten
En velplanlagt migrering håndterer ikke disse tre omkostningskilder én ad gangen. Den omstrukturerer, hvordan IT-omkostninger genereres, spores og kontrolleres på tværs af alle tre samtidigt.
Skift fra CapEx til OpEx med Pay-As-You-Go-modeller
Den mest umiddelbare økonomiske ændring efter cloud-migrering er skiftet fra kapitaludgifter (CapEx) til driftsudgifter (OpEx). I stedet for at købe og afskrive hardware betaler organisationer for den beregning, lagring og netværk, de faktisk forbruger — typisk på timebaserede eller pr. sekund-faktureringscyklusser.
For økonomiteams er dette betydningsfuldt. CapEx kræver forudgående kapitalforpligtelser og flerårige afskrivningsplaner, som kan være ude af trit med den faktiske levering af forretningsværdi. OpEx tilpasser omkostningerne direkte til forbruget, hvilket gør IT-udgifter lettere at forudsige, fordele og styre.
For ingeniørteams betyder det, at infrastrukturbeslutninger er reversible. Miljøer kan oprettes til et projekt og lukkes ned, når de ikke længere er nødvendige. Ressourcer kan tilpasses i størrelse baseret på observerede brugsmønstre frem for forventet spidsbelastning.
I en nylig Crunch-IS-opgave, en US-baseret sundhedsorganisation elimineret $150K–$300K i omkostninger til opdatering af on-premise-hardware inden for 10 uger efter migrering af et indtægtskritisk planlægnings- og faktureringssystem til AWS — uden at røre applikationskoden eller forstyrre den kliniske drift.

Reduktion af infrastruktur- og vedligeholdelsesudgifter
Når arbejdsbelastninger flyttes til et administreret cloud-miljø, forsvinder eller reduceres store kategorier af omkostninger til lokal drift betydeligt:
- cyklusser for hardwareanskaffelse og -opdatering er e erstattet af udbyderadministreret infrastruktur, løbende opdateret uden kundesidens kapitalinvestering;
- datacenterfaciliteter overførsel til udbyderen;
- leverandørvedligeholdelseskontrakter for hardware er elimineret, erstattet af SLA’er på platformniveau;
- manuelt provisioneringsarbejde viger for infrastruktur-som-kode og automatiseret udrulning pipelines.
Organizations moving to managed cloud services also reduce engineering overhead across OS patching, database administration, and backup management. The provider owns that layer of operations. The internal team focuses on application logic and business capability.
Denne omfordeling er der, hvor fordelene ved cloud-migrering bliver håndgribelige ud over fakturaen: mindre budget forbrugt ved at holde tingene kørende betyder mere tilgængeligt til det, der driver forretningen fremad. Når infrastruktur- og vedligeholdelsesomkostningerne er under kontrol, er den næste løftestang operationel effektivitet — og det er der, hvor automatisering udfører størstedelen af arbejdet.
Automatisering og Managed Services, der driver operationel effektivitet
Cloud-platforme kommer med et indbygget indfødt automatiseringslag. Auto-skalering justerer kapaciteten, så den matcher efterspørgslen i realtid. Administrerede databaser håndterer replikering, failover og patching automatisk. CI/CD-pipelines erstatter manuelle deployment-trin med gentagelige, reviderbare processer.
Den driftsmæssige indvirkning er målbar:
- responstider for hændelser falder når infrastruktur kan udskiftes i stedet for at repareres;
- udrulningsfrekvensen stiger når release-pipelines eliminerer manuelle godkendelser;
- ingeniørkapacitet omdirigeres fra vedligeholdelse til levering når platforme håndterer rutinemæssige operationer automatisk.
Cloud-migrering software og DevOps værktøjer accelererer denne overgang ved at gøre det muligt for teams at behandle infrastruktur som kode — versioneret, testet og udrullet gennem de samme processer som applikationssoftware. Resultatet er en IT-drift, der kører slankere, reagerer hurtigere og kræver færre mennesker for at holde den stabil.
Langsigtede omkostningsbesparelser og forretningsværdi ved cloud-migrering
Migrering reducerer omkostningerne øjeblikkeligt gennem eliminering af hardware, lavere vedligeholdelse og mindre manuelt arbejde. Det, der akkumuleres over tid, er noget andet:
- Evnen til at skalere uden at købe ny infrastruktur,
- optimize costs to reflect true consumption.
- omdirigere ingeniørkapaciteten mod arbejde, der reelt driver forretningsvækst.
Skalerbarhed og omkostningsstyring gennem elastiske ressourcer
Elastisk infrastruktur ændrer økonomien i vækst. Organisationer behøver ikke længere at tilrettelægge kapacitet til forventet fremtidig skala — de tilrettelægger til den aktuelle efterspørgsel og skalerer dynamisk, efterhånden som efterspørgslen opstår.
Dette betyder mest ved yderpunkter. En pludselig trafikstigning, der ville have lagt et lokalt miljø ned, dirigeres problemfrit til yderligere computerkraft i et cloud-miljø og frigiver derefter den kapacitet, når stigningen er ovre. En ny forretningsenhed eller produktlinje kan etableres på dage, ikke de uger, der kræves for at anskaffe og klargøre fysisk hardware.
For organisationer, der forfølger cloud-transformationsløsninger som en del af en bredere vækststrategi, er dette elasticitet er en konkurrencemæssig evne. Evnen til at teste, skalere og afvikle initiativer uden proportional infrastrukturforpligtelse sænker risikoprofilen for strategisk eksperimentering.
Optimering af IT-drift med cloud-native arkitekturer
Applikationsmigrering til skyen låser op for arkitekturmønstre, der simpelthen ikke er levedygtige on-premise. Mikrotjenester med uafhængig skalering, serverless compute til hændelsesdrevne arbejdsbelastninger, administrerede datapipelines, multi-region-udrulninger til tilgængeligheds- og latensoptimering — hver bliver en praktisk mulighed, når infrastrukturbegrænsningen er væk.
Hvert mønster reducerer en specifik kategori af driftsomkostninger:
- mikrotjenester gør det muligt at skalere eller opdatere individuelle komponenter uden at røre resten af systemet;
- serverless eliminerer omkostningerne ved inaktiv beregning — funktionen kører, når den kaldes, og koster intet, når den er inaktiv;
- administrerede datatjenester eliminer DBA-omkostninger til rutinemæssige operationer.
Cloud-til-cloud-migrering følger den samme logik. Nogle organisationer er allerede flyttet til skyen, men endte med den forkerte arkitektur — overprovisionerede instanser, underudnyttet reserveret kapacitet eller generelle miljøer, der kører specialiserede arbejdsbelastninger. Løsningen er den samme omkostningsdisciplin: t ilpas ressourcernes størrelse, skær væk, hvad der ikke bruges, og e rstat selvadministrerede tjenester med administrerede modstykker, som udbyderen driver bedre.
Måling af ROI og de samlede ejeromkostninger (TCO) efter migrering
ROI fra cloud-migrering er reel, men det kræver måling at fange den — og de indirekte besparelser er ofte større end de direkte. De er bare sværere at sætte i et regneark. Ingeniørtid omdirigeret fra vedligeholdelse til levering, hurtigere time-to-market, reducerede omkostninger til hændelsesrespons, og lavere risikoeksponering fra automatiseret patching akkumulerer alle over tid på måder, som en engangsberegning af TCO ikke fuldt ud vil fange.
De direkte besparelser er mere ligetil:
- eliminerede udgifter til hardwareopdatering,
- reducerede facilitetsomkostninger,
- leverandørvedligeholdelseskontrakter, der ikke længere er gældende, og
- Bemandingstimer, der ikke længere bruges på vedligeholdelse af infrastruktur.
Cloududbydere offentliggør TCO-beregnere som udgangspunkt, men nøjagtig analyse kræver detaljerede oplysninger om nuværende on-premise-omkostninger, udnyttelsesmønstre og planlagt vækst i arbejdsbelastning.
Cloud-migrationskonsulentydelser leverer denne analyse og oversætter den til en arkitektur, der giver de forventede besparelser (i stedet for at skabe nye).
Hvorfor Crunch-IS er en førende virksomhed inden for cloud-migrationstjenester
Crunch-IS is a full-service technology partner with 8+ years of experience and 150+ engineers and consultants delivering Cloud and DevOps, custom software development, AI/ML, and data engineering solutions for clients across the US, UK, Canada, and the DACH region.
Vores cloud-praksis er bygget på teknisk dybde, ikke på antallet af leverandørcertificeringer.
Dokumenteret ekspertise inden for cloud-strategi og migreringsplanlægning
Migrering uden en strategi er dyr. Vi har set organisationer flytte arbejdsbelastninger til skyen efter lift-and-shift-metoden, opdage at deres omkostninger steg, og derefter bruge måneder på at rulle arkitektoniske beslutninger tilbage, som gav mening on-premise, men ikke i en cloud-faktureringsmodel.
Crunch-IS-engagementer begynder med en teknisk og omkostningsmæssig vurdering:
- nuværende infrastrukturopgørelse,
- udnyttelsesanalyse,
- afhængighedskortlægning, og
- en migrationsplan, der sekventerer arbejdsbelastninger efter kompleksitet og forretningsmæssig betydning.
Strategien afgør, hvilke arbejdsbelastninger der bør være gen-hostet, gen-platformeret, refaktoreret, eller udfaset — og i hvilken rækkefølge.
Da vi migrerede et patientplanlægnings- og faktureringssystem til AWS for en amerikansk sundhedsorganisation, forløb engagementet i 10 uger fra vurdering til stabilisering — til tiden, inden for omfanget og med 99,9 %+ tilgængelighed fra dag ét. Katastrofegenoprettelsestiden faldt fra op til 8 timer til under 15 minutter. Og infrastrukturrelaterede supporthenvendelser faldt med 50 %.
Vores rådgivningstjenester inden for cloud-migrering dækker fra strategi til udførelse, med teknisk ansvarlighed i alle faser.
Omkostningsoptimerede cloud-arkitekturer og FinOps-tilgang
Rightsizing er ikke en engangsaktivitet. Cloudforbruget vokser organisk — nye miljøer bliver provisioneret, gamle bliver ikke afsluttet, reserveret kapacitet bliver underudnyttet, og omkostninger akkumuleres på måder, der ikke er synlige uden aktiv styring.
Crunch-IS designer cloud-arkitekturer med omkostningsobservabilitet indbygget fra dag ét: tagging-strategier, der henfører forbrug til teams og arbejdsbelastninger, alarmering ved omkostningsanomalier og regelmæssige rightsizing-gennemgange baseret på faktiske forbrugsdata. Vi anvender FinOps principper gennem hele engagementet som en løbende operationel disciplin.
Sikre, skalerbare og forretningsfokuserede migreringsløsninger
Sikkerhed er en almindelig bekymring i diskussioner om cloud-migreringstjenester, og det er en legitim en. At flytte arbejdsbelastninger til delt infrastruktur kræver en bevidst sikkerhedsarkitektur — netværkssegmentering, identitets- og adgangsstyring, kryptering under transport og i hvile samt overholdelseskontroller, der passer til kundens regulatoriske miljø.
Crunch-IS integrerer sikkerhed fra arkitekturfasen. Vi implementerer DevSecOps-praksis, automatiseret sikkerhedsscanning i CI/CD-pipelines og compliance-klare konfigurationer til regulerede brancher. Vores Site Reliability Engineering (SRE)-praksis sikrer, at mål for tilgængelighed og ydeevne defineres, måles og opretholdes efter migrering.
Hver opgave defineres ud fra forretningsmæssige resultater:
- Reducerede omkostninger,
- forbedret pålidelighed,
- hurtigere levering,
- eller alle tre.
Vi foreslår ikke migreringer for deres egen skyld. Vi afgrænser dem ud fra den specifikke værdi, de vil levere, med målekriterier, der er fastlagt, før arbejdet begynder.