
ETL/ELT-arkitektur og -orkestrering
Vi designer og implementerer ETL- og ELT-workflows og vælger det rette mønster baseret på transformationskompleksitet, latenskrav og platformsegenskaber.
Kan du ikke se din branche? Lad os tage en snak.
Tal med en AI-ekspertCrunch-IS i tal


Vi designer og bygger datapipelines, platforme og integrationer, der yder under reelle produktionsforhold — ved at anvende en AI-drevet udviklingstilgang, cloud-native værktøjer og strukturerede ingeniørpraksisser for at gøre din datainfrastruktur pålidelig, observerbar og klar til at understøtte beslutninger i stor skala.
Valideringstjek, overvågningsregler og automatiske advarsler holder data rene og konsistente på tværs af hver pipeline. Dit team stopper med at afstemme rapporter manuelt og begynder at handle på resultater, der allerede er verificeret.
Når pipelines kører pålideligt, og data er struktureret til adgang, holder analytikere og produktteams op med at vente på engineering. Tiden mellem et forretningsspørgsmål og et troværdigt svar komprimeres markant.
Pipelines, der er designet med korrekt fejlhåndtering, genforsøgslogik og observerbarhed, kræver langt mindre praktisk vedligeholdelse. Ingeniørindsatsen flytter sig fra brandslukning af ødelagte jobs til opbygning af nye funktioner.
Hver transformation er dokumenteret, og hver kilde er kortlagt. Når et compliance-krav eller et datakvalitetsproblem dukker op, kan dit team spore det direkte — uden at skulle reverse-engineere pipelinen fra bunden.
Vi designer og bygger ETL- og ELT-pipelines, der flytter data pålideligt fra kilde til destination — herunder struktureret indhentning, automatiserede transformationer, fejlhåndtering og genoprettelseslogik. Hver pipeline testes mod realistiske fejlscenarier, før den når produktion, og overvågning er indbygget fra starten.
Vi håndterer migreringer fra ældre systemer, lokale databaser og cloud-til-cloud-miljøer. Opgaven omfatter kildekortlægning, skemaafstemning, datarensning, faseinddelt overførselsudførelse og validering efter migrering i forhold til aftalte acceptkriterier. Intet godkendes ved en enkelt cutover-begivenhed.
Vi vurderer din nuværende dataarkitektur, identificerer hvor mangler i pålidelighed, ydeevne, sporbarhed, sikkerhed eller vedligeholdelsesvenlighed koster dit team — i tid, risikoeksponering eller teknisk overhead — og leverer en prioriteret teknisk køreplan. Konsulentopgaver giver klar retning og kan overgå direkte til implementering, hvis omfanget berettiger det.
Vi designer og konfigurerer lagrings-, beregnings- og adgangslagene, som dine pipelines kører oven på — herunder opsætning af warehouse og lakehouse på AWS, Azure, GCP eller lokale miljøer, skemadesign, lagringsoptimering og adgangskontrol. Målet er en platform, som dit team kan drive og udvide uden konstant leverandørinvolvering.
Regneark, PDF’er, e-mails og scanninger indeholder data, som dine rapporter aldrig ser, fordi intet kan indlæse dem i et data warehouse, som de er. Vores AI-dataintegration bruger modeller til at læse disse filer, udtrække felterne og indlæse rene rækker ved siden af dine strukturerede datafeeds, mens poster med lav sikkerhed sendes til en person til gennemgang. For en investeringsplatform for erhvervsejendomme i USA behandlede AI-drevet parsing af Excel-filer med Python og AWS SageMaker over 500.000 rækker investeringsdata og reducerede manuelle Excel-workflows med 70 %.
En AI-assistent kan kun svare ud fra det, dens pipeline giver den. Vores Data Engineering-tjenester til AI bygger den pipeline: indhentning fra dine dokumenter og systemer, chunking og embedding, en vektordatabase, der holdes synkroniseret med sine kilder, og kontroller, der fjerner forældet eller dubleret indhold, før assistenten svarer ud fra det. For en IT-servicevirksomhed i Storbritannien gav retrieval-pipelinen bag en RAG-assistent på AWS 60 % hurtigere arbejde med virksomhedens dokumenter.
Vi designer og implementerer ETL- og ELT-workflows og vælger det rette mønster baseret på transformationskompleksitet, latenskrav og platformsegenskaber.
Vi bygger systemer, der håndterer streaming-data sammen med batchbehandlingsworkflows til planlagte, højvolumen-belastninger.
Vi integrerer AI-drevne komponenter i datapipeline-workflows — automatisk anomalidetektion, intelligente advarsler om skemadrift, selvhelbredende genforsøgslogik og LLM-assisteret datatransformation til ustrukturerede eller semistrukturerede kilder.
Vi implementerer skemavalidering, kvalitetskontrol på rækkeniveau, konsistensregler og anomalidetektion ved hjælp af frameworks. Advarsler udløses ved afvigelser, før de spreder sig videre nedstrøms.
Adgangskontroller, kryptering i hvile og under overførsel, revisionslogning og rollebaserede tilladelser er indarbejdet i platformens arkitektur i designfasen.
Vurdering af datamiljø, pipelinekrav og acceptkriterier aftales, før udviklingen starter. Du ved, hvad der bygges, hvordan det vil blive målt, og hvordan det ser ud, når det er færdigt.
Vi integrerer AI-værktøjer på tværs af hele data engineering-livscyklussen — fra pipeline-stilladsering og transformationslogik til automatiserede kvalitetskontroller og overvågning efter lancering. Udviklingscyklusser komprimeres uden at tilføje personale.
Pipeline-arkitektur, transformationslogik, dataordbøger og platformskonfiguration dokumenteres og overdrages som brugbart referencemateriale. Dit team kan selv vedligeholde, udvide og fejlfinde systemet.
Hvert samarbejde inkluderer en defineret overvågningsperiode efter lancering. Hvis noget skrider efter go-live, er vi stadig ansvarlige — justeringer sker, før de bliver til hændelser.
De fleste pipeline-fejl opstår i kløften mellem testdata og reelle driftsbelastninger. Vi bygger og validerer op imod de datamængder, skemavariationer og kildeinkonsistenser, som dit system faktisk vil møde.
Vi anvender AI til at løse reelle ingeniørmæssige problemer: automatiseret anomalidetektion, intelligent skemaovervågning, LLM-assisteret transformation af ustrukturerede data og AI-drevet pipelinediagnostik.
Migreringer mislykkes, når teams behandler dem som en enkelt cutover-begivenhed. Vi kører dem i kontrollerede faser — audit før migrering, parallel validering, accepttestet overførsel, afstemningsgodkendelse.
De kommer med mange skalerbare og idéer om bedste praksis som gør det muligt for os at opnå det vi har i dag.
Crunch-IS var rigtig gode til at vise os hvordan gode løsninger bør se ud og at gøre vores idéer levende til evaluering og gennemgang.

Det der imponerede mig ved Crunch-IS er kvaliteten af udviklerne. Den er simpelthen meget bedre end i noget andet firma, vi har forsøgt at samarbejde med.

Vi er imponerede over deres præstationer, hvordan de er engagerede i produktudviklingen og hvordan de bekymrer sig om produktet.

Det har været en meget behagelig oplevelse. Alt har været fantastisk med hensyn til kommunikation og samarbejde.

Vores samarbejde med Crunch-IS har været en uvurderlig ressource, mens vi har skaleret.

Det jeg fandt hos Crunch-IS var den tekniske kompetence, evnen til at tænke ud af boksen og meget godt engelsk.

De har haft stor indflydelse på hele den arkitektur, vi endte med. Alt i alt har jeg været tilfreds og imponeret over alt, hvad Crunch-IS gjorde for os.

Crunch-IS imponerede os med deres tekniske dygtighed og det rene ”møde mellem tanker og kulturer” samt åbne, ærlige samtaler. Dette var ikke en beslutning, vi tog let på, og fem måneder inde i samarbejdet er vi fortsat meget imponerede over, hvordan Crunch-IS griber samarbejdet an, og vi er meget tilfredse med kvaliteten af det team, der arbejder sammen med os.

Det var nemt at arbejde med Crunch-IS. De var tålmodige med os, mens vi gennemgik kontraktspørgsmålene, og tålmodige igen, da vi fik faktureringen på plads. Designarbejdet var elegant og udvikleren leverede den app, vi havde aftalt, til tiden og i god kvalitet.

Teamet hos Crunch-IS var meget rart at arbejde sammen med. De arbejdede flittigt og var meget professionelle. Når der opstod spørgsmål eller tekniske problemer, svarede de hurtigt og var altid klar og venlige til at hjælpe os.

En udvikler fra Crunch-IS hjalp os med at levere en vigtig funktion til vores projekt meget hurtigere end forventet.

Crunch-IS sikrede et gnidningsfrit og samarbejdsorienteret forløb gennem hele projektet. Teamet holdt åbne kommunikationslinjer, førte detaljerede optegnelser over opgavefordelingen og overholdt projektets tidsplaner. Deres ekspertise inden for både design og udvikling gør virksomheden speciel.

Crunch-IS leverer løbende udviklingssupport, der opfylder projektets krav efter behov. Trods deres placering i udlandet er de nemme at arbejde sammen med og tilgængelige via kommunikationskanaler

Den bedste leverandør vi overhovedet kunne finde. Crunch-IS kombinerer praktisk udvikling med innovative designprincipper. Både intern og ekstern feedback på appudviklingen har været positiv. De når projektets milepæle efter den planlagte tidsplan og leverer inden for budgettet. Teamet’ er lydhørt og villigt til at indgå i en produktiv dialog.

Crunch-IS overgik mine forventninger. Jeg satte pris på udviklernes opfindsomhed over for begrænsninger og komplekse krav. Virksomheden magtede at levere og fuldføre projektet med succes.

Projektet er indtil videre forløbet gnidningsfrit. Crunch-IS har en enestående arbejdsmoral. Som følge heraf har de’ kunnet klare enhver udfordring, der er dukket op. De klarer det daglige arbejde godt på egen hånd, men kommunikerer også regelmæssigt med os for at sikre, at vi’ er enige.

Appen, som Crunch-IS arbejdede på, er ren, strømlinet og fungerer efter hensigten. Crunch-IS gør mere end forventet for at sikre, at begge teams er på bølgelængde. Det engagerede team skaber en behagelig oplevelse gennem deres positive fremtoning og effektive projektledelse. Teamet var meget venligt, og det var en fornøjelse at arbejde sammen med dem.

Data engineering er disciplinen med at designe, bygge og vedligeholde den infrastruktur, der gør rådata brugbare. Dette omfatter at bygge pipelines, der indsamler data fra flere kilder, transformerer dem til ensartede formater, lagrer dem i strukturer, der understøtter analyse, og holder hele systemet kørende pålideligt i stor skala. Dataforskere, analytikere og produktteams er alle afhængige af denne infrastruktur — når den er solid, arbejder alle hurtigere; når den ikke er det, mærker hele organisationen det.
Data engineering opbygger de systemer, der indsamler, renser og leverer data i en brugbar tilstand. Data science arbejder med disse data for at køre analyser, bygge modeller og generere forudsigelser. De afhænger af hinanden: data science producerer kun pålidelige resultater, når den underliggende infrastruktur er solid. I de fleste organisationer er den hurtigste måde at forbedre det analytiske output på at forbedre kvaliteten af data engineering først.
Vi udfører migreringer i faser. Den første fase er en fuld gennemgang af kildemiljøet — skemamapping, vurdering af datakvalitet og identifikation af huller. Vi udfører overførsler i kontrollerede batches, med valideringskontrolpunkter i hver fase, og kører parallelle miljøer, når det er nødvendigt, for at bekræfte outputtet, før kilden nedlægges. Efter migreringen kører vi afstemningskontroller mod aftalte acceptkriterier. Intet godkendes på en enkelt overgang.
De fleste relationelle databaser (PostgreSQL, MySQL, SQL Server, Oracle), cloud-lagring (S3, Azure Blob, GCS), SaaS-API’er (Salesforce, HubSpot, Stripe og lignende), beskedkøer (Kafka, Kinesis, RabbitMQ), flade filer (CSV, JSON, Parquet) og ældre systemer med brugerdefinerede protokoller. Integrationsmetoden — direkte connectors, brugerdefinerede Python-extractors eller administrerede værktøjer som Fivetran — vælges baseret på pålidelighedskrav og vedligeholdelsesomkostninger.
Adgangskontroller, kryptering og revisionslogning er indbygget i platformens arkitektur i designfasen. Rollebaserede tilladelser begrænser, hvem der kan læse eller ændre hvert datasæt. Data under overførsel er krypteret; data i hvile bruger platformens indbyggede krypteringsmekanismer på AWS, Azure eller GCP. For regulerede miljøer dokumenterer vi datahåndteringspraksis i forhold til GDPR-, HIPAA- eller SOC 2-krav og kan levere arkitekturdokumentation til overholdelsesgennemgang.
Python er standardsproget for data engineering på grund af sit robuste økosystem. Apache Airflow — det mest udbredte framework til pipeline-orkestrering — er Python-native. PySpark håndterer distribueret databehandling i stor skala. dbt integreres med Python til test- og transformationsworkflows. Pandas og SQLAlchemy dækker udtræk, transformation og databaseforbindelse.
Gennemgå din idé med en ingeniør i en gratis vurderingssamtale.
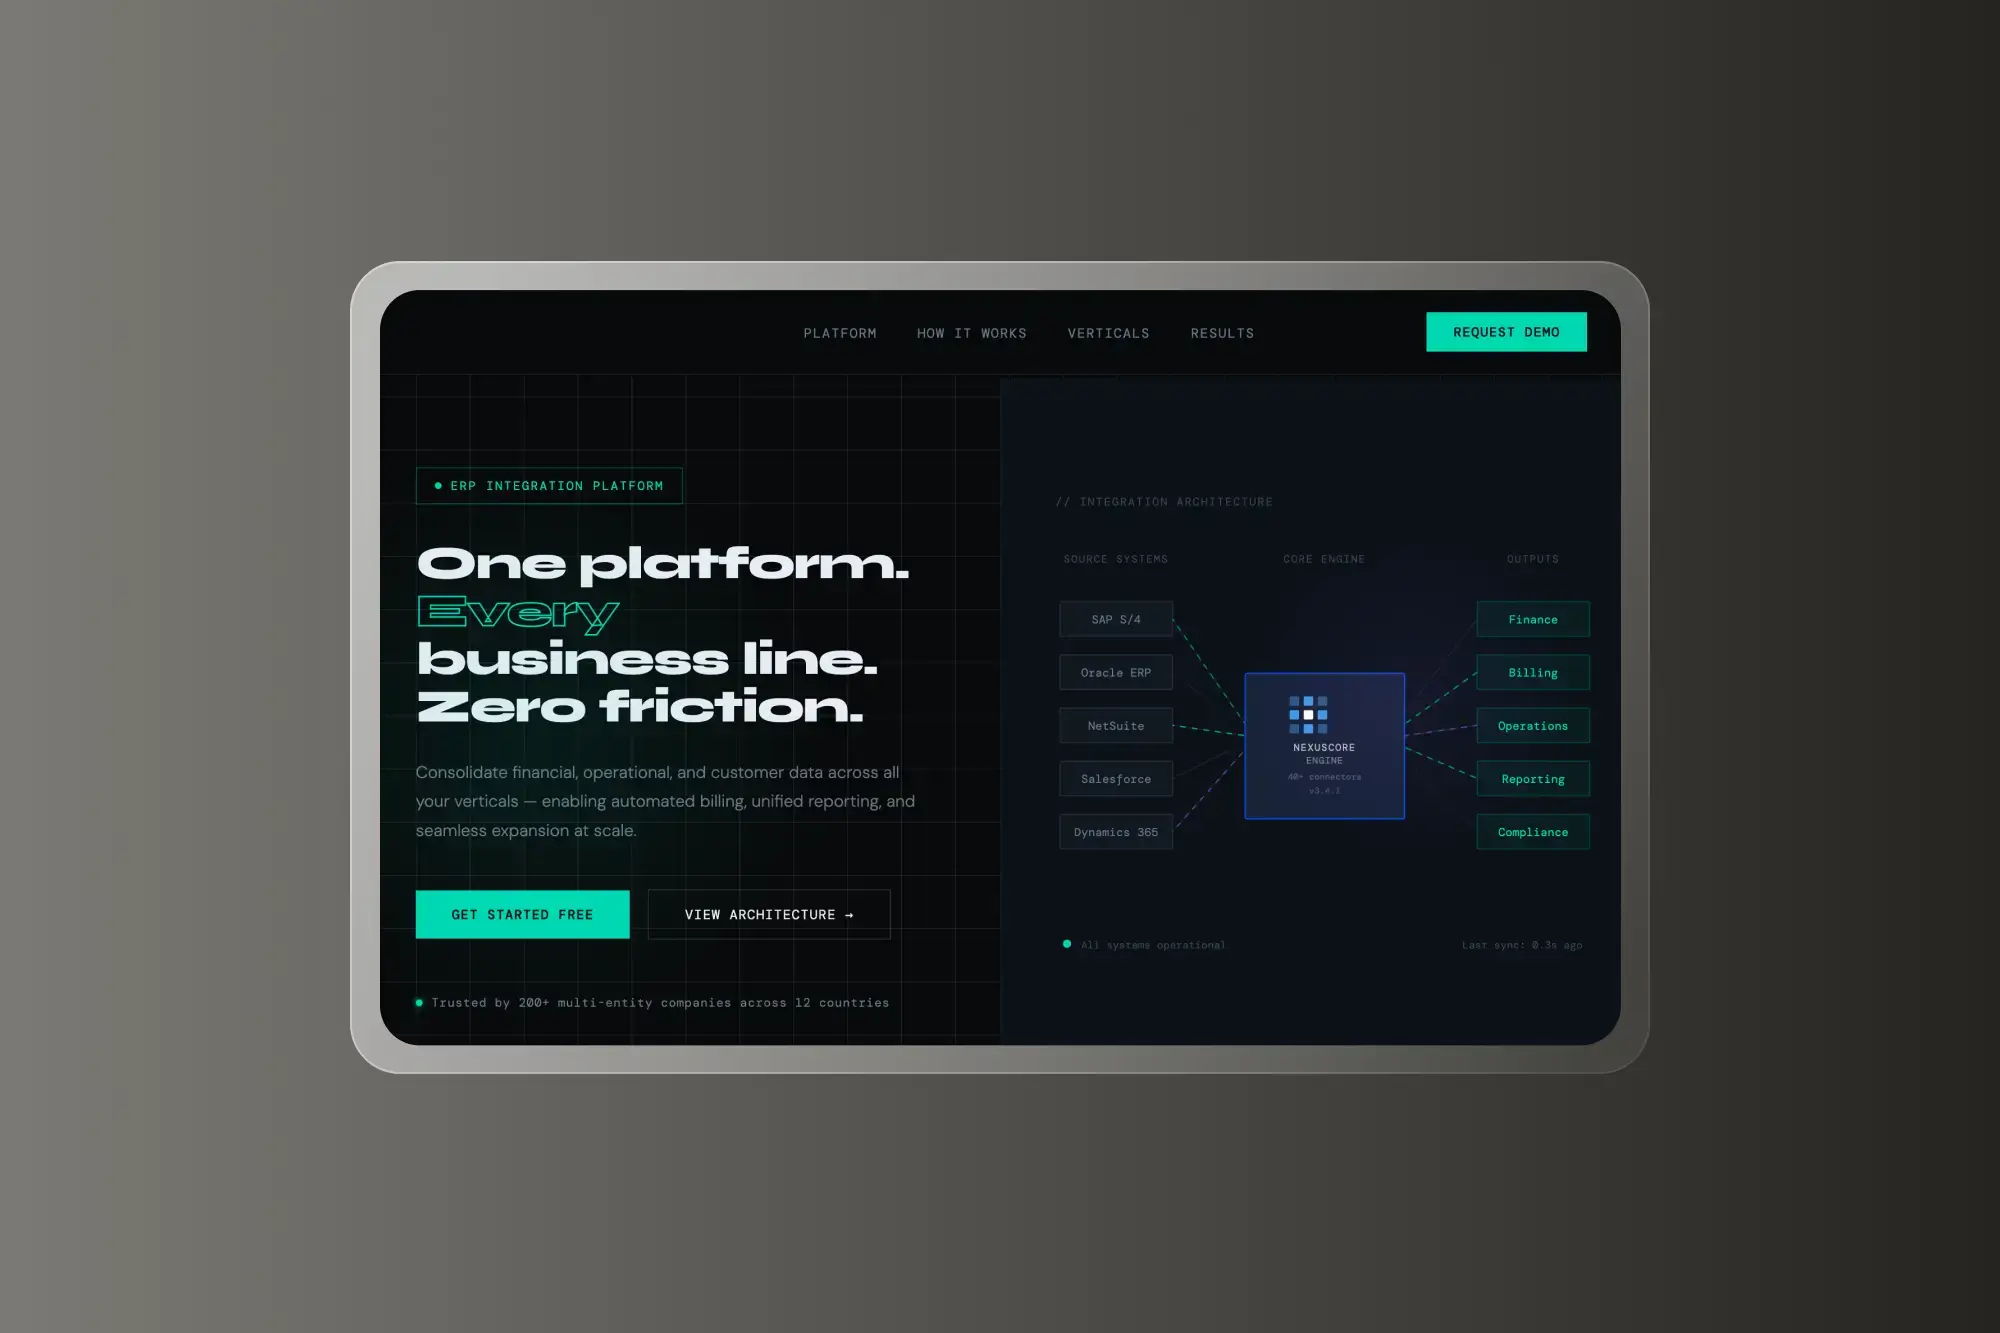
En samlet ERP-integrationsplatform, der konsoliderer finansielle, driftsmæssige og kundedata på tværs af...

Vi har bygget en AI-drevet analyseplatform, der er designet til at omdanne...
Send et oplæg, en specifikation eller tre sætninger om, hvor systemet er gået i stå. Én samtale er som regel nok til at afgøre, om vi passer til jer.
Skræddersyet software, AI og ML, data og analyse, cloud og sikkerhed — fra tidlig afklaring til langsigtet levering.
Dit privatliv er vigtigt. Vi bruger cookies til at forbedre din oplevelse og tilpasse indhold.


