
Finner du ikke din bransje? Start med en samtale.
Snakk med en AI-ekspertCrunch-IS i tall
- 170+
- eksperter
- 120+
- leverte prosjekter
- 40+
- aktive kunder
- 6+
- lokasjoner
- 8+
- års erfaring

Hjem / Datateknikktjenester
Datateknikktjenester
Vi designer og bygger datapipelines, plattformer og integrasjoner som yter under reelle produksjonsforhold — ved å bruke en AI-drevet utviklingstilnærming, skynative verktøy og strukturerte ingeniørpraksiser for å gjøre datainfrastrukturen din pålitelig, observerbar og klar til å støtte beslutninger i stor skala.
Fordeler med datateknikktjenester

Valideringskontroller, overvåkingsregler og automatiserte varsler holder dataene rene og konsistente i alle datapipelines. Teamet ditt slutter å avstemme rapporter manuelt og begynner å handle på resultater som allerede er verifisert.

Når datapipelines kjører pålitelig, og data er strukturert for tilgang, slutter analytikere og produktteam å vente på ingeniørarbeid. Tiden mellom et forretningsspørsmål og et pålitelig svar komprimeres betydelig.

Pipelines designet med skikkelig feilhåndtering, retry-logikk og observerbarhet krever langt mindre praktisk vedlikehold. Ingeniørinnsatsen flyttes fra brannslukking av ødelagte jobber til å bygge nye funksjoner.

Hver transformasjon er dokumentert, og hver kilde er kartlagt. Når et samsvarskrav eller et datakvalitetsproblem dukker opp, kan teamet ditt spore det direkte – uten å måtte rekonstruere pipelinen fra bunnen av.
Klar til å bygge datapipelines du kan stole på?
Datateknikktjenester vi tilbyr

Utvikling av datapipeline
Vi designer og bygger ETL- og ELT-pipelines som flytter data pålitelig fra kilde til destinasjon — som dekker strukturert innhenting, automatiserte transformasjoner, feilhåndtering og gjenopprettingslogikk. Hver pipeline testes mot realistiske feilscenarier før den når produksjon, og overvåking er innebygd fra starten.

Datamigreringstjenester
Vi håndterer migrasjoner fra eldre systemer, lokale databaser og sky-til-sky-miljøer. Oppdraget omfatter kildekartlegging, skjemaavstemming, datarensing, trinnvis overføringsutførelse og validering etter migrasjon opp mot avtalte akseptkriterier. Ingenting godkjennes basert på en enkelt omleggingshendelse.

Datateknikkrådgivning
Vi vurderer din nåværende dataarkitektur, identifiserer hvor mangler innen pålitelighet, ytelse, datalinje, sikkerhet eller vedlikeholdbarhet koster teamet ditt — i tid, risikoeksponering eller ingeniørmessig kostnad — og leverer et prioritert teknisk veikart. Konsulentoppdrag gir klar retning og kan gå direkte over i implementering dersom omfanget tilsier det.

Dataplattformutvikling
Vi designer og konfigurerer lagrings-, databehandlings- og tilgangslagene som pipelinene dine kjører på — inkludert oppsett av datavarehus og lakehouse på AWS, Azure, GCP, eller lokale miljøer, skjemadesign, lagringsoptimalisering og tilgangskontroll. Målet er en plattform teamet ditt kan drifte og utvide uten konstant involvering fra leverandøren.
Våre kapabiliteter
ETL/ELT-arkitektur og orkestrering
Vi designer og implementerer ETL- og ELT-arbeidsflyter, og velger riktig mønster basert på transformasjonens kompleksitet, latenskrav og plattformens egenskaper.
Sanntids- og batchbehandling
Vi bygger systemer som håndterer strømmedata sammen med batchbehandlingsarbeidsflyter for planlagte, høyvolumsbelastninger.
AI-drevet pipelineautomatisering
Vi integrerer AI-drevne komponenter i arbeidsflyter for datapipelines — automatisert avviksdeteksjon, intelligente varsler om skjemaendringer, selvreparerende logikk for nye forsøk, og LLM-assistert datatransformasjon for ustrukturerte eller semistrukturerte kilder.
Datakvalitet og observerbarhet
Vi implementerer skjemavalidering, kvalitetskontroller på radnivå, konsistensregler og avviksdeteksjon ved hjelp av rammeverk. Varsler utløses ved avvik før de forplanter seg nedstrøms.
Sikker dataarkitektur
Tilgangskontroller, kryptering i hvile og under overføring, revisjonslogging og rollebaserte tillatelser er innarbeidet i plattformarkitekturen i designfasen.
Hva du får

Omfang definert før bygging
Vurdering av datamiljø, kravene til datapipeline og akseptkriterier avtales før utviklingen starter. Du vet hva som bygges, hvordan det skal måles, og hvordan det ser ut når det er ferdig.

AI-akselerert leveranse av datateknikk
Vi integrerer AI-verktøy gjennom hele livssyklusen for datateknikk – fra pipelineoppsett og transformasjonslogikk til automatiserte kvalitetskontroller og overvåking etter lansering. Byggesykluser komprimeres uten å øke bemanningen.
Dokumentasjon teamet ditt kan jobbe ut fra
Pipeline-arkitektur, transformasjonslogikk, dataordbøker og plattformkonfigurasjon er dokumentert og overlevert som fungerende referansemateriale. Teamet ditt kan vedlikeholde, utvide og feilsøke systemet på egen hånd.

Overvåkingsperiode etter lansering
Hvert oppdrag inkluderer en definert overvåkingsperiode etter lansering. Hvis noe avviker etter go-live, er vi fortsatt ansvarlige — justeringer skjer før de blir til hendelser.
Hva kundene våre sier om oss
De kommer med mange skalerbare og ideer om beste praksis som gjør det mulig for oss å oppnå det vi har akkurat nå.
Crunch-IS var flinke til å vise oss hvordan gode løsninger bør se ut og gjøre ideene våre levende for evaluering og gjennomgang.

Det som imponerte meg mest ved Crunch-IS, er kvaliteten på utviklerne. Den er rett og slett mye bedre enn i noe annet selskap vi har prøvd å samarbeide med.

Vi er imponert over deres prestasjoner, hvordan de engasjerer seg i produktutviklingen, og hvordan de bryr seg om produktet.

Det har vært en veldig hyggelig opplevelse. Alt har vært fantastisk, både når det gjelder kommunikasjon og samarbeid.

Vårt samarbeid med Crunch-IS har vært en uvurderlig ressurs i takt med at vi har utvidet virksomheten.

Det jeg la merke til hos Crunch-IS, var teknisk kompetanse, evnen til å tenke utenfor boksen og svært gode engelskkunnskaper.

De har hatt en stor innvirkning på den endelige arkitekturen vi endte opp med. Totalt sett har jeg vært fornøyd og imponert over alt Crunch-IS har gjort for oss.

Crunch-IS imponerte oss med sin tekniske dyktighet og det rene «møtet mellom tanker og kulturer» samt den åpne og ærlige kommunikasjonen. Dette var ikke en beslutning vi tok på lett grunn, og fem måneder inn i samarbeidet er vi fortsatt svært imponert over hvordan Crunch-IS tilnærmer seg samarbeidet, og vi er svært fornøyde med kvaliteten på teamet vi jobber sammen med.

Det var enkelt å samarbeide med Crunch-IS. De viste tålmodighet overfor oss da vi gikk gjennom spørsmålene knyttet til kontrakten, og var tålmodige igjen da vi skulle få på plass faktureringsordningen. Designarbeidet var elegant, og utvikleren leverte appen vi hadde avtalt i tide og i god kvalitet.

Det var veldig hyggelig å samarbeide med teamet hos Crunch-IS. De jobbet flittig og var svært profesjonelle. Når det oppstod spørsmål eller tekniske problemer, svarte de raskt og var alltid villige og imøtekommende når det gjaldt å hjelpe oss.

En utvikler fra Crunch-IS hjalp oss med å levere en viktig funksjon til prosjektet vårt mye raskere enn forventet.

Crunch-IS sørget for et sømløst og samarbeidsorientert forløp gjennom hele prosjektet. Teamet opprettholdt åpen kommunikasjon, førte detaljerte oversikter over oppgavefordelingen og overholdt prosjektets tidsplaner. Deres kompetanse innen både design og utvikling gjør selskapet til noe helt spesielt.

Crunch-IS tilbyr løpende utviklingsstøtte som tilfredsstiller prosjektets behov etter behov. Til tross for at de befinner seg i utlandet, er de enkle å samarbeide med og lett tilgjengelige via kommunikasjonskanaler

Den beste leverandøren vi kunne tenke oss. Crunch-IS kombinerer praktisk utvikling med innovative designprinsipper. Tilbakemeldingene på apputviklingen, både internt og eksternt, har vært positive. De fullfører prosjektmilepælene i henhold til tidsplanen og leverer innenfor budsjettet. Teamet er imøtekommende og villig til å delta i en produktiv dialog.

Crunch-IS overgikk mine forventninger. Jeg satte stor pris på utviklernes oppfinnsomhet i møte med begrensninger og komplekse krav. Selskapet klarte å levere og fullføre prosjektet på en vellykket måte.

Prosjektet har hittil forløpt uten problemer. Crunch-IS har en enestående arbeidsmoral. Takket være dette har de klart å takle alle utfordringer som har dukket opp. De håndterer det daglige arbeidet godt på egen hånd, men kommuniserer også jevnlig med oss for å sikre at vi er på samme bølgelengde.

Appen som Crunch-IS har utviklet, er oversiktlig, strømlinjeformet og fungerer som den skal. Crunch-IS går langt utover det forventede for å sikre at begge teamene er på bølgelengde. Det engasjerte teamet skaper en hyggelig opplevelse gjennom sin positive holdning og effektive prosjektledelsesferdigheter. Teamet var svært vennlig, og det var en glede å samarbeide med dem.

Hvorfor velge Crunch-IS som din partner

Vi designer for produksjonsforhold
De fleste feil i datapipelinen oppstår i gapet mellom testdata og reelle driftsbelastninger. Vi bygger og validerer mot datamengdene, skjemavariasjonene og kildeinkonsistensene som systemet ditt faktisk vil møte.

AI-drevet ingeniørarbeid
Vi bruker AI for å løse reelle ingeniørproblemer: automatisert avviksdeteksjon, intelligent skjemaovervåking, LLM-assistert transformasjon av ustrukturerte data og AI-drevet diagnostikk av datapipelines.

Datamigreringer er en kjernepraksis, ikke et spesialtilfelle
Migreringer mislykkes når team behandler dem som en enkelt overgangshendelse. Vi kjører dem i kontrollerte faser – forhåndsrevisjon før migrering, parallell validering, akseptansetestet overføring, avstemmingsgodkjenning.
Vanlige spørsmål om datateknikktjenester
Hva er dataingeniørarbeid?
Dataingeniørarbeid er disiplinen som handler om å designe, bygge og vedlikeholde infrastrukturen som gjør rådata brukbare. Dette omfatter å bygge datapipelines som samler inn data fra flere kilder, transformerer dem til konsistente formater, lagrer dem i strukturer som støtter analyse, og holder hele systemet i pålitelig drift i stor skala. Dataforskere, analytikere og produktteam er alle avhengige av denne infrastrukturen — når den er solid, jobber alle raskere; når den ikke er det, merker hele organisasjonen det.
Hva er forskjellen mellom dataingeniørfag og datavitenskap?
Dataingeniørfaget bygger systemene som samler inn, renser og leverer data i en brukbar tilstand. Datavitenskap jobber med disse dataene for å kjøre analyser, bygge modeller og generere prediksjoner. De er avhengige av hverandre: datavitenskap produserer bare pålitelige resultater når den underliggende infrastrukturen er solid. I de fleste organisasjoner er den raskeste måten å forbedre analytisk output på, å forbedre kvaliteten på dataingeniørarbeidet først.
Hvordan håndterer dere datamigreringer uten å forstyrre driften?
Vi gjennomfører migreringer i faser. Den første fasen er en fullstendig revisjon av kildemiljøet — skjemakartlegging, vurdering av datakvalitet og identifisering av mangler. Vi utfører overføringer i kontrollerte partier, med valideringskontrollpunkter ved hver fase, og kjører parallelle miljøer ved behov for å bekrefte resultatet før kilden tas ut av drift. Etter migreringen kjører vi avstemmingskontroller mot avtalte akseptkriterier. Ingenting godkjennes basert på en enkelt overgang.
Hvilke datakilder kan dere integrere?
De fleste relasjonsdatabaser (PostgreSQL, MySQL, SQL Server, Oracle), skylagring (S3, Azure Blob, GCS), SaaS-API-er (Salesforce, HubSpot, Stripe og lignende), meldingskøer (Kafka, Kinesis, RabbitMQ), flate filer (CSV, JSON, Parquet), og eldre systemer med egendefinerte protokoller. Integrasjonstilnærmingen — direkte koblinger, egendefinerte Python-ekstraktorer, eller administrerte verktøy som Fivetran — velges basert på pålitelighetskrav og vedlikeholdskostnader.
Hvordan håndterer dere sikkerhet og samsvar i datapipelines?
Tilgangskontroller, kryptering og revisjonslogging er innebygd i plattformarkitekturen under designfasen. Rollebaserte tillatelser begrenser hvem som kan lese eller endre hvert datasett. Data under overføring krypteres; data i hvile bruker plattformnative krypteringsmekanismer på AWS, Azure eller GCP. For regulerte miljøer dokumenterer vi datahåndteringspraksis opp mot GDPR-, HIPAA- eller SOC 2-krav og kan levere arkitekturdokumentasjon for samsvarsgjennomgang.
Hvordan brukes Python i dataingeniørarbeid?
Python er standardspråket for dataingeniørarbeid på grunn av sitt robuste økosystem. Apache Airflow – det mest brukte rammeverket for orkestrering av datapipelines – er Python-nativt. PySpark håndterer distribuert databehandling i stor skala. dbt integreres med Python for testing og transformasjonsarbeidsflyter. Pandas og SQLAlchemy dekker uttrekking, transformasjon og databasetilkobling.
Crunch-IS Suksesshistorier
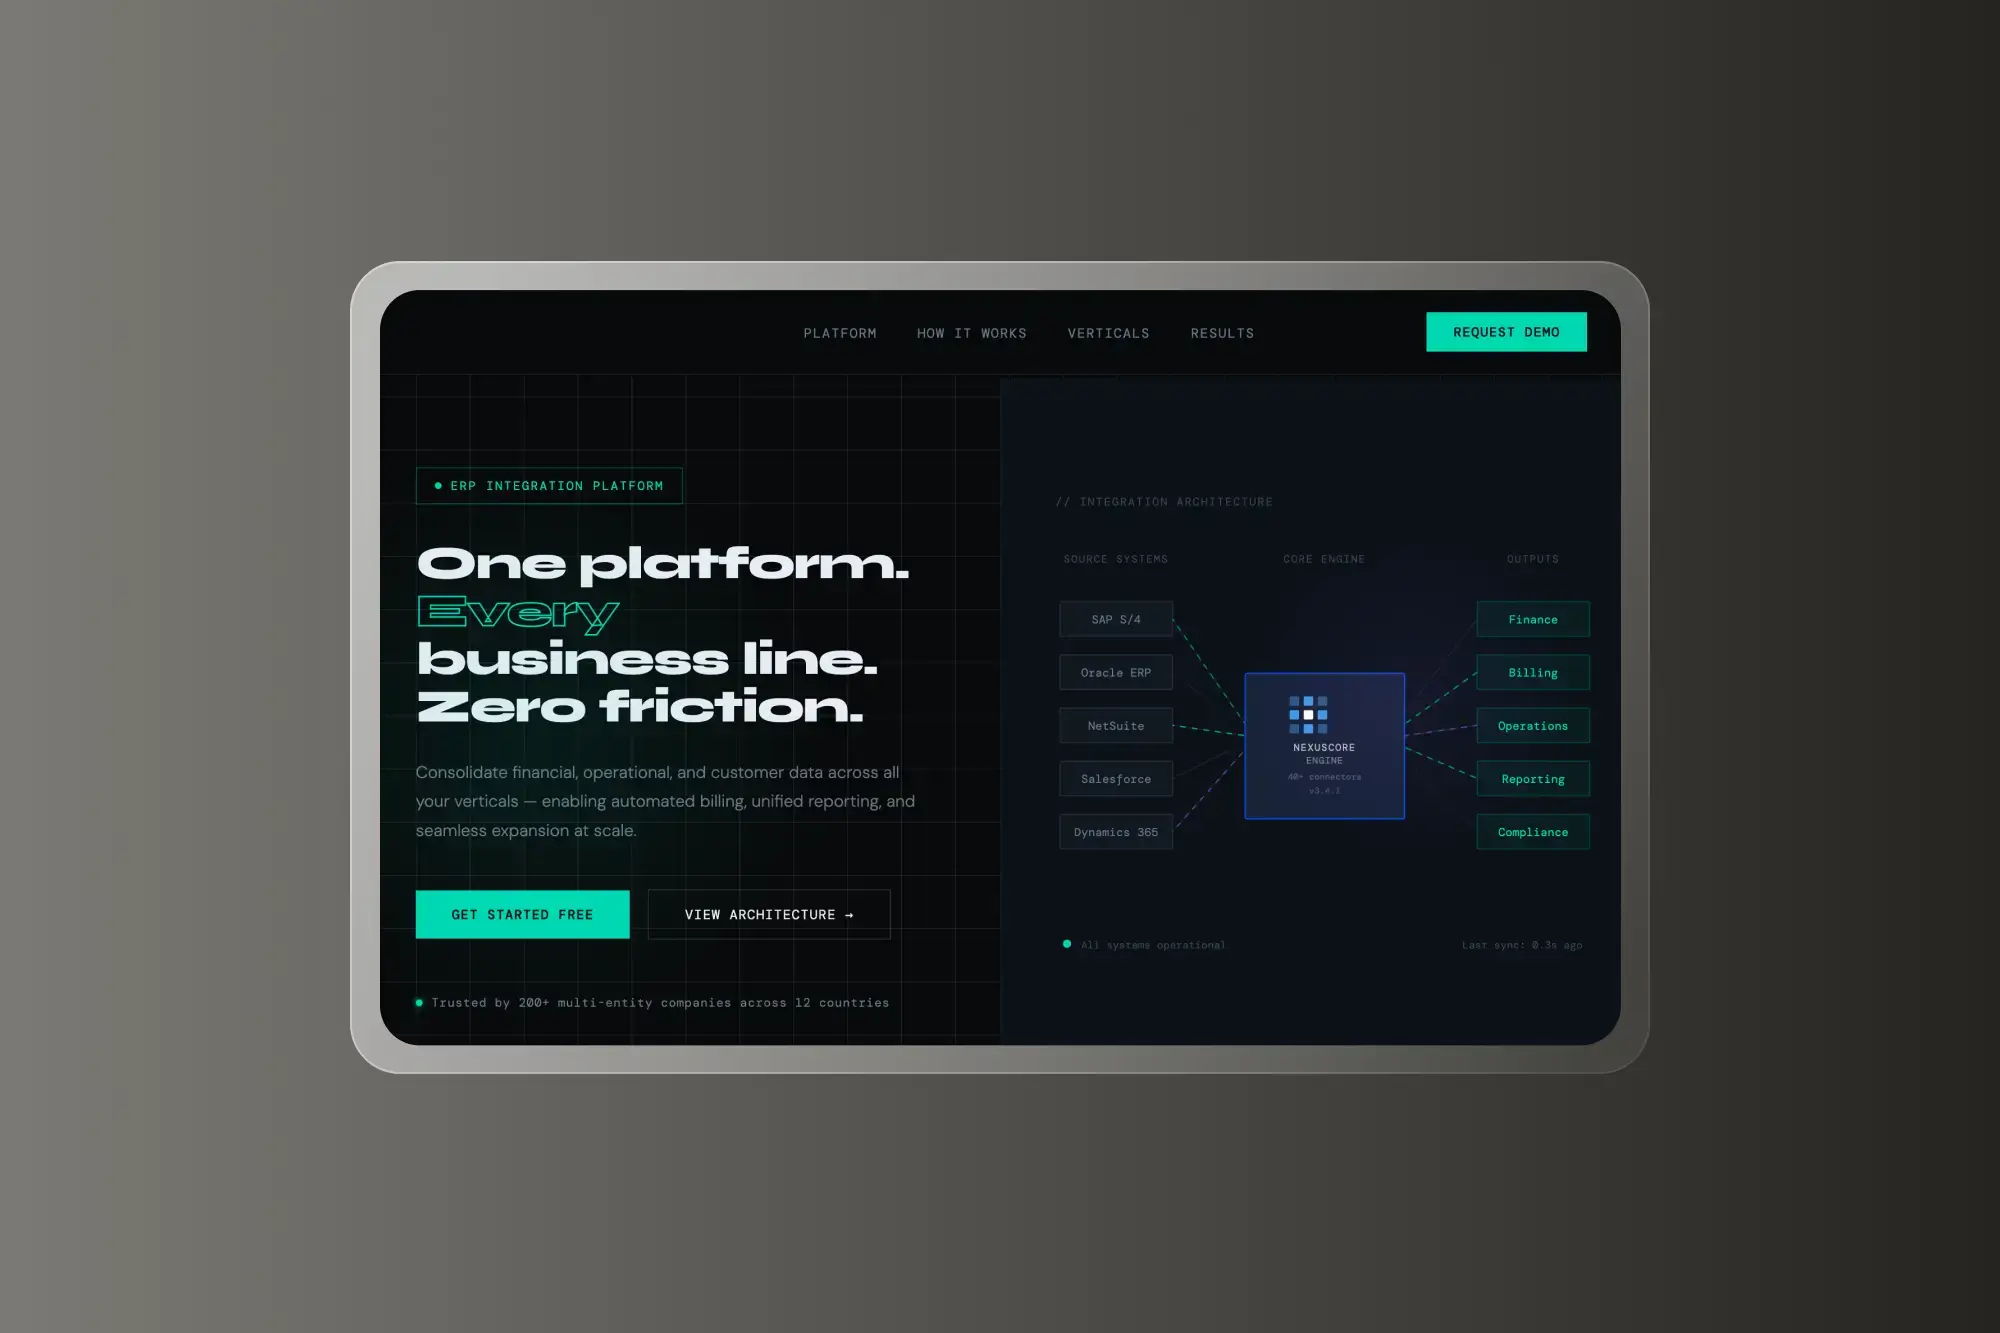
En enhetlig ERP-integrasjonsplattform som konsoliderer finansielle, operasjonelle og kundedata på tvers av...

Vi bygde en AI-drevet analyseplattform designet for å transformere ustrukturerte finansielle og...
Hold deg oppdatert med de siste trendene
Fortell oss hva du bygger
Send en skisse, en spesifikasjon eller tre setninger om hvor systemet har stoppet opp. Vanligvis er én samtale nok til å finne ut om vi er det rette valget for deg.
Skreddersydd programvare, AI og ML, data og analyse, sky og sikkerhet – fra tidlig prosjektavgrensning til langsiktig levering.
- 170+ eksperter
- 120+ leverte prosjekter
- 97% helt fornøyde


