
Hittar du inte din bransch? Börja med ett samtal.
Prata med en AI-expertCrunch-IS i siffror
- 170+
- experter
- 120+
- levererade projekt
- 40+
- aktiva kunder
- 6+
- platser
- 8+
- års erfarenhet

Hem / Datatekniktjänster
Datatekniktjänster
Vi designar och bygger datapipelines, plattformar och integrationer som presterar under verkliga produktionsförhållanden — med ett AI-drivet utvecklingssätt, molnbaserade verktyg och strukturerade ingenjörsmetoder för att göra din datainfrastruktur pålitlig, observerbar och redo att stödja beslut i stor skala.
Fördelar med datatekniktjänster

Valideringskontroller, övervakningsregler och automatiska varningar håller data ren och konsekvent i varje pipeline. Ditt team slutar stämma av rapporter manuellt och börjar agera på resultat som redan är verifierade.

När pipelines körs tillförlitligt, och data är strukturerad för åtkomst, slutar analytiker och produktteam att vänta på ingenjörsteamet. Tiden mellan en affärsfråga och ett tillförlitligt svar komprimeras avsevärt.

Pipelines som är utformade med korrekt felhantering, omförsökslogik och observerbarhet kräver betydligt mindre praktiskt underhåll. Ingenjörsarbetet förskjuts från att släcka bränder med trasiga jobb till att bygga nya funktioner.

Varje transformation dokumenteras, och varje källa kartläggs. När ett efterlevnadskrav eller ett datakvalitetsproblem uppstår kan ditt team spåra det direkt — utan att behöva bakåtkonstruera pipelinen från grunden.
Redo att bygga datapipelines du kan lita på?
Datatekniktjänster vi erbjuder

Utveckling av datapipeline
Vi designar och bygger ETL- och ELT-pipelines som flyttar data tillförlitligt från källa till destination — vilket omfattar strukturerad datainmatning, automatiserade transformationer, felhantering och återställningslogik. Varje pipeline testas mot realistiska felscenarier innan den når produktion, och övervakning är inbyggd från början.

Datamigreringstjänster
Vi hanterar migreringar från äldre system, lokala databaser och moln-till-moln-miljöer. Uppdraget omfattar källkartläggning, schemaavstämning, datarensning, stegvis överföringsutförande och validering efter migrering mot överenskomna acceptanskriterier. Inget godkänns vid en enda övergångshändelse.

Konsulttjänster inom datateknik
Vi utvärderar din nuvarande dataarkitektur, identifierar var brister i tillförlitlighet, prestanda, datahärkomst (lineage), säkerhet eller underhållbarhet kostar ditt team — i tid, riskexponering eller ingenjörsmässig omkostnad — och levererar en prioriterad teknisk färdplan. Konsultuppdrag ger tydlig riktning och kan övergå direkt till implementering om omfattningen motiverar det.

Utveckling av dataplattformar
Vi designar och konfigurerar lagrings-, beräknings- och åtkomstlagren som dina pipelines körs ovanpå — inklusive uppsättning av warehouse och lakehouse på AWS, Azure, GCP, eller lokala miljöer, schemadesign, lagringsoptimering och åtkomstkontroll. Målet är en plattform som ditt team kan driva och utöka utan ständig inblandning från leverantören.
Våra förmågor
ETL/ELT-arkitektur och orkestrering
Vi designar och implementerar ETL- och ELT-arbetsflöden och väljer rätt mönster baserat på transformationskomplexitet, latenskrav och plattformsegenskaper.
Realtids- och batchbearbetning
Vi bygger system som hanterar strömmande data tillsammans med batchbearbetningsflöden för schemalagda laddningar med hög volym.
AI-driven pipeline-automatisering
Vi integrerar AI-drivna komponenter i arbetsflöden för datapipelines — automatiserad avvikelsedetektering, intelligenta varningar för schemaförändringar, självläkande omförsökslogik och LLM-assisterad datatransformering för ostrukturerade eller semistrukturerade källor.
Datakvalitet och observerbarhet
Vi implementerar schemavalidering, kvalitetskontroller på radnivå, konsekvensregler och avvikelsedetektering med hjälp av ramverk. Larm utlöses vid avvikelser innan de sprids nedströms.
Säker dataarkitektur
Åtkomstkontroller, kryptering i vila och under överföring, granskningsloggning och rollbaserade behörigheter integreras i plattformens arkitektur under designfasen.
Vad du får

Omfattning definierad före bygget
Datamiljöbedömning, pipeline-krav och acceptanskriterier överenskommes innan utvecklingen påbörjas. Du vet vad som byggs, hur det kommer att mätas och hur det ser ut när det är klart.

AI-accelererad leverans av datateknik
Vi integrerar AI-verktyg genom hela livscykeln för dataingenjörskonst – från pipeline-uppbyggnad och transformationslogik till automatiserade kvalitetskontroller och övervakning efter lansering. Byggcyklerna komprimeras utan att öka personalstyrkan.
Dokumentation som ditt team kan arbeta utifrån
Pipeline-arkitektur, transformationslogik, dataordböcker och plattformskonfiguration dokumenteras och överlämnas som fungerande referensmaterial. Ditt team kan underhålla, utöka och felsöka systemet på egen hand.

Övervakningsperiod efter lansering
Varje uppdrag inkluderar en definierad övervakningsperiod efter lansering. Om något driver iväg efter driftsättning är vi fortfarande ansvariga — justeringar sker innan de blir incidenter.
Vad våra kunder säger om oss
De kommer med många skalbara och idéer om bästa praxis som gör det möjligt för oss att uppnå det vi har i dag.
Crunch-IS var mycket bra på att visa oss hur bra lösningar ska se ut och ge liv åt våra idéer för utvärdering och granskning.

Det som imponerade på mig med Crunch-IS är kvaliteten på utvecklarna. Den är helt enkelt mycket bättre än i något annat företag vi har försökt samarbeta med.

Vi är imponerade av deras prestationer, hur de är engagerade i produktutvecklingen och hur de bryr sig om produkten.

Det har varit en mycket trevlig upplevelse. Allt har varit fantastiskt när det gäller kommunikation och samarbete.

Vårt samarbete med Crunch-IS har varit en ovärderlig resurs när vi har skalat upp.

Det jag fann hos Crunch-IS var den tekniska kompetensen, förmågan att tänka utanför boxen och mycket god engelska.

De har haft stor inverkan på hela den arkitektur vi slutligen fick. På det hela taget har jag varit nöjd och imponerad av allt Crunch-IS gjorde för oss.

Crunch-IS imponerade på oss med sin tekniska skicklighet och det rena ”mötet mellan tankar och kulturer” samt öppna, ärliga samtal. Detta var inget beslut vi tog lättvindigt, och fem månader in i samarbetet är vi fortsatt mycket imponerade av hur Crunch-IS närmar sig samarbetet, och vi är mycket nöjda med kvaliteten på teamet som arbetar med oss.

Det var enkelt att arbeta med Crunch-IS. De var tålmodiga med oss när vi gick igenom avtalsfrågorna och tålmodiga igen när vi satte upp faktureringen. Designarbetet var elegant och utvecklaren levererade appen vi hade avtalat om i tid och med god kvalitet.

Teamet på Crunch-IS var mycket trevligt att arbeta med. De arbetade flitigt och var mycket professionella. När frågor eller tekniska problem uppstod svarade de snabbt och var alltid redo och vänliga med att hjälpa oss.

En utvecklare från Crunch-IS hjälpte oss att leverera en viktig funktion till vårt projekt mycket snabbare än väntat.

Crunch-IS möjliggjorde ett sömlöst och samarbetsinriktat arbete genom hela projektet. Teamet höll öppna kommunikationskanaler, förde detaljerade anteckningar över uppgiftsfördelningen och höll projektets tidsplaner. Deras expertis inom både design och utveckling gör företaget unikt.

Crunch-IS tillhandahåller löpande utvecklingsstöd som möter projektets krav vid behov. Trots att de sitter utomlands är de lätta att arbeta med och tillgängliga via kommunikationskanaler

Den bästa leverantör vi kunde hitta. Crunch-IS kombinerar praktisk utveckling med innovativa designprinciper. Både intern och extern återkoppling på apputvecklingen har varit positiv. De slutför projektets milstolpar enligt planerad tidsplan och levererar inom budget. Teamet’ är lyhört och villigt att föra en produktiv dialog.

Crunch-IS överträffade mina förväntningar. Jag uppskattade utvecklarnas uppfinningsrikedom inför begränsningar och komplexa krav. Företaget kunde leverera och slutföra projektet framgångsrikt.

Projektet har hittills gått smidigt. Crunch-IS har en enastående arbetsmoral. Tack vare det har de’ kunnat hantera varje utmaning som dykt upp. De sköter det dagliga arbetet bra på egen hand men kommunicerar också regelbundet med oss för att säkerställa att vi’ är överens.

Appen som Crunch-IS arbetade på är ren, strömlinjeformad och fungerar som avsett. Crunch-IS gör mer än väntat för att säkerställa att båda teamen är samspelta. Det engagerade teamet skapar en trevlig upplevelse genom sitt positiva bemötande och effektiva projektledning. Teamet var mycket vänligt och det var ett nöje att arbeta med dem.

Varför välja Crunch-IS som din partner

Vi designar för produktionsförhållanden
De flesta pipeline-fel uppstår i glappet mellan testdata och verkliga driftsbelastningar. Vi bygger och validerar mot de datavolymer, schemavariationer och källinkonsekvenser som ditt system faktiskt kommer att möta.

AI-driven ingenjörskonst
Vi använder AI för att lösa verkliga tekniska problem: automatiserad avvikelsedetektering, intelligent schemaövervakning, LLM-assisterad transformering av ostrukturerad data och AI-driven diagnostik av pipelines.

Datamigreringar är en central praxis, inte ett undantagsfall
Migreringar misslyckas när team behandlar dem som en enda övergångshändelse. Vi genomför dem i kontrollerade steg — granskning före migrering, parallell validering, acceptanstestad överföring, avstämningsgodkännande.
Vanliga frågor om datatekniktjänster
Vad är data engineering?
Data engineering är disciplinen att designa, bygga och underhålla den infrastruktur som gör rådata användbar. Detta inkluderar att bygga pipelines som samlar in data från flera källor, omvandlar den till konsekventa format, lagrar den i strukturer som stöder analys och håller hela systemet igång tillförlitligt i stor skala. Dataforskare, analytiker och produktteam är alla beroende av denna infrastruktur — när den är stabil arbetar alla snabbare; när den inte är det känner hela organisationen av det.
Vad är skillnaden mellan datateknik och datavetenskap?
Data engineering bygger de system som samlar in, rensar och levererar data i ett användbart tillstånd. Data science arbetar med den datan för att köra analyser, bygga modeller och generera förutsägelser. De är beroende av varandra: data science ger endast tillförlitliga resultat när den underliggande infrastrukturen är sund. I de flesta organisationer är det snabbaste sättet att förbättra analytisk output att först förbättra kvaliteten på data engineering.
Hur hanterar ni datamigreringar utan att störa verksamheten?
Vi genomför migreringar i etapper. Den första fasen är en fullständig granskning av källmiljön – schemamappning, bedömning av datakvalitet och identifiering av luckor. Vi utför överföringar i kontrollerade omgångar, med valideringskontrollpunkter i varje steg, och kör parallella miljöer vid behov för att bekräfta resultatet innan källan avvecklas. Efter migreringen kör vi avstämningskontroller mot överenskomna acceptanskriterier. Ingenting godkänns vid en enda övergång.
Vilka datakällor kan ni integrera?
De flesta relationsdatabaser (PostgreSQL, MySQL, SQL Server, Oracle), molnlagring (S3, Azure Blob, GCS), SaaS-API:er (Salesforce, HubSpot, Stripe och liknande), meddelandeköer (Kafka, Kinesis, RabbitMQ), platta filer (CSV, JSON, Parquet) och äldre system med anpassade protokoll. Integrationsmetoden – direkta anslutningar, anpassade Python-extraktorer eller hanterade verktyg som Fivetran – väljs utifrån tillförlitlighetskrav och underhållsbörda.
Hur hanterar ni säkerhet och efterlevnad i datapipelines?
Åtkomstkontroller, kryptering och granskningsloggning är inbyggda i plattformens arkitektur under designfasen. Rollbaserade behörigheter begränsar vem som kan läsa eller ändra varje dataset. Data under överföring krypteras; data i vila använder plattformens inbyggda krypteringsmekanismer på AWS, Azure eller GCP. För reglerade miljöer dokumenterar vi datahanteringspraxis mot GDPR-, HIPAA- eller SOC 2-krav och kan tillhandahålla arkitekturdokumentation för efterlevnadsgranskning.
Hur används Python inom datateknik?
Python är standardspråket för datateknik tack vare sitt robusta ekosystem. Apache Airflow – det mest använda ramverket för orkestrering av pipelines – är Python-baserat. PySpark hanterar distribuerad databehandling i stor skala. dbt integreras med Python för test- och transformationsarbetsflöden. Pandas och SQLAlchemy täcker extrahering, transformation och databasanslutning.
Crunch-IS Framgångshistorier
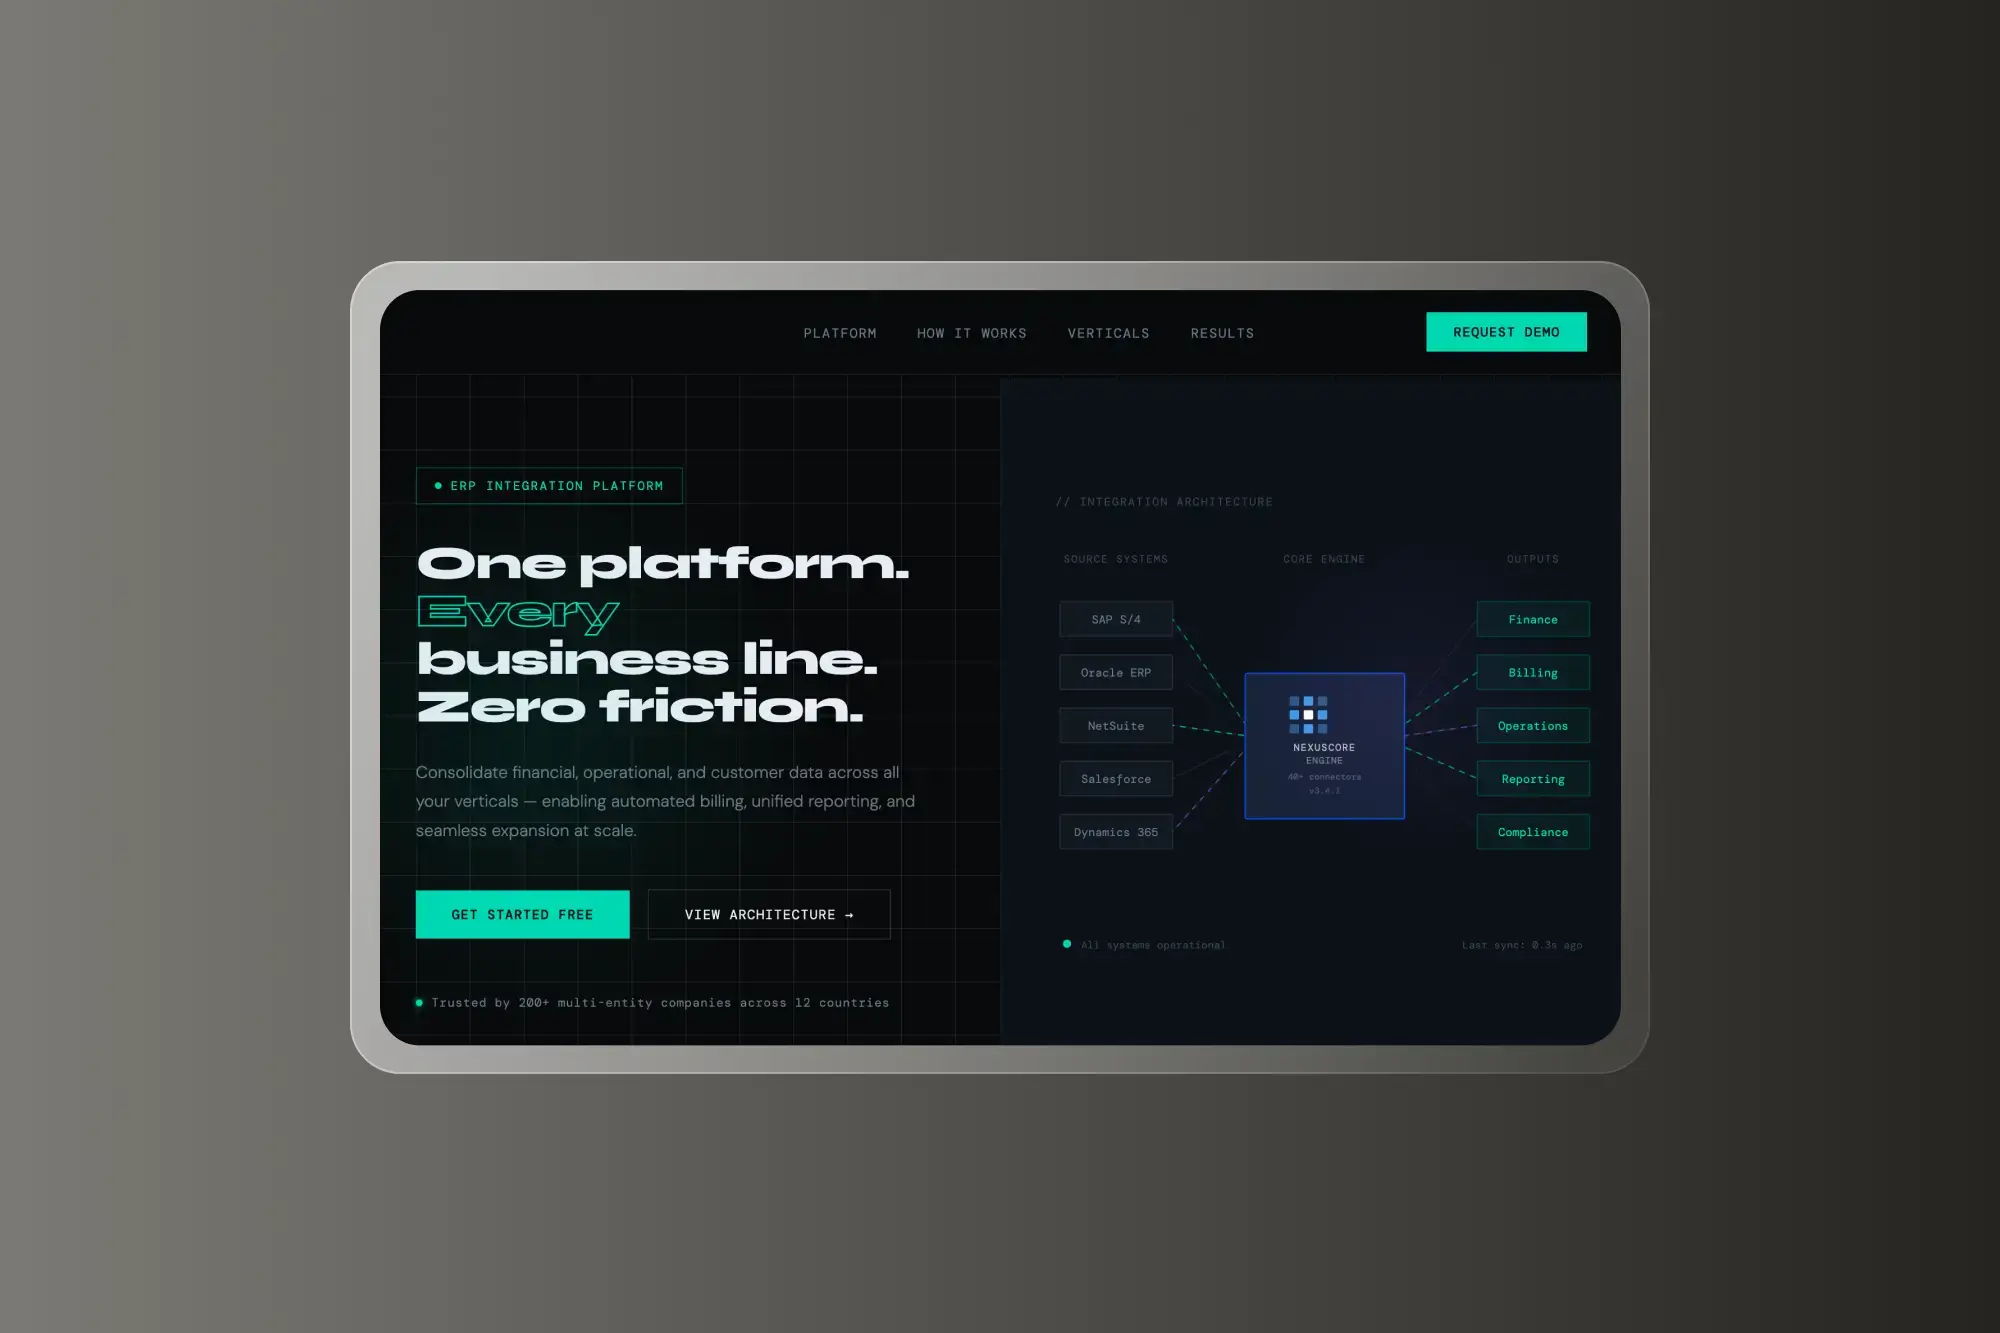
En enhetlig ERP-integrationsplattform som konsoliderar finansiella, operativa och kunddata över flera affärsområden...

Vi byggde en AI-driven analysplattform utformad för att omvandla ostrukturerad finansiell och...
Håll dig uppdaterad med de senaste trenderna
Berätta vad ni bygger
Skicka en skiss, en kravspecifikation eller tre meningar om var systemet har kört fast. Ett samtal räcker oftast för att avgöra om vi passar er.
Skräddarsydd mjukvara, AI och ML, data och analys, moln och säkerhet — från tidig behovsanalys till långsiktig leverans.
- 170+ experter
- 120+ levererade projekt
- 97% helt nöjda


