
Staat uw branche er niet bij? Begin met een gesprek.
Praat met een AI-expertCrunch-IS in cijfers
- 170+
- experts
- 120+
- opgeleverde projecten
- 40+
- actieve klanten
- 6+
- locaties
- 8+
- jaar ervaring

Home / Data engineering
Data engineering
Wij ontwerpen en bouwen datapipelines, platformen en koppelingen die in echte productieomstandigheden presteren — met een AI-gedreven ontwikkelaanpak, cloud-native tooling en gestructureerde engineeringpraktijken, zodat uw data-infrastructuur betrouwbaar en inzichtelijk is en beslissingen op schaal ondersteunt.
Voordelen van data engineering

Validatiecontroles, monitoringregels en automatische meldingen houden data schoon en consistent in elke pipeline. Uw team stopt met het handmatig verzoenen van rapportages en handelt op resultaten die al geverifieerd zijn.

Als pipelines betrouwbaar draaien en data goed toegankelijk is gestructureerd, hoeven analisten en productteams niet meer op engineering te wachten. De tijd tussen een bedrijfsvraag en een betrouwbaar antwoord wordt fors korter.

Pipelines met goede foutafhandeling, retrylogica en observability vragen veel minder handmatig onderhoud. De inspanning verschuift van brandjes blussen naar het bouwen van nieuwe mogelijkheden.

Elke transformatie is gedocumenteerd en elke bron is in kaart gebracht. Duikt er een compliance-eis of kwaliteitsprobleem op, dan kan uw team dat direct herleiden — zonder de pipeline opnieuw te moeten uitpluizen.
Klaar om datapipelines te bouwen waarop u kunt vertrouwen?
Onze data engineering diensten

Ontwikkeling van datapipelines
Wij ontwerpen en bouwen ETL- en ELT-pipelines die data betrouwbaar van bron naar bestemming brengen — met gestructureerde inname, automatische transformaties, foutafhandeling en herstellogica. Elke pipeline wordt tegen realistische faalscenario’s getest voordat hij in productie komt, en monitoring zit er vanaf het begin in.

Datamigratie
Wij verzorgen migraties vanaf legacysystemen, on-premise databases en van cloud naar cloud. Het traject omvat bronmapping, schemaverzoening, dataopschoning, gefaseerde overdracht en validatie achteraf tegen afgesproken acceptatiecriteria. Niets wordt afgetekend op basis van één cutovermoment.

Data engineering advies
Wij beoordelen uw huidige data-architectuur, bepalen waar hiaten in betrouwbaarheid, prestaties, herkomst, beveiliging of onderhoudbaarheid uw team iets kosten — in tijd, risico of beheerlast — en leveren een geprioriteerde technische roadmap. Adviestrajecten geven heldere richting en kunnen direct overgaan in implementatie als de scope dat rechtvaardigt.

Data platform engineering
Wij ontwerpen en configureren de opslag-, reken- en toegangslagen waarop uw pipelines draaien — inclusief het inrichten van warehouses en lakehouses op AWS, Azure, GCP of on-premise, schemaontwerp, opslagoptimalisatie en toegangsbeheer. Het doel is een platform dat uw team zelf kan beheren en uitbreiden zonder telkens een leverancier nodig te hebben.
Onze mogelijkheden
ETL/ELT-architectuur en orkestratie
Wij ontwerpen en implementeren ETL- en ELT-processen en kiezen het juiste patroon op basis van de complexiteit van de transformatie, latentie-eisen en platformkenmerken.
Realtime en batchverwerking
Wij bouwen systemen die streaming data aankunnen naast batchprocessen voor geplande, omvangrijke ladingen.
AI-gedreven pipelineautomatisering
Wij integreren AI-componenten in datapipelines — automatische anomaliedetectie, slimme meldingen bij schemadrift, zelfherstellende retrylogica en LLM-ondersteunde transformatie van ongestructureerde of semi-gestructureerde bronnen.
Datakwaliteit en observability
Wij implementeren schemavalidatie, kwaliteitscontroles op rijniveau, consistentieregels en anomaliedetectie. Meldingen gaan af bij afwijkingen voordat die verderop doorwerken.
Veilige data-architectuur
Toegangsrechten, encryptie in rust en tijdens transport, audit logging en rolgebaseerde permissies worden tijdens het ontwerp in de platformarchitectuur opgenomen.
Wat u krijgt

Scope vastgelegd vóór de bouw
Beoordeling van uw dataomgeving, pipeline-eisen en acceptatiecriteria worden afgesproken voordat de ontwikkeling begint. U weet wat er gebouwd wordt, hoe het wordt gemeten en wanneer het af is.

AI-versnelde data engineering
Wij zetten AI-tooling in over de volledige data engineering-cyclus — van het opzetten van pipelines en transformatielogica tot automatische kwaliteitscontroles en monitoring na de lancering. Bouwcycli worden korter zonder extra mensen.
Documentatie waar uw team mee werkt
Pipelinearchitectuur, transformatielogica, datawoordenboeken en platformconfiguratie worden gedocumenteerd en overgedragen als werkbaar naslagmateriaal. Uw team kan het systeem zelf onderhouden, uitbreiden en problemen erin oplossen.

Monitoringperiode na de lancering
Elk traject bevat een vastgelegde monitoringperiode na de lancering. Loopt er iets uit de pas na go-live, dan zijn wij daar nog verantwoordelijk voor — aanpassingen gebeuren voordat het incidenten worden.
Wat onze klanten over ons zeggen
Ze komen met veel schaalbare en best-practice-ideeën waarmee wij konden bereiken wat we nu hebben.
Crunch-IS was uitstekend in het laten zien van hoe goed eruit hoort te zien en in het tot leven brengen van onze ideeën voor evaluatie en beoordeling.

Wat mij aan Crunch-IS is bijgebleven, is de kwaliteit van de ontwikkelaars. Die is simpelweg veel beter dan bij elk ander bedrijf waarmee we hebben geprobeerd samen te werken.

We zijn onder de indruk van hun prestaties, van hoe ze betrokken zijn bij de productontwikkeling en van hoe ze om het product geven.

Het is een heel plezierige ervaring geweest. Alles is fantastisch verlopen op het vlak van communiceren en samenwerken.

Onze samenwerking met Crunch-IS is een onmisbare hulpbron geweest terwijl wij opschaalden.

Wat ik bij Crunch-IS aantrof, was de technische competentie, het vermogen om buiten de gebaande paden te denken en heel goed Engels.

Ze hebben een grote invloed gehad op de hele architectuur waarmee we uiteindelijk zijn uitgekomen. Al met al ben ik tevreden over en onder de indruk van alles wat Crunch-IS voor ons heeft gedaan.

Crunch-IS maakte indruk op ons met hun technische excellentie en met de echte ontmoeting van denkwijzen en culturen en open, eerlijke uitwisselingen. Dit was geen besluit dat we lichtvaardig namen, en vijf maanden na de start zijn we nog steeds erg onder de indruk van hoe Crunch-IS de samenwerking aanpakt. We zijn blij met het niveau van het team dat voor ons werkt.

Werken met Crunch-IS ging makkelijk. Ze waren geduldig toen we de contractvragen doorliepen en opnieuw geduldig toen we onze facturatie inrichtten. Het ontwerpwerk was elegant en de ontwikkelaar leverde de app waarvoor we hadden getekend op tijd en van goede kwaliteit.

Het was heel prettig samenwerken met het team van Crunch-IS. Ze werkten nauwgezet en waren zeer professioneel. Als er vragen of technische problemen opkwamen, beantwoordden ze die snel en waren ze altijd bereid en vriendelijk om ons te helpen.

De ontwikkelaar van Crunch-IS hielp ons een belangrijke functie op te leveren voor ons project, veel sneller dan verwacht.

Crunch-IS zorgde gedurende het hele project voor een soepele, gezamenlijke inspanning. Het team hield de communicatielijnen open, legde de toewijzing van taken nauwkeurig vast en hield zich aan de projectplanning. Hun expertise op het gebied van zowel ontwerp als ontwikkeling onderscheidt het bedrijf.

Crunch-IS levert doorlopende ontwikkelondersteuning die voldoet aan de projectvereisten wanneer dat nodig is. Ondanks hun offshorelocatie is het prettig met ze samenwerken en zijn ze goed bereikbaar via de communicatiekanalen

De beste leverancier die we konden vinden. Crunch-IS combineert praktische ontwikkeling met innovatieve ontwerpprincipes. De interne en externe feedback op de app-ontwikkeling is positief geweest. Ze halen projectmijlpalen volgens de afgesproken planning en leveren binnen budget. Het team is responsief en bereid tot een constructief gesprek.

Crunch-IS overtrof mijn verwachtingen. Ik waardeerde de vindingrijkheid van de ontwikkelaars bij beperkingen en complexe eisen. Het bedrijf wist het project succesvol op te leveren en af te ronden.

Het project verloopt tot nu toe soepel. Crunch-IS heeft een uitzonderlijke werkethiek. Daardoor hebben ze elke uitdaging die op hun pad kwam kunnen aanpakken. Ze regelen het dagelijkse werk goed zelfstandig, maar overleggen ook regelmatig met ons om te zorgen dat we op één lijn zitten.

De app waaraan Crunch-IS heeft gewerkt is strak, gestroomlijnd en functioneert zoals bedoeld. Crunch-IS doet er alles aan om ervoor te zorgen dat beide teams op elkaar zijn afgestemd. Het bevlogen team zorgt voor een plezierige ervaring door hun positieve houding en effectieve projectmanagementvaardigheden. Het team was heel vriendelijk en het was een genoegen om met ze samen te werken.

Waarom kiezen voor Crunch-IS als uw partner

Wij ontwerpen voor productieomstandigheden
De meeste pipelinestoringen ontstaan in het gat tussen testdata en echte belasting. Wij bouwen en valideren tegen de datavolumes, schemavariaties en bron-inconsistenties die uw systeem werkelijk tegenkomt.

AI-gedreven engineering
Wij zetten AI in om echte engineeringproblemen op te lossen: automatische anomaliedetectie, slimme schemabewaking, LLM-ondersteunde transformatie van ongestructureerde data en AI-gestuurde diagnose van pipelines.

Datamigraties zijn kernwerk, geen uitzondering
Migraties mislukken wanneer teams ze als één cutovermoment behandelen. Wij voeren ze uit in gecontroleerde stappen: audit vooraf, parallelle validatie, overdracht met acceptatietests en verzoening met aftekening.
Veelgestelde vragen over data engineering
Wat is data engineering?
Data engineering is het vakgebied dat de infrastructuur ontwerpt, bouwt en onderhoudt die ruwe data bruikbaar maakt. Denk aan pipelines die data uit meerdere bronnen verzamelen, die omzetten naar consistente formaten, opslaan in structuren die analyse ondersteunen en het geheel betrouwbaar op schaal laten draaien. Data scientists, analisten en productteams leunen allemaal op die infrastructuur — is die solide, dan werkt iedereen sneller; is die dat niet, dan voelt de hele organisatie dat.
Wat is het verschil tussen data engineering en data science?
Data engineering bouwt de systemen die data verzamelen, opschonen en bruikbaar afleveren. Data science werkt met die data om analyses te doen, modellen te bouwen en voorspellingen te maken. Ze hangen samen: data science levert alleen betrouwbare uitkomsten als de onderliggende infrastructuur klopt. In de meeste organisaties is de snelste manier om de analytische output te verbeteren, eerst de kwaliteit van de data engineering te verhogen.
Hoe voeren jullie datamigraties uit zonder de bedrijfsvoering te verstoren?
Wij migreren in stappen. De eerste fase is een volledige audit van de bronomgeving: schemamapping, beoordeling van datakwaliteit en het vinden van hiaten. Wij voeren overdrachten uit in gecontroleerde batches, met validatiemomenten in elke stap, en draaien waar nodig parallelle omgevingen om de uitkomst te bevestigen voordat de bron wordt uitgezet. Na de migratie voeren wij verzoeningscontroles uit tegen afgesproken acceptatiecriteria. Niets wordt afgetekend op één cutover.
Welke databronnen kunnen jullie koppelen?
De meeste relationele databases (PostgreSQL, MySQL, SQL Server, Oracle), cloudopslag (S3, Azure Blob, GCS), SaaS-API’s (Salesforce, HubSpot, Stripe en vergelijkbaar), message queues (Kafka, Kinesis, RabbitMQ), platte bestanden (CSV, JSON, Parquet) en legacysystemen met eigen protocollen. De aanpak — directe connectoren, eigen Python-extractors of beheerde tools als Fivetran — kiezen wij op basis van betrouwbaarheidseisen en beheerlast.
Hoe regelen jullie beveiliging en compliance in datapipelines?
Toegangsrechten, encryptie en audit logging zitten tijdens het ontwerp in de platformarchitectuur. Rolgebaseerde permissies bepalen wie elke dataset mag lezen of wijzigen. Data tijdens transport is versleuteld; data in rust gebruikt de platform-eigen encryptie van AWS, Azure of GCP. Voor gereguleerde omgevingen documenteren wij de gegevensverwerking tegen de eisen van de AVG, HIPAA of SOC 2 en leveren wij architectuurdocumentatie voor de compliancetoetsing.
Hoe wordt Python gebruikt in data engineering?
Python is de standaardtaal voor data engineering dankzij het brede ecosysteem. Apache Airflow — het meest gebruikte framework voor pipeline-orkestratie — is Python-native. PySpark verwerkt data gedistribueerd op schaal. dbt werkt samen met Python voor tests en transformaties. Pandas en SQLAlchemy dekken extractie, transformatie en databaseconnectiviteit.
Succesverhalen van Crunch-IS
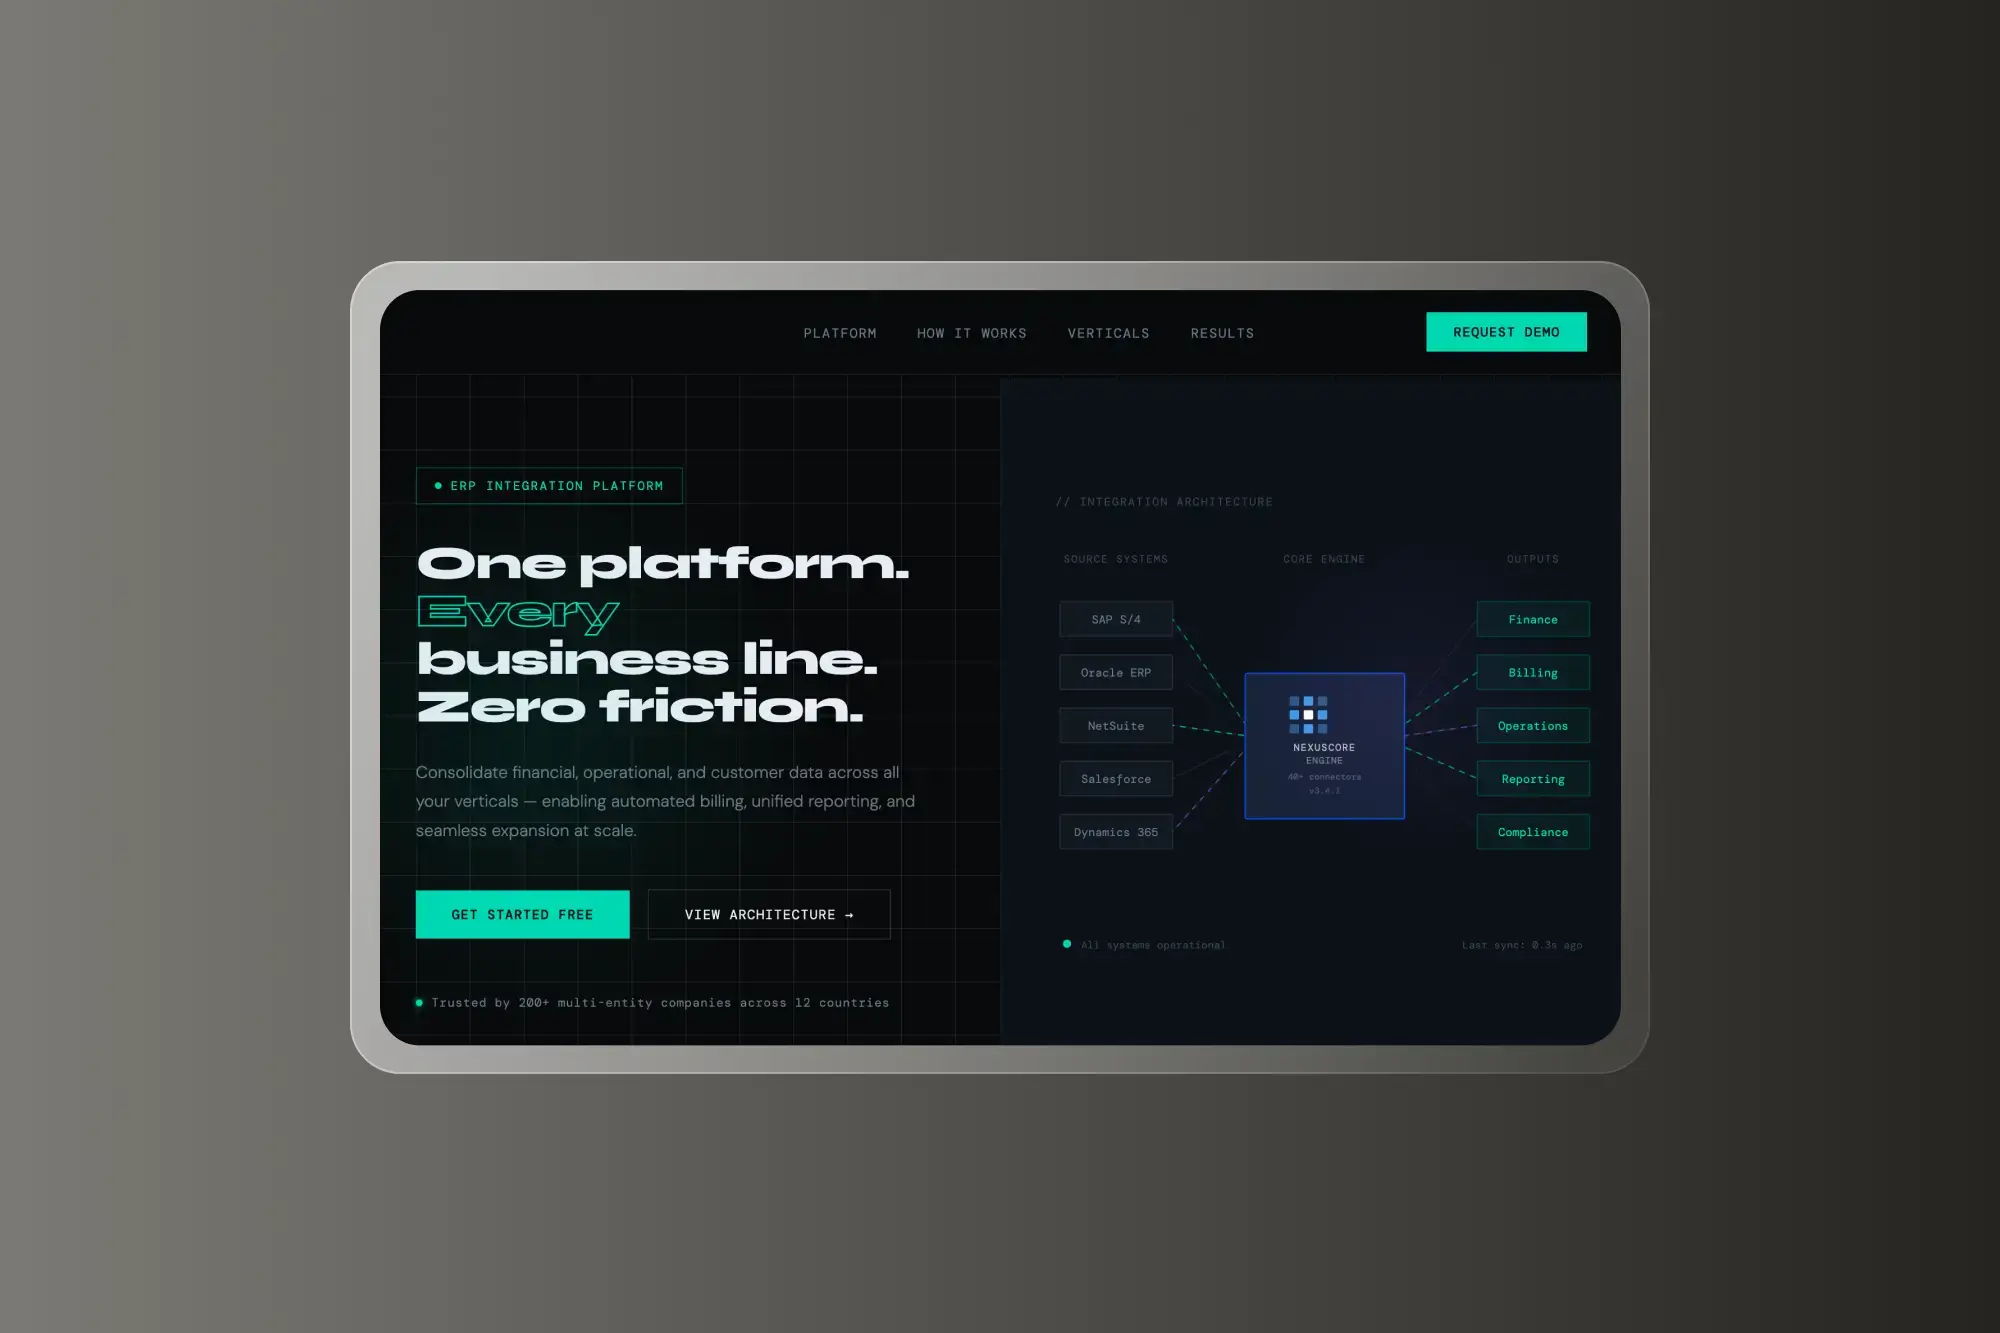
Eén geïntegreerd ERP-platform dat financiële, operationele en klantgegevens over meerdere bedrijfstakken samenbrengt...

We bouwden een AI-analyseplatform dat ongestructureerde financiële en operationele data omzet in...
Blijf op de hoogte van de nieuwste trends
Vertel ons wat u bouwt
Stuur een opzet, een specificatie of drie zinnen over waar het systeem is vastgelopen. Eén gesprek is meestal genoeg om te weten of we bij elkaar passen.
Maatwerksoftware, AI & ML, data en analytics, cloud en security — van de eerste afbakening tot langdurige levering.
- 170+ experts
- 120+ opgeleverde projecten
- 97% volledig tevreden


