Förbättra befintliga digitala tvillingar med prediktivt underhåll på Azure

Förbättra befintliga digitala tvillingar med prediktivt underhåll på Azure | Crunch-IS Case Study
Vi byggde ett lager för prediktivt underhåll ovanpå kundens befintliga Azure-digitala tvillingar för kritisk roterande utrustning — vi kopplade samman sensor-, drift- och underhållshistorikdata för att generera förklarbara hälsopoäng, försämringssignaler och indikatorer för felrisk.
Bransch:

Olja & Gas

Plats:

USA

Varaktighet:

20 veckor

Technologies
Azure Data Lake Storage Gen2
Azure Databricks
Azure Machine Learning
Azure Functions
Azure Synapse Analytics
Azure IoT Hub
Azure DevOps
Azure Monitor
Power BI
Litmus
Microsoft Purview
01

Om kunden

Kunden är en USA-baserad olje- och gasoperatör som driver en anläggning för bearbetning och kompression av naturgas. När detta uppdrag inleddes hade kunden redan etablerat molnbaserad datainfrastruktur på Azure och hade befintliga digitala tvillingar för utvalda operativa tillgångar.
Förbättra befintliga digitala tvillingar med prediktivt underhåll på Azure | Crunch-IS Case Study
02

Utmaning

Kunden hade redan investerat i digitala tvillingar och hade driftdata landad i Azure, men tvillingarna var ännu inte tillräckligt starka för beslutsfattande kring prediktivt underhåll. Underhållet var fortfarande till stor del reaktivt eller kalenderstyrt eftersom logik för tillgångshälsa saknades eller var för grundläggande.

Fyra problem blockerade framstegen:

1. Oförberedd sensordata

Sensordata fanns tillgänglig, men var inte omvandlad till features på tillgångsnivå som kunde användas av prediktiva modeller.

2. Frånkopplad underhållshistorik

Underhållshistoriken var inte kopplad till driftbeteendet, vilket gjorde det svårt att validera nedbrytningsmönster.

3. Sena tröskelbaserade larm

Befintliga larm var mestadels tröskelbaserade och dök ofta upp för sent för att stödja proaktiva insatser.

4. Brist på förklarbara indikatorer för tillgångshälsa

Tillförlitlighetsteamen behövde förklarbara indikatorer för tillgångshälsa inom den digitala tvillingens kontext, inte modellpoäng från svarta lådor eller isolerade instrumentpaneler.

03

Lösningen vi levererade

Vi avgränsade MVP:n till gaskompressortåg, vilket höll modellen fokuserad på en utrustningsgrupp med liknande driftprofiler och sensortäckning. Detta gjorde logiken för prediktivt underhåll tekniskt realistisk och lämplig för integration med kundens befintliga digitala tvillingar.

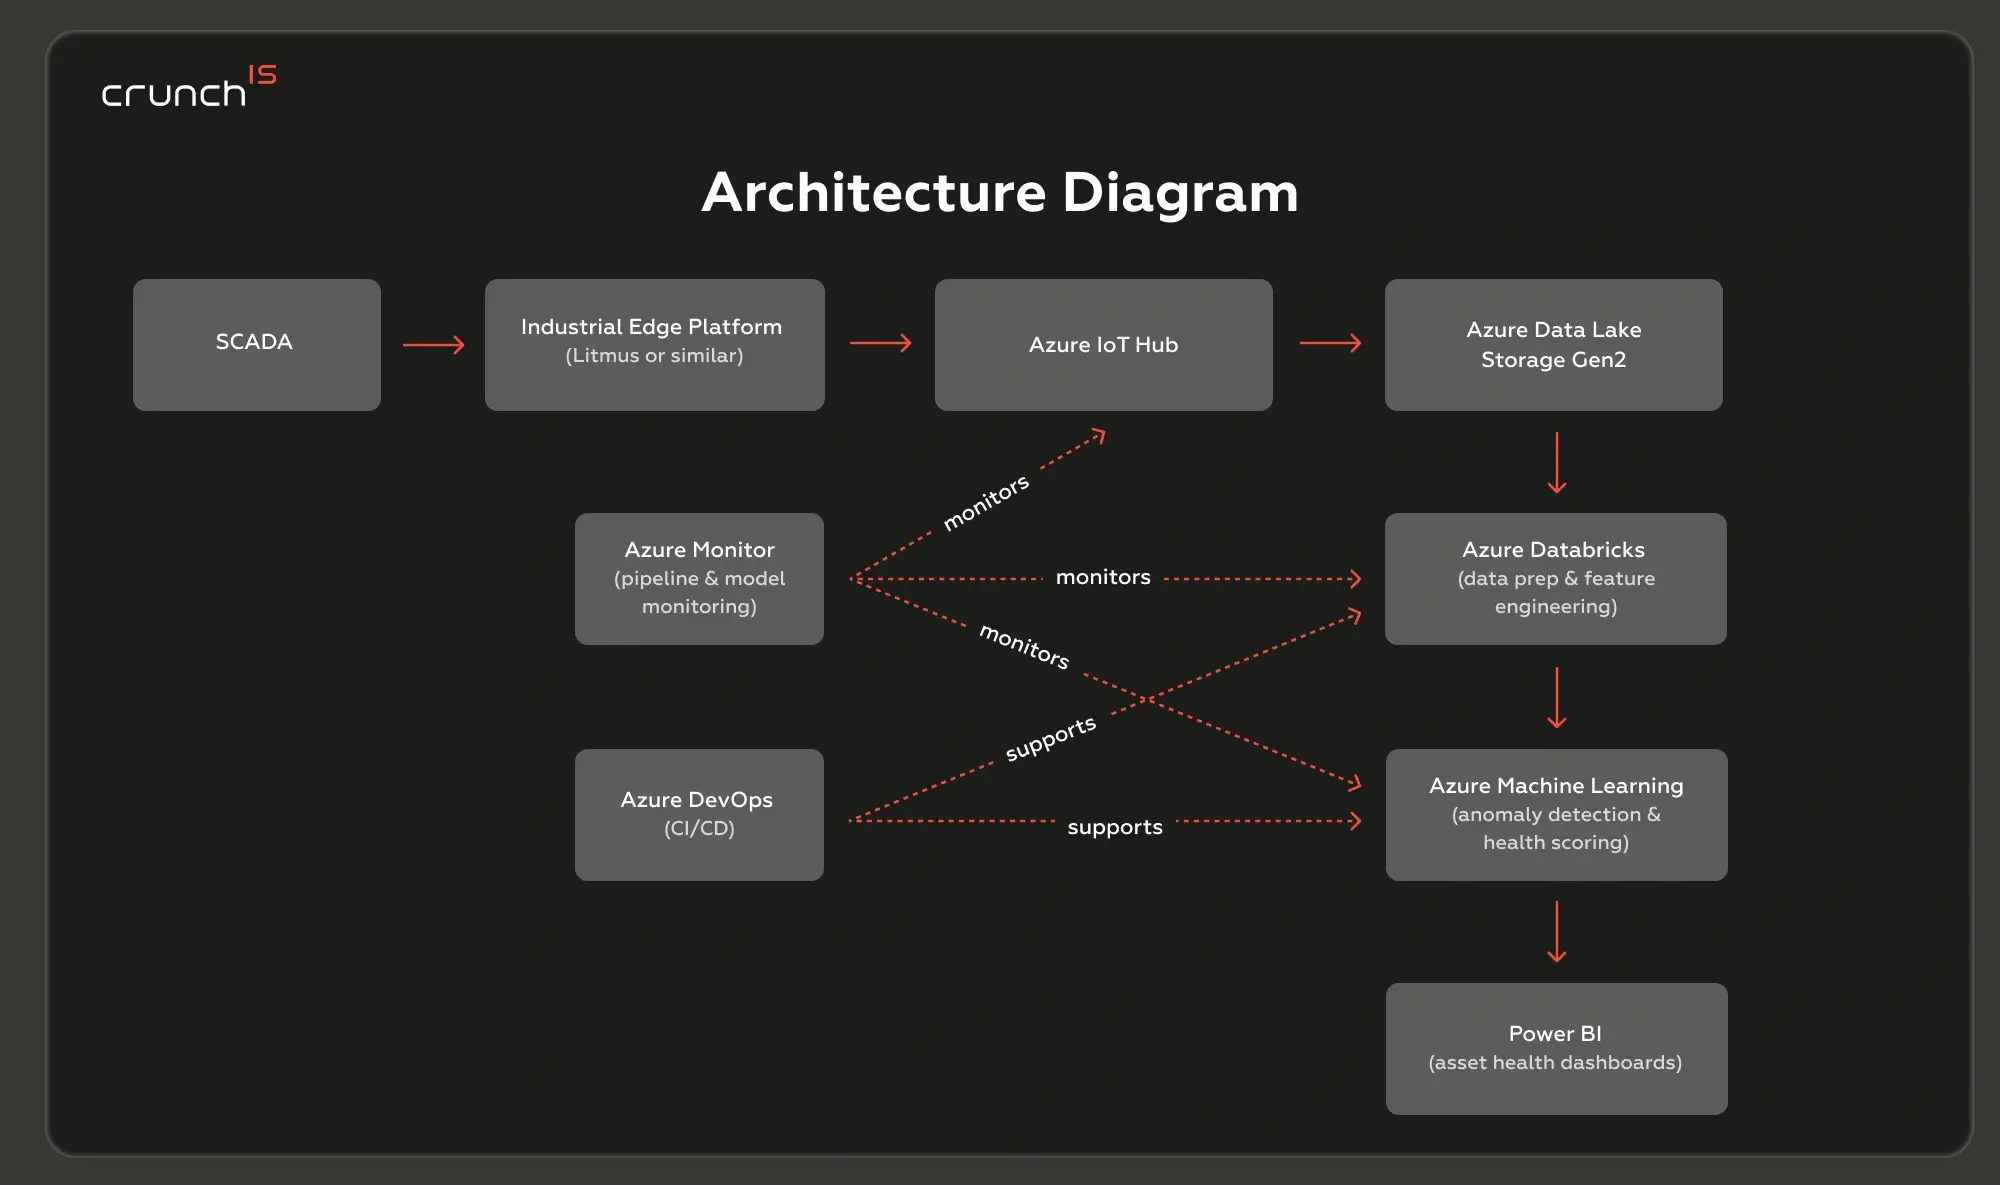
På den Azure-infrastruktur som kunden redan hade på plats byggde vi ett lager för prediktivt underhåll som kopplade samman driftdata, underhållshistorik och tillgångskontext. Lösningen omfattade:


Omfångsbestämning av användningsfall och val av tillgångar

Vi granskade den befintliga Azure-datasjöstrukturen tillsammans med kundens underhållsprioriteringar för att identifiera var prediktivt underhåll kunde ha störst omedelbar påverkan. Gaskompressortåg valdes utifrån kritikalitet, sensortäckning och datatillgänglighet. MVP-arkitekturen utformades från början för att kunna utökas till andra tillgångsgrupper med jämförbara driftsprofiler.

Databeredning och feature engineering

Azure Databricks hanterade datateknik genom hela pipelinen. Vi rensade och normaliserade tidsseriedata från sensorer, kopplade samman driftdata med underhållshistorik (arbetsorder, felkoder och larmloggar) och konstruerade ML-features på tillgångsnivå för varje kompressorenhet.

Dessa features fångade både momentana avläsningar och beteendetrender: 24-timmars vibrationsgenomsnitt, 7-dagars temperaturtrender för lager, minsta tryckfönster för smörjolja, motorströmsavvikelser från belastningsjusterade baslinjer och antal start/stopp-cykler.

Avvikelsedetektering och modellering av felrisk

Med hjälp av Azure Machine Learning tränade vi modeller för avvikelsedetektering och degraderingsanalys på de förberedda feature-uppsättningarna. Modellerna genererar två utdata per tillgång:

  1. en hälsopoäng som återspeglar det aktuella driftstillståndet och
  2. en indikator för kortsiktig felrisk.

Båda är kopplade till de specifika signaler som driver bedömningen — så att tillförlitlighetsingenjörer kan se vad som ändrades, inte bara att något ändrades.

Instrumentpaneler för tillgångshälsa

Power BI-instrumentpaneler ger tillförlitlighets- och underhållsteam en samlad vy över flottans hälsa: hälsopoäng, felrisk per tillgång, avvikelsetrender och de underliggande signaler som bidrar till varje indikator. Rekommenderade åtgärder visas tillsammans med modellens resultat, vilket förankrar automatiserade signaler i ett operativt sammanhang.

Validering och beredskap för utrullning

Vi genomförde valideringssessioner med kundens tillförlitlighetsingenjörer för att bekräfta att modellens utdata överensstämde med känt utrustningsbeteende och tidigare felhändelser. Azure DevOps hanterade CI/CD över datapipelines, ML-kod och infrastruktur. MVP:n överlämnades i ett tillstånd redo för produktionsutrullning till ytterligare tillgångsgrupper.

Crunch-IS image case study
04

Kundens resultat

MVP:n levererade en fungerande förmåga till prediktivt underhåll med hjälp av data som kunden redan ägde och stärkte värdet av kundens befintliga digitala tvillingar.

Så här förändrades det:

Underhållsbeslut grundade i data

Tillförlitlighets- och underhållsteam gick från kalenderbaserad schemaläggning och reaktiva tröskelvärdeslarm mot datadrivna beslut. Hälsopoäng för tillgångar och nedbrytningstrender ger ingenjörer en grund för att prioritera inspektioner innan förhållandena blir kritiska.

Tidig försämring nu synlig

Gradvisa försämringsmönster – stigande vibrationstrender, avdrift i lagertemperatur, fall i smörjoljetryck – upptäcks nu och synliggörs innan de når larmtröskeln. Fönstret mellan den tidiga signalen och haveriet är synligt för första gången.

Rekommendationer som ingenjörer kan agera på

Varje hälsoindikator är spårbar till de specifika signaler som driver den. Tillförlitlighetsingenjörer ser de bidragande faktorerna tillsammans med poängen, så att rekommendationerna stödjer deras bedömning snarare än att ersätta den. Lösningen validerades mot känd felhistorik före överlämningen.

En grund, inte en engångsföreteelse

MVP-arkitekturen utformades för att skalas upp till ytterligare tillgångsgrupper med jämförbar sensortäckning och driftsprofiler. Att integrera en ny utrustningstyp bygger på det befintliga ramverket i stället för att börja från grunden.

Berätta vad ni bygger

Skicka en skiss, en kravspecifikation eller tre meningar om var systemet har kört fast. Ett samtal räcker oftast för att avgöra om vi passar er.

Skräddarsydd mjukvara, AI och ML, data och analys, moln och säkerhet — från tidig behovsanalys till långsiktig leverans.

  • 170+ experter
  • 120+ levererade projekt
  • 97% helt nöjda

    Jag har läst och godkänt Användarvillkoren och Integritetspolicyn *

    Din integritet är viktig. Vi använder cookies för att förbättra din upplevelse och anpassa innehåll.