Verbesserung bestehender digitaler Zwillinge mit vorausschauender Wartung auf Azure

Verbesserung bestehender digitaler Zwillinge mit vorausschauender Wartung auf Azure | Crunch-IS Case Study
Wir haben auf den bestehenden digitalen Zwillingen des Kunden in Azure eine Schicht für die vorausschauende Wartung kritischer rotierender Anlagen aufgebaut. Sie verbindet Sensor-, Betriebs- und Wartungsdaten, um erklärbare Zustandsbewertungen, Degradationssignale und Indikatoren für Ausfallrisiken zu erzeugen.
Industrie:

Öl & Gas

Standort:

USA

Teamgröße:

8

Dauer:

20 Wochen

Technologies
Azure Data Lake Storage Gen2
Azure Databricks
Azure Machine Learning
Azure Functions
Azure Synapse Analytics
Azure IoT Hub
Azure DevOps
Azure Monitor
Power BI
Litmus
Microsoft Purview
01

Über den Kunden

Der Kunde ist ein US-amerikanischer Öl- und Gasbetreiber, der eine Anlage zur Verarbeitung und Verdichtung von Erdgas betreibt. Als dieser Auftrag begann, hatte der Kunde bereits eine Cloud-Dateninfrastruktur auf Azure eingerichtet und verfügte über digitale Zwillinge für ausgewählte Betriebsanlagen.
Verbesserung bestehender digitaler Zwillinge mit vorausschauender Wartung auf Azure | Crunch-IS Case Study
02

Herausforderung

Der Kunde hatte bereits in digitale Zwillinge investiert und verfügte über Betriebsdaten, die in Azure gelandet waren, aber die Zwillinge waren noch nicht stark genug für eine vorausschauende Wartungsentscheidung. Die Wartung war immer noch weitgehend reaktiv oder kalendergesteuert, weil die Logik für den Anlagenzustand fehlte oder zu einfach war.

Vier Probleme blockierten den Fortschritt:

1. Unvorbereitete Sensordaten

Sensordaten waren zwar verfügbar, wurden aber nicht in Merkmale auf Anlagenebene umgewandelt, die von Vorhersagemodellen genutzt werden konnten.

2. Getrennte Wartungshistorie

Die Wartungshistorie war nicht mit dem Betriebsverhalten verknüpft, so dass Degradationsmuster schwer zu validieren waren.

3. Späte schwellenwertbasierte Alarme

Bestehende Warnmeldungen basierten meist auf Schwellenwerten und kamen oft zu spät, um ein proaktives Eingreifen zu ermöglichen.

4. Fehlende erklärbare Indikatoren für den Anlagenzustand

Die Zuverlässigkeitsteams brauchten erklärbare Indikatoren für den Zustand der Anlagen im Rahmen des digitalen Zwillings, keine Blackbox-Modellwerte oder isolierte Dashboards.

03

Gelieferte Lösung

Wir beschränkten das MVP auf Gaskompressorstränge und konzentrierten das Modell auf eine Anlagengruppe mit ähnlichen Betriebsprofilen und Sensorabdeckung. Dadurch wurde die Logik der vorausschauenden Wartung technisch realistisch und eignete sich für die Integration in die bestehenden digitalen Zwillinge des Kunden.

Auf der Azure-Infrastruktur, die der Kunde bereits hatte, bauten wir eine vorausschauende Wartungsschicht auf, die Betriebsdaten, Wartungshistorie und Anlagenkontext miteinander verband. Die Lösung umfasste:


Anwendungsfall-Scoping und Asset-Auswahl

Wir überprüften die bestehende Azure Data Lake-Struktur zusammen mit den Wartungsprioritäten des Kunden, um herauszufinden, wo die vorausschauende Wartung die größten Auswirkungen haben könnte. Die Auswahl der Gaskompressorstränge erfolgte auf der Grundlage von Kritikalität, Sensorabdeckung und Datenverfügbarkeit. Die MVP-Architektur wurde von Anfang an so konzipiert, dass sie auf andere Anlagengruppen mit vergleichbaren Betriebsprofilen ausgeweitet werden kann.

Datenaufbereitung und Feature Engineering

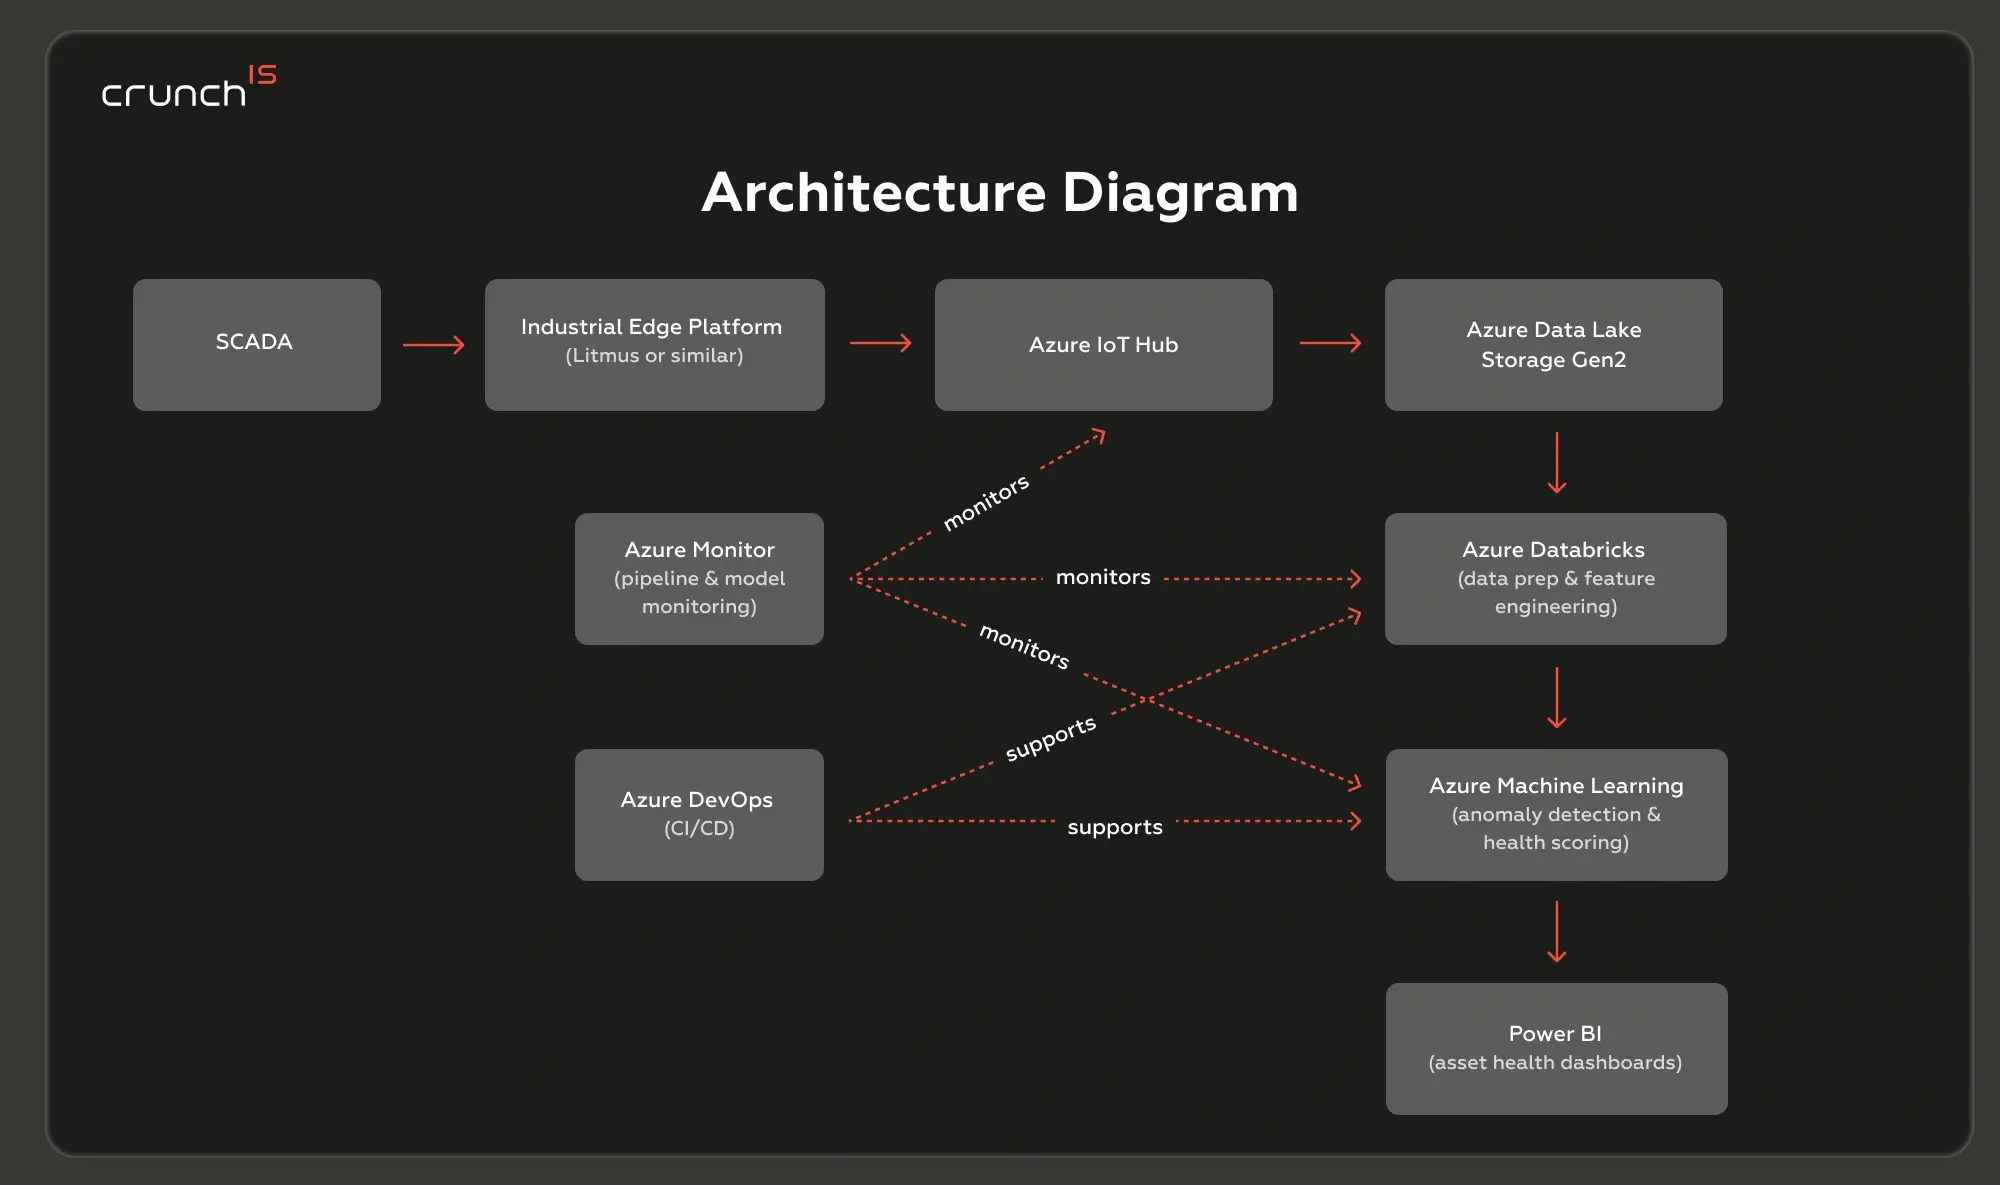
Azure Databricks übernahm das Data Engineering für die gesamte Pipeline. Wir bereinigten und normalisierten die Zeitreihendaten der Sensoren, verknüpften Betriebsaufzeichnungen mit der Wartungshistorie (Arbeitsaufträge, Fehlercodes und Alarmprotokolle) und entwickelten ML-Merkmale auf Anlagenebene für jede Kompressoreinheit.

Es wurden sowohl Momentanwerte als auch Verhaltenstrends erfasst: 24-Stunden-Durchschnittswerte für Vibrationen, 7-Tage-Trends für die Lagertemperatur, Fenster für den minimalen Schmieröldruck, Abweichungen des Motorstroms von der lastangepassten Basislinie und die Anzahl der Start-/Stoppzyklen.

Erkennung von Anomalien und Modellierung von Ausfallrisiken

Mithilfe von Azure Machine Learning haben wir Modelle zur Anomalieerkennung und Degradationsanalyse mit den vorbereiteten Merkmalssätzen trainiert. Die Modelle erzeugen zwei Ausgaben pro Asset:

  1. eine Zustandsbewertung, die den aktuellen Betriebszustand widerspiegelt und
  2. einen Indikator für ein kurzfristiges Ausfallrisiko.

Beide sind mit den spezifischen Signalen verknüpft, die für die Bewertung ausschlaggebend sind – so können die Zuverlässigkeitsingenieure sehen, was sich geändert hat, und nicht nur, dass sich etwas geändert hat.

Dashboards zum Anlagenzustand

Power BI-Dashboards geben Zuverlässigkeits- und Wartungsteams einen Überblick über den Zustand der Flotte: Zustandsbewertungen, Ausfallrisiko nach Anlage, Anomalietrends und die zugrunde liegenden Signale, die zu jedem Indikator beitragen. Empfohlene Maßnahmen werden neben den Modellergebnissen angezeigt, so dass automatisierte Signale in einen betrieblichen Kontext eingebettet sind.

Validierung und Rollout-Bereitschaft

Wir führten Validierungssitzungen mit den Zuverlässigkeitsingenieuren des Kunden durch, um zu bestätigen, dass die Modellergebnisse mit dem bekannten Geräteverhalten und früheren Ausfallereignissen übereinstimmten. Azure DevOps verwaltete CI/CD für Datenpipelines, ML-Code und die Infrastruktur. Das MVP wurde in einem Zustand übergeben, der für die Produktionseinführung in weiteren Anlagengruppen bereit war.

Crunch-IS image case study
04

Die Ergebnisse des Kunden

Das MVP lieferte eine funktionierende Lösung für vorausschauende Wartung unter Verwendung von Daten, die der Kunde bereits besaß, und stärkte den Wert der bestehenden digitalen Zwillinge des Kunden.

Das hat sich verändert:

Wartungsentscheidungen auf der Grundlage von Daten

Zuverlässigkeits- und Wartungsteams sind von einer kalenderbasierten Planung und reaktiven Schwellenwertwarnungen zu datengesteuerten Entscheidungen übergegangen. Die Bewertungen des Anlagenzustands und die Degradationstrends bieten den Ingenieuren eine Grundlage für die Priorisierung von Inspektionen, bevor der Zustand kritisch wird.

Frühe Verschlechterung jetzt sichtbar

Allmähliche Verschlechterungsmuster – steigende Vibrationstendenzen, Lagertemperaturdrift, Schmieröldruckabfall – werden jetzt erkannt und aufgedeckt, bevor sie Alarmschwellen erreichen. Das Zeitfenster zwischen dem Frühsignal und dem Ausfall ist zum ersten Mal sichtbar.

Empfehlungen, nach denen Ingenieure handeln können

Jeder Zustandsindikator kann zu den spezifischen Signalen zurückverfolgt werden, die ihm zugrunde liegen. Zuverlässigkeitsingenieure sehen neben der Bewertung auch die dazu beitragenden Merkmale, so dass die Empfehlungen ihr Urteilsvermögen unterstützen, anstatt es zu ersetzen. Die Lösung wurde vor der Übergabe anhand der bekannten Ausfallhistorie validiert.

Eine Grundlage, keine Einzellösung

Die MVP-Architektur wurde so konzipiert, dass sie auf zusätzliche Anlagengruppen mit vergleichbarer Sensorabdeckung und vergleichbaren Betriebsprofilen skaliert werden kann. Die Integration eines neuen Gerätetyps baut auf dem bestehenden Rahmen auf, anstatt bei Null zu beginnen.

Erzählen Sie uns, was Sie entwickeln

Schicken Sie uns eine Skizze, eine Spezifikation oder drei Sätze dazu, wo Ihr System gerade feststeckt. Ein Gespräch reicht in der Regel, um herauszufinden, ob wir zueinander passen.

Individuelle Software, KI & ML, Daten und Analytics, Cloud und Sicherheit – vom ersten Scoping bis zur langfristigen Umsetzung.

  • 170+ Experten
  • 120+ abgeschlossene Projekte
  • 97% rundum zufrieden

    Ich habe die Nutzungsbedingungen und Datenschutzbestimmungen gelesen und akzeptiert *

    Ihre Privatsphäre ist uns wichtig. Wir verwenden Cookies, um Ihr Erlebnis zu verbessern und Inhalte zu personalisieren.