Computer vision wordt in steeds meer werkprocessen en sectoren ingezet. Het bouwen en invoeren van AI-gestuurde computer-visionsystemen kan echter kostbaar zijn. Modellen ontwikkelen is toegankelijker geworden dankzij vooraf getrainde architecturen en opensource-libraries, maar de echte kostenvraag zit vaak in de uitrol. Keuzes rond hosting, inferentie, opslag en infrastructuur bepalen in hoge mate uw rendement op lange termijn.
In dit artikel bekijken we hoe verschillende uitrolstrategieën (cloud, edge en embedded) de kosten én de prestaties beïnvloeden. U leest waar de kosten vandaan komen, welke architectuur bij uw toepassing past en hoe u slimmere keuzes maakt die uw computer vision -budget in toom houden.
- De uitrolarchitectuur is de grootste kostenpost bij computer vision: hosting, inferentie, dataverkeer en onderhoud bepalen het rendement op lange termijn.
- Computer vision in de cloud biedt ongeevenaarde schaalbaarheid en snelle iteratie, maar ongecontroleerd GPU-gebruik, doorlopende videostromen en groeiende opslag jagen de exploitatiekosten snel op.
- Uitrol op de edge verschuift kosten van terugkerende clouduitgaven naar een investering vooraf in hardware, met lagere latentie, betere privacy en voorspelbare kosten op lange termijn bij realtimetoepassingen.
- Embedded computer vision haalt op schaal de laagste kosten per eenheid door sterk geoptimaliseerde modellen op zuinige hardware te draaien, maar ondersteunt alleen smalle, taakspecifieke workloads.
- Hybride architecturen presteren steeds vaker beter dan uitrol in één modus, door realtime inferentie op edge- of embedded apparaten te houden en training, analyse en monitoring in de cloud te centraliseren.
- Echte kostenbesparing komt voort uit het afstemmen van eisen rond latentie, privacy en prestaties op het eenvoudigste haalbare uitrolmodel.
Wat bepaalt de kosten van computer vision?
Op hoofdlijnen komen de totale kosten van het bouwen en draaien van computer vision uit vier hoeken: ontwikkeling, data, infrastructuur en onderhoud op lange termijn.
- Het ontwikkelproces omvat het schrijven van maatwerkcode, het trainen van modellen en het naadloos inpassen van CV in bestaande systemen.
- Data kost geld door het verzamelen en labelen van beelddatasets, zeker wanneer de gewenste nauwkeurigheid eigen, domeinspecifieke data vereist.
- Infrastructuur betreft de rekenkracht en opslag die nodig zijn om modellen te trainen en uit te rollen, in de cloud of op het apparaat zelf.
- Onderhoud omvat doorlopende updates, monitoring, MLOps -workflows en de capaciteit in het team om het systeem op lange termijn te ondersteunen.
Elk van die onderdelen schaalt anders, afhankelijk van hoe en waar u uw modellen uitrolt — zeker bij de keuze tussen edge-apparaten en inferentie in de cloud.
Wilt u elke kostenpost volledig uitgesplitst zien,, bekijk dan onze uitgebreide gids: De gids voor computer-visionontwikkeling in 2025: kosten, proces en techstack
Hoe kiest u de juiste uitrolaanpak voor computer vision: cloud, edge of embedded?
Bij het uitrollen van computer vision bepaalt de gekozen architectuur (cloud, edge of embedded) in hoge mate de prestaties, de schaalbaarheid en de kostenstructuur.
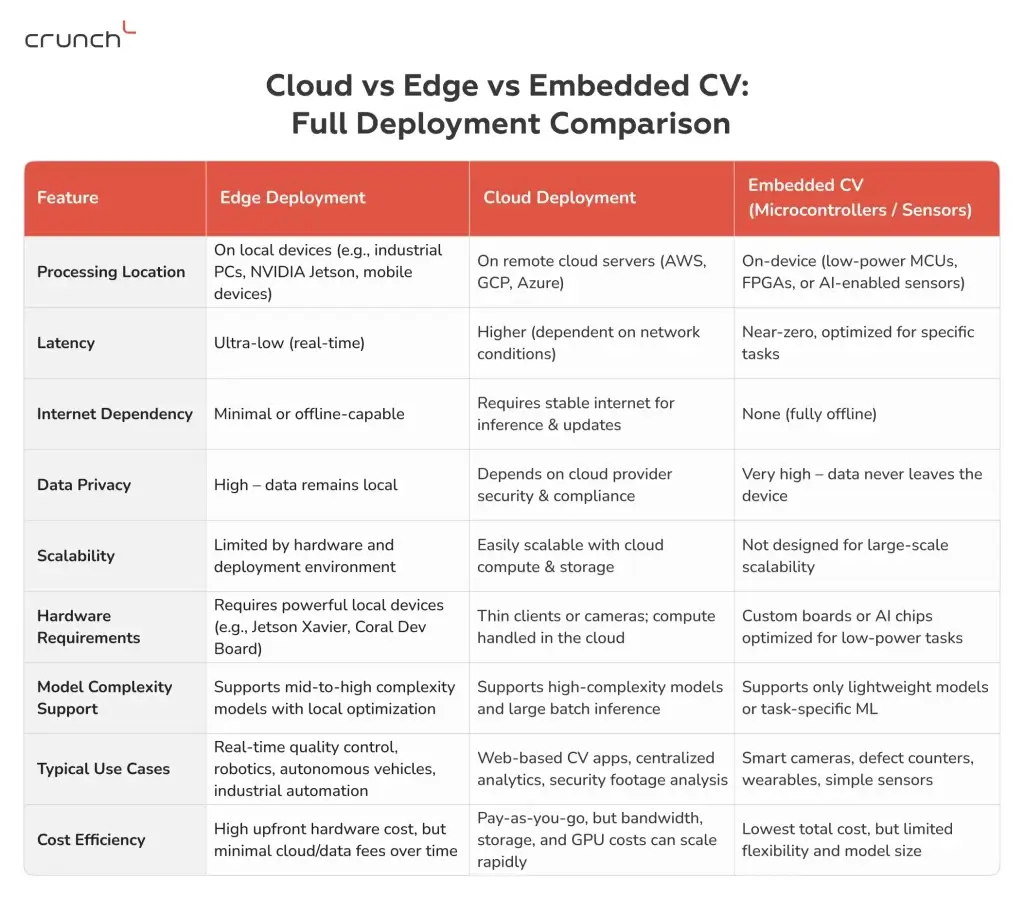
Computer vision in de cloud is vaak de eerste keuze voor bedrijven die schaalbaarheid en eenvoudige integratie zoeken. U traint en rolt complexe modellen uit, beschikt over vrijwel onbeperkte opslag en rekenkracht en gebruikt beheerde diensten. Die voordelen hebben wel een prijs: afrekenen naar gebruik loopt snel op naarmate de data groeit, zeker bij doorlopende videostromen, GPU-inferentietijd en opslag.
Uitrol op de edgebetekent daarentegen dat modellen rechtstreeks op lokale apparaten draaien. De hardwarekosten vooraf zijn fors, maar het is een investering die zich terugbetaalt door lage latentie en minimale doorlopende kosten voor dataverkeer. Deze architectuur past goed bij realtime CV-toepassingen, zoals kwaliteitscontrole aan de productielijn of autonome navigatie.
Embedded computer vision (vaak draaiend op microcontrollers of gespecialiseerde AI-chips) is op lange termijn het voordeligst. Deze systemen zijn gebouwd voor specifieke taken met strikte grenzen aan verbruik, geheugen en modelgrootte. Ze zijn niet geschikt voor complexe workloads, maar wel ideaal voor eenvoudige, veelvoorkomende, goedkope taken als objecten tellen, basale defectdetectie of barcodes scannen. Er zijn geen cloudkosten, geen afhankelijkheid van verbinding en vrijwel geen latentie.
Elke aanpak vraagt afwegingen tussen flexibiliteit, prestaties en kostenefficientie. Daarom gebruiken veel moderne systemen een hybride architectuur, waarbij lichte taken op de edge of op embedded apparaten draaien en zwaar trainen en analyseren in de cloud gebeurt.
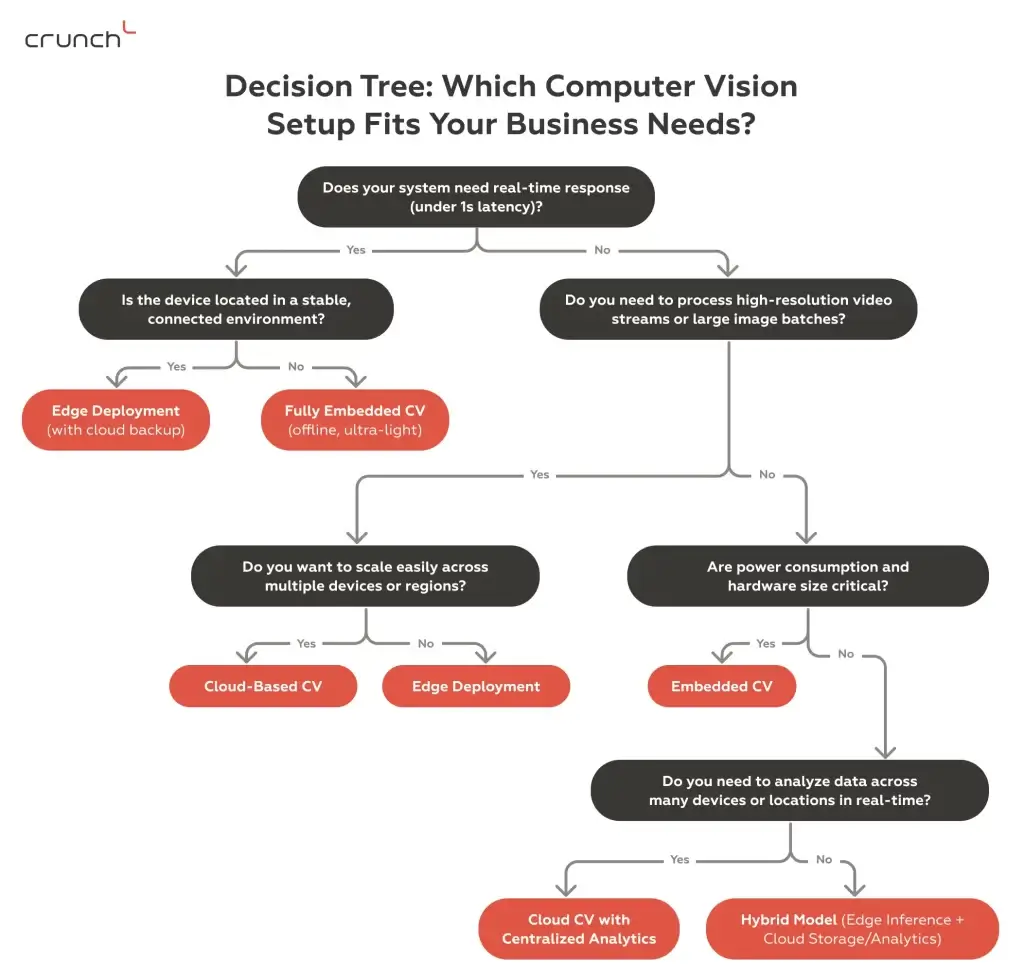
Gebruik dit stroomschema om de best passende uitrolarchitectuur (cloud, edge of embedded) te bepalen op basis van latentie, verbruik, privacy, schaal en de eisen van uw toepassing.
Computer vision in de cloud: AWS, GCP, Azure
Uitrol in de cloud betekent dat uw AI-modellen — voor beeldherkenning, objectdetectie of video-analyse — op externe cloudservers draaien in plaats van op lokale apparaten. Beeldmateriaal gaat naar de cloud, waar krachtige GPU’s of TPU’s het verwerken en inzichten, voorspellingen of meldingen terugsturen.
Hieronder ziet u hoe computer-visionsystemen doorgaans worden uitgerold op de grote cloudplatforms: Amazon Web Services (AWS), Google Cloud Platform (GCP)en Microsoft Azure:
AWS voor het uitrollen van computer vision
Modellen op maat worden meestal getraind op EC2-instances met GPU of in Amazon SageMaker, en daarna uitgerold als schaalbare endpoints via SageMaker of in containers met ECS of EKS. Modelbestanden en datasets staan in S3. Voor realtime beeld- of videostromen kunnen Rekognition of Kinesis in hybride opstellingen naast uw eigen modellen worden gebruikt.
Google Cloud voor computer-visiontoepassingen
Met Vertex AI trainen, verfijnen en rollen ontwikkelaars computer-visionmodellen uit op volledig beheerde infrastructuur. Modellen worden via endpoints aangeboden en met REST-API’s in applicaties ingebouwd. Google Cloud Storage wordt vaak gebruikt voor beelddatasets. CV-modellen kunnen ook worden gecombineerd met kant-en-klare tools zoals de Cloud Vision API, als er maar deels maatwerk nodig is.
Azure voor visionworkloads op maat
Azure ondersteunt het uitrollen van eigen computer-visionmodellen met Azure Machine Learning en Kubernetes Service. Modellen worden getraind in ML Studio op basis van Jupyter of in Docker-containers, en opgeslagen in Blob Storage. Inferentie kan in de cloud of op edge-apparaten via Azure IoT Edge en ONNX Runtime.
Welke cloud het beste past hangt af van de latentie-eisen van uw project, het budget en de uitrolstrategie (centraal versus edge).
Computer vision in de cloud biedt een aantal belangrijke voordelen. Ten eerste kunt u dankzij de sterke schaalbaarheid moeiteloos grote datasets verwerken en veel gebruikers bedienen. Ten tweede zijn updates direct door te voeren, zodat modellen en functies uitgerold worden zonder hardware aan te passen. Bovendien maakt toegang op afstand het ideaal voor teams over de hele wereld, en verhoogt naadloze koppeling met andere cloudtools de efficiëntie van de automatisering.
Wilt u weten hoe we in een cloudgebaseerd computer-visionproject ruim 95% persoonsdetectie en 98% nauwkeurigheid bij gezichtsherkenning haalden, lees dan ons volledige succesverhaal.
Tips om de kosten van computer vision in de cloud te drukken
CV in de cloud biedt veel flexibiliteit, maar kan zonder optimalisatie flink in de papieren lopen. Hieronder enkele aanbevelingen om kostenefficienter te werken:
1. Gebruik spot-instances of preemptible vm’s
Platforms als AWS en GCP bieden sterk afgeprijsde rekenkracht voor niet-kritieke taken als modeltraining of batchverwerking.
2. Bewerk data alvast aan de clientzijde
Snijd beelden bij, schaal ze of comprimeer ze vóór het uploaden om kosten voor dataverkeer en opslag te beperken.
3. Gebruik serverless en inferentie op afroep
Laat GPU’s niet 24/7 draaien maar gebruik serverless endpoints (zoals AWS Lambda of de voorspeldienst van Vertex AI) die alleen aanslaan wanneer het nodig is.
4. Archiveer oude data
Verplaats zelden gebruikte beeld- en videobestanden naar goedkope archiefopslag om op termijn kosten te besparen.
Wat is uitrol van computer vision op de edge?
Uitrol op de edge plaatst het computer-visionmodel rechtstreeks op lokale apparaten zoals camera’s, industriële robots, drones of IoT-eenheden. In plaats van beelden naar een centrale server te sturen gebeurt de inferentie in realtime, direct bij de bron.
Die aanpak is vooral waardevol wanneer extreem lage latentie, beperkte connectiviteit of gegevensbescherming cruciaal is. Toepassingen als autonome voertuigen, industriële veiligheidsbewaking en mobiele robotica kunnen zich niet veroorloven op de cloud te wachten.
Computer vision op de edge is de beste keuze wanneer:
- Realtime beslissen nodig is (een machine meteen stilzetten zodra er een defect wordt gezien)
- De verbinding onbetrouwbaar of duur is (afgelegen fabrieken, booreilanden of akkers)
- Privacywetgeving het gebruik van de cloud beperkt (zorg of defensie)
Ondanks de voordelen op lange termijn brengt beginnen met computer vision op de edge een paar uitdagingen vooraf:
1) Gespecialiseerde hardware. AI-modellen lokaal draaien vraagt compacte maar krachtige apparaten als NVIDIA Jetson Nano/Xavier of Google Coral Edge TPU. Die edge-versnellers leveren GPU-achtige prestaties in een klein formaat, maar de hardware zelf telt op in de rekening, zeker bij honderden of duizenden eenheden.
2) Extra werk aan modeloptimalisatie. Niet elk CV-model draait zonder meer efficiënt op edge-hardware. Om binnen de grenzen van geheugen, verbruik en latentie te blijven moeten ontwikkelaars modellen vaak kwantiseren, overbodige lagen of neuronen snoeien en omzetten naar formaten als TensorRT, ONNX of TFLite.
Tips om de kosten van computer vision op de edge te drukken
Om de totale eigendomskosten van CV-systemen op de edge te verlagen, maakt u slimme afwegingen tussen prestaties, verbruik en functionaliteit:
Gebruik lichte modellen
Voor meer efficiëntie en minder rekenvraag kunt u zuinige architecturen als MobileNet of YOLO-Nano inzetten, die op goedkopere edge-apparaten draaien.
Pas modeloptimalisatie toe
Met technieken als kwantisatie en snoeien verkleint u het model en het verbruik aanzienlijk, waarbij u de afweging met nauwkeurigheid bewust maakt.
Kies het juiste hardwareniveau
Stem de hardware af op wat u werkelijk nodig hebt. Vraag u af of krachtigere apparaten echt nodig zijn: kleinere borden als de Jetson Nano of Coral volstaan vaak voor de taak.
Beperk wat het apparaat zelf doet
Houd alleen cruciale inferentietaken op het apparaat. Verplaats bijzaken (zoals loggen en rapporteren) elders naartoe om geheugen- en rekenvraag te beperken.
Wat is embedded uitrol van computer vision?
Embedded computer vision is de zuinigste manier om visuele intelligentie te draaien, met inferentie rechtstreeks op microcontrollers of zeer zuinige chips die zijn ingebouwd in apparaten als slimme sloten, barcodescanners en bewegingsgestuurde beveiligingscamera’s.
Deze aanpak verschilt van klassieke edge computing. Het gaat om technologie waarmee machine-learningmodellen worden gecomprimeerd en geoptimaliseerd voor apparaten met weinig geheugen en rekenkracht (TinyML).
Computer vision in embedded systemen is ideaal in de volgende situaties:
- Het stroomverbruik moet absoluut minimaal.
- blijven. Deze apparaten zijn gemaakt om te werken in offline of afgelegen omgevingen.
- Er is alleen basale beeldanalyse nodig, zoals het herkennen van een eenvoudige vorm of patroon.
- Realtimecommunicatie met de cloud is niet haalbaar of nodig
Maar embedded CV is nietgeschikt voor elke toepassing. Het ruilt diepgang in voor efficiëntie:
- Kan geen grote of diepe neurale netwerken draaien
- Beperkt tot eenvoudige classificatie of regelgebaseerde visiontaken
- Heeft moeite met variatie in belichting, bewegingsonscherpte of complexe achtergronden
- Vereist sterk geoptimaliseerde modellen, vaak in formaten als TFLite Micro of CMSIS-NN
Kortom: embedded vision past goed bij toepassingen die op schaal minimale intelligentie vragen, tegen lage kosten en verbruik.
Tips om de kosten van embedded computer vision te drukken
Om embedded computer-visionoplossingen betaalbaar en houdbaar te maken is het cruciaal elk onderdeel te optimaliseren:
Benut TinyML-frameworks
Gebruik voor zeer lichte modellen op minimale hardware geoptimaliseerde frameworks als TensorFlow Lite for Microcontrollers of Edge Impulse.
Ontwerp voor één taak
Houd de visiontaak smal, zoals barcodes lezen of vormen herkennen. Dat vereenvoudigt het model, verlaagt de geheugenbehoefte en drukt het verbruik.
Kies zeer zuinige hardware
Kies microcontrollers met ingebouwde visionondersteuning die genoeg rekenkracht voor inferentie bieden bij een minimaal energieverbruik.
Optimaliseer datastroom en opslag
Vermijd overmatig bufferen of loggen. Beelden worden in de stroom verwerkt en alleen belangrijke metadata of gebeurtenissen worden bewaard. Dat bespaart geheugen en verlengt de levensduur van het apparaat.
Welke uitrolvorm voor computer vision kiest u in 2025?
In 2025 winnen hybride architecturen flink terrein, doordat ze de realtime reactiesnelheid van edge computing combineren met de kracht en schaalbaarheid van cloudinfrastructuur.
Moderne CV-oplossingen kiezen steeds vaker voor hybride uitrolmodellen:
- De inferentie gebeurt op de edge (slimme camera’s, industriële robots) voor extreem lage latentie.
- Data gaat veilig naar de cloud voor centrale opslag, hertraining, analyse en dashboards.
Die combinatie biedt het beste van twee werelden: snelle lokale beslissingen én strategische inzichten op lange termijn, terwijl de cloudkosten voor bandbreedte-intensieve workloads als videostromen omlaag gaan.
Welke computer-visionarchitectuur past het beste bij uw bedrijf?
- CV in de cloud is ideaal voor bedrijven met grote datasets, complexe analyses of de behoefte om snel over landsgrenzen heen op te schalen. Het wordt vaak gekozen door zakelijke SaaS-platforms, aanbieders van retailanalyse en fabrikanten met meerdere vestigingen.
- CV op de edge past goed bij sectoren die realtime beslissingen en veel privacy vragen, zoals automotive, medische apparatuur en slimme fabrieken. Het werkt het beste als er ter plaatse infrastructuur is (stroom en rekenkracht), terwijl de internetverbinding wisselvallig is of latentie niet acceptabel is.
- Embedded CV past bij nichetoepassingen met zeer laag verbruik, zoals slimme sloten, barcodelezers, wearables en IoT-sensoren. Het is geschikt voor bedrijven die basale beeldherkenning nodig hebben in afgelegen of beperkte omgevingen, zonder de cloud.
U hoeft overigens niet voor één optie te kiezen. Veel van de meest effectieve oplossingen van vandaag combineren meerdere uitrolvormen.
Twijfelt u nog welke opzet bij uw toepassing past?
Onze engineers helpen u uw behoeften in kaart te brengen en adviseren de voordeligste uitrolstrategie. Plan een gratis adviesgesprek voor deskundig advies over het bouwen van schaalbare, efficiënte visionsystemen met kunstmatige intelligentie.
Conclusie
Bij het ontwikkelen van computer vision is de uitrolarchitectuur een strategische knop. De keuze tussen cloud, edge en embedded heeft op lange termijn vaak meer invloed op de kosten dan de complexiteit van het model of het aantal functies.
Door de latentie-eisen, privacyvereisten en rekenbeperkingen van uw CV-systeem af te stemmen op de juiste opzet verlaagt u de infrastructuurkosten aanzienlijk, zonder in te leveren op prestaties of schaalbaarheid.