
Datorseende används allt oftare i arbetsprocesser inom många branscher. Att utveckla och införa AI-drivna system för datorseende kan dock vara kostsamt. Även om modellutveckling har blivit mer tillgänglig tack vare förtränade arkitekturer och bibliotek med öppen källkod ligger den verkliga kostnadsutmaningen ofta i driftsättningen. Beslut om hosting, inferens, lagring och infrastruktur kan påverka den långsiktiga avkastningen avsevärt.
I den här artikeln undersöker vi hur olika strategier för driftsättning (i molnet, på edge och inbyggt) påverkar både kostnad och prestanda. Du får veta var kostnaderna kommer ifrån, vilken arkitektur som passar ditt användningsfall och hur du fattar smartare beslut som håller budgeten för datorseende under kontroll.
- Arkitekturen för driftsättning är den största kostnadsdrivaren inom datorseende, där hosting, inferens, dataöverföring och underhåll avgör den långsiktiga avkastningen.
- Molnbaserat datorseende ger oöverträffad skalbarhet och snabb iteration, men okontrollerad GPU-användning, kontinuerlig videoströmning och växande lagring kan snabbt blåsa upp driftkostnaderna.
- Edge-drift flyttar kostnaderna från löpande molnutgifter till en initial investering i hårdvara och ger lägre latens, bättre integritet och förutsägbara långsiktiga kostnader för realtidsanvändning.
- Inbyggt datorseende ger lägst kostnad per enhet i stor skala genom att köra kraftigt optimerade modeller på hårdvara med extremt låg strömförbrukning (men stöder bara smala, uppgiftsspecifika arbetslaster).
- Hybridarkitekturer presterar allt oftare bättre än lösningar med en enda driftform genom att hålla realtidsinferens på edge- eller inbyggda enheter och samtidigt samla träning, analys och övervakning i molnet.
- Verkliga kostnadsminskningar kommer av att anpassa krav på latens, integritet och prestanda till den enklaste driftmodell som fungerar.
Vad driver kostnaderna för datorseende?
Övergripande kommer den totala kostnaden för att bygga och driva ett system för datorseende från fyra huvudområden: utveckling, data, infrastruktur och långsiktigt underhåll.
- Utvecklingsprocessen omfattar skräddarsydd kod, träning av modeller och sömlös integration av CV i befintliga system.
- Kostnader för data kommer från insamling och märkning av visuella dataset, särskilt när noggrannhetskraven kräver egna, branschspecifika data.
- Infrastruktur omfattar den beräkningskapacitet och lagring som krävs för att träna och driftsätta modeller, oavsett om det sker i molnet eller på enheten.
- Underhåll omfattar löpande uppdateringar, övervakning, MLOps-arbetsflöden och att teamet har kapacitet att stödja systemet på lång sikt.
Var och en av dessa komponenter skalar olika beroende på hur och var modellerna driftsätts, särskilt när man väljer mellan edge-enheter och molnbaserad inferens.
För en fullständig genomgång av varje kostnadskategori, läs vår fördjupade guide: Guiden för 2025 till utveckling av datorseende: kostnader, process och teknikstack
Så väljer du rätt driftmodell för datorseende: moln, edge eller inbyggt?
När du driftsätter datorseende kan den arkitektur du väljer (moln, edge eller inbyggt) påverka prestanda, skalbarhet och kostnadsstruktur avsevärt.

Molnbaserat datorseende är ofta förstahandsvalet för företag som vill ha skalbarhet och enkel integration. Du kan träna och driftsätta mycket komplexa modeller, få tillgång till närmast obegränsad lagring och beräkningskraft och använda hanterade tjänster. Fördelarna har dock ett pris: betalning efter användning kan växa snabbt med datamängden, särskilt vid kontinuerlig videoströmning, GPU-tid för inferens och lagring.
Edge-drift innebär i stället att modellerna körs direkt på lokala enheter. Även om den initiala hårdvarukostnaden är betydande är det en långsiktig investering som lönar sig tack vare låg latens och minimala löpande kostnader för dataöverföring. Arkitekturen passar bra för CV-tillämpningar i realtid, som kvalitetskontroll på en produktionslinje eller autonom navigering.
Inbyggt datorseende (som ofta körs på mikrokontroller eller specialiserade AI-chip) är det mest kostnadseffektiva på lång sikt. Systemen är byggda för specifika uppgifter med strikta begränsningar för ström, minne och modellstorlek. De passar inte för komplexa arbetslaster, men är idealiska för enkla, billiga uppgifter i stora volymer som räkning av objekt, enkel feldetektering eller streckkodsskanning. Det finns inga molnavgifter, inget beroende av uppkoppling och nästan ingen latens.
Varje tillvägagångssätt innebär avvägningar mellan flexibilitet, prestanda och kostnadseffektivitet. Därför använder många moderna system en hybridarkitektur, där lätta uppgifter hanteras på edge eller på inbyggda enheter medan tung träning och analys sker i molnet.
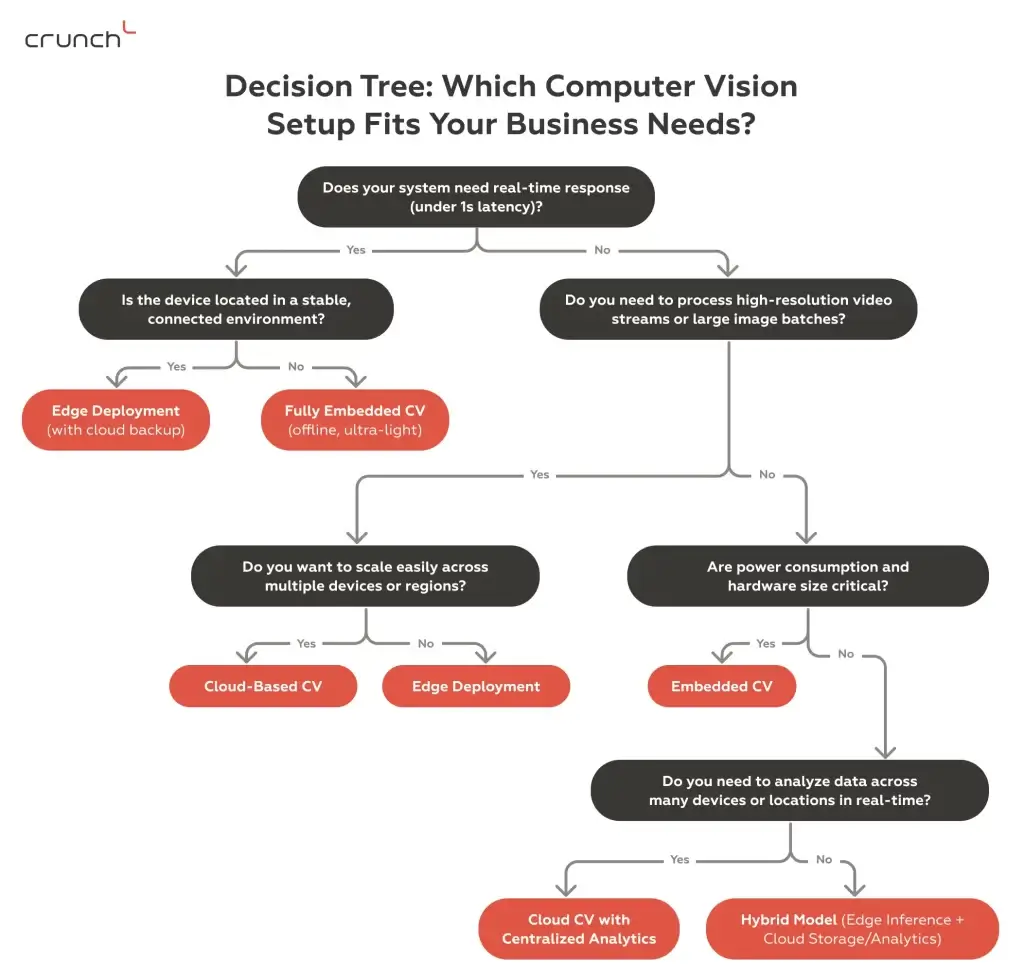
Använd det här flödesschemat för att hitta den lämpligaste driftarkitekturen (moln, edge eller inbyggt) utifrån latens, ström, integritet, skala och begränsningar i användningsfallet.
Molnbaserat datorseende: AWS, GCP, Azure
Molnbaserad driftsättning av datorseende innebär att dina AI-modeller – till exempel för bildigenkänning, objektdetektering eller videoanalys – körs på externa molnservrar i stället för lokala enheter. I den här lösningen skickas visuella data till molnet, där kraftfulla GPU:er eller TPU:er bearbetar dem och returnerar insikter, prognoser eller larm.
Nedan ser du hur system för datorseende vanligtvis driftsätts på de största molnplattformarna som Amazon Web Services (AWS), Google Cloud Platform (GCP) och Microsoft Azure:
AWS för driftsättning av datorseende
Skräddarsydda modeller tränas vanligtvis på GPU-drivna EC2-instanser eller Amazon SageMaker och driftsätts sedan som skalbara endpoints via SageMaker eller i containrar med ECS/EKS. Modellartefakter och dataset lagras i S3. För bild- eller videoströmmar i realtid kan Rekognition eller Kinesis användas i hybridlösningar tillsammans med egna modeller.
Google Cloud för tillämpningar inom datorseende
Med Vertex AI kan utvecklare träna, finjustera och driftsätta modeller för datorseende på fullt hanterad infrastruktur. Modellerna serveras via endpoints och integreras i applikationer med REST-API:er. Google Cloud Storage används ofta för att lagra bilddataset. CV-modeller kan också kombineras med färdiga verktyg som Cloud Vision API när bara delvis anpassning behövs.
Azure för skräddarsydda arbetslaster inom datorseende
Azure stöder driftsättning av skräddarsydda modeller för datorseende med Azure Machine Learning och Kubernetes Service. Modellerna tränas antingen i Jupyter-baserade ML Studio eller i Docker-containrar och lagras i Blob Storage. Inferens kan ske i molnet eller på edge-enheter med Azure IoT Edge och ONNX Runtime.
Valet av rätt moln beror på projektets krav på latens, budget och driftstrategi (centraliserad vs. edge).
Molnbaserat datorseende har flera viktiga fördelar. För det första gör den starka skalbarheten det enkelt att bearbeta stora dataset och betjäna många användare. För det andra stöder den omedelbara uppdateringar, så att modeller och funktioner kan rullas ut utan hårdvaruändringar. Dessutom gör fjärråtkomst den idealisk för globala team, och sömlös integration med andra molnverktyg ökar den totala automatiseringsgraden.
Vill du se hur vi uppnådde över 95 % noggrannhet i persondetektering och 98 % i ansiktsigenkänning i ett molnbaserat projekt för datorseende, läs hela vår framgångshistoria.
Tips för kostnadsoptimering av molnbaserat datorseende
Molnbaserad CV ger stor flexibilitet, men kan också medföra betydande kostnader om den inte optimeras på rätt sätt. Här är några rekommendationer för bättre kostnadseffektivitet:
1. Använd spot-instanser eller preemptible VM:er
Plattformar som AWS och GCP erbjuder beräkningskraft med stora rabatter för icke-kritiska jobb som modellträning eller batchbearbetning.
2. Förbearbeta data på klientsidan
Beskär, skala ner eller komprimera bilder före uppladdning för att minska kostnaderna för dataöverföring och lagring.
3. Använd serverlös inferens vid behov
I stället för att köra GPU:er dygnet runt kan du använda serverlösa endpoints (som AWS Lambda eller prognostjänsten i Vertex AI) som bara aktiveras vid behov.
4. Arkivera gamla data
Flytta sällan använda bild- och videofiler till kall lagring för att spara kostnader på lång sikt.
Vad är driftsättning av datorseende på edge?
Edge-drift placerar modellen för datorseende direkt på lokala enheter som kameror, industrirobotar, drönare eller IoT-enheter. I stället för att skicka visuella data till en central server utförs inferensen i realtid (direkt vid källan).
Det här tillvägagångssättet är särskilt värdefullt när extremt låg latens, begränsad uppkoppling eller dataskydd är avgörande. Användningsfall som självkörande fordon, övervakning av industrisäkerhet och mobil robotik har ofta inte råd att vänta på svar från molnet.
Datorseende på edge är det idealiska valet när:
- Beslut i realtid krävs (en maskin måste stoppas direkt när ett fel upptäcks)
- Uppkopplingen är instabil eller dyr (i avlägsna fabriker, på oljeplattformar eller jordbruksfält)
- Regler om dataskydd begränsar användningen av molnet (vård- eller försvarsmiljöer)
Trots de långsiktiga fördelarna innebär det några inledande utmaningar att komma igång med datorseende på edge:
1) Specialiserad hårdvara. För att köra AI-modeller lokalt krävs kompakta men kraftfulla enheter som NVIDIA Jetson Nano/Xavier eller Google Coral Edge TPU. Dessa acceleratorer ger GPU-liknande prestanda i små format, men hårdvaran ökar notan, särskilt när man skalar till hundratals eller tusentals enheter.
2) Extra arbete med modelloptimering. Alla CV-modeller körs inte effektivt på edge-hårdvara direkt. För att uppfylla kraven på minne, ström och latens behöver utvecklare ofta kvantisera modeller, ta bort onödiga lager eller neuroner och konvertera till format som TensorRT, ONNX eller TFLite.
Tips för kostnadsoptimering av datorseende på edge
För att minska den totala ägandekostnaden för CV-system på edge bör du göra smarta avvägningar mellan prestanda, ström och funktionalitet:
Använd lätta modeller
För att optimera effektiviteten och minska beräkningsbehovet bör du överväga effektiva arkitekturer som MobileNet eller YOLO-Nano, som kan köras på billigare edge-enheter.
Använd tekniker för modelloptimering
Med tekniker som kvantisering och beskärning går det att minska modellstorlek och strömförbrukning avsevärt och samtidigt hantera avvägningarna mot noggrannhet.
Välj rätt hårdvarunivå
Det är viktigt att matcha hårdvaran med de faktiska prestandabehoven. Överväg om det verkligen behövs kraftfullare enheter, eftersom mindre kort som Jetson Nano eller Coral kan räcka för uppgiften.
Begränsa funktionaliteten på enheten
Behåll bara de kritiska inferensuppgifterna på enheten. Flytta icke-väsentliga arbetslaster (t.ex. loggning och rapportering) för att minska kraven på minne och bearbetning.
Vad är inbyggd driftsättning av datorseende?
Inbyggt datorseende är det mest resurseffektiva sättet att köra visuell intelligens, med inferens direkt på mikrokontroller eller chip med extremt låg strömförbrukning inbyggda i enheter som smarta lås, streckkodsläsare och rörelseaktiverade säkerhetskameror.
Det här tillvägagångssättet skiljer sig från den vanliga implementeringen av edge computing. Det är en teknik som gör det möjligt att komprimera och optimera maskininlärningsmodeller för enheter med begränsat RAM och beräkningskraft (TinyML).
Inbyggda system för datorseende är idealiska i följande situationer:
- Strömförbrukningen måste hållas på ett absolut minimum.
- Enheterna är utformade för att fungera i frånkopplade eller avlägsna miljöer.
- Bara enkel visuell analys behövs, som att känna igen en enkel form eller ett mönster.
- Kommunikation med molnet i realtid är varken möjlig eller nödvändig
Men inbyggt CV passar inte alla användningsfall. Det byter djup mot effektivitet:
- Kan inte köra stora eller djupa neurala nätverk
- Begränsat till enkel klassificering eller regelbaserade synuppgifter
- Har svårt med variationer i ljus, rörelseoskärpa eller komplexa bakgrunder
- Kräver kraftigt optimerade modeller, ofta i format som TFLite Micro eller CMSIS-NN
Kort sagt passar inbyggt datorseende bra för tillämpningar som kräver minimal intelligens i stor skala, med låga kostnader och låg energiförbrukning.
Tips för kostnadsoptimering av inbyggt datorseende
För att göra inbyggda lösningar för datorseende kostnadseffektiva och hållbara är det avgörande att optimera varje del:
Använd TinyML-ramverk
För att köra ultralätta modeller på minimal hårdvara kan du använda optimerade ramverk som TensorFlow Lite for Microcontrollers eller Edge Impulse.
Utforma för en enda uppgift
För att optimera effektiviteten och minimera resursförbrukningen är det viktigt att hålla synuppgiften snävt definierad, till exempel streckkodsläsning eller formigenkänning. Det förenklar modellen, minskar minnesbehovet och sänker strömförbrukningen.
Välj hårdvara med extremt låg strömförbrukning
Välj mikrokontroller med inbyggt stöd för bildbehandling som ger tillräcklig beräkningskraft för inferens och samtidigt minimal energiförbrukning.
Optimera dataflöde och lagring
Undvik överdriven buffring eller loggning. Bearbeta bilder löpande och lagra bara viktiga metadata eller händelser. Det sparar minne och förlänger enhetens livslängd.
Vilken typ av driftsättning av datorseende bör du välja 2025?
Under 2025 vinner hybridarkitekturer stark mark genom att kombinera realtidsresponsen hos edge computing med molninfrastrukturens kraft och skalbarhet.
Moderna CV-lösningar föredrar i allt högre grad hybrida driftmodeller:
- Inferensen utförs på edge (smarta kameror, industrirobotar) för att säkerställa extremt låg latens.
- Data överförs säkert till molnet för central lagring, omträning, analys och dashboards.
Kombinationen ger det bästa av två världar: snabba, lokala beslut och strategiska insikter på lång sikt, samtidigt som molnkostnaderna minskar för bandbreddskrävande arbetslaster som videoströmmar.
Vilken arkitektur för datorseende passar ditt företag bäst?
- Molnbaserad CV är idealisk för företag som hanterar stora dataset, kör komplexa analyser eller behöver skala snabbt över geografier. Den väljs ofta av SaaS-plattformar för stora företag, leverantörer av detaljhandelsanalys och tillverkare med flera anläggningar.
- Edge-CV passar branscher som kräver beslut i realtid och hög integritet, som fordonsindustrin, medicintekniska produkter och smarta fabriker. Den fungerar bäst när det finns infrastruktur på plats (ström och beräkningskraft), men internetuppkopplingen är instabil eller latens inte kan accepteras.
- Inbyggd CV passar nischtillämpningar med extremt låg strömförbrukning som smarta lås, streckkodsläsare, bärbara enheter och IoT-sensorer. Den passar företag som behöver enkel visuell igenkänning i avlägsna eller begränsade miljöer utan att vara beroende av molnet.
Du är inte tvungen att välja bara ett alternativ. Många av dagens mest effektiva lösningar kombinerar flera driftmodeller.
Fortfarande osäker på vilken lösning som passar ditt användningsfall?
Våra ingenjörer kan hjälpa dig att bedöma behoven och rekommendera den mest kostnadseffektiva driftstrategin. Boka en kostnadsfri konsultation för expertvägledning om hur du bygger skalbara och effektiva system för artificiell intelligens och datorseende.
Slutsats
Inom utveckling av datorseende är driftarkitekturen en strategisk hävstång. Valet mellan moln, edge och inbyggd drift kan ha större långsiktig betydelse för kostnaderna än modellens komplexitet eller antalet funktioner.
Genom att anpassa CV-systemets krav på latens, dataskydd och beräkningsbegränsningar till rätt lösning kan du minska infrastrukturkostnaderna avsevärt utan att kompromissa med prestanda eller skalbarhet.