
Computer vision bliver i stigende grad brugt i arbejdsprocesser på tværs af brancher. Udvikling og implementering af AI-drevne computer vision-systemer kan dog være dyrt. Selvom modeludvikling er blevet mere tilgængelig takket være fortrænede arkitekturer og open source-biblioteker, ligger den reelle omkostningsudfordring ofte i idriftsættelsen. Beslutninger om hosting, inferens, lagring og infrastruktur kan have stor betydning for det langsigtede afkast.
I denne artikel ser vi på, hvordan forskellige strategier for idriftsættelse (i skyen, på edge og indlejret) påvirker både omkostninger og ydeevne. Du får at vide, hvor omkostningerne kommer fra, hvilken arkitektur der passer til dit brugsscenarie, og hvordan du træffer klogere beslutninger, der holder budgettet for computer vision under kontrol.
- Arkitekturen for idriftsættelse er den største omkostningsdriver inden for computer vision, og hosting, inferens, dataoverførsel og vedligeholdelse afgør det langsigtede afkast.
- Cloudbaseret computer vision giver uovertruffen skalerbarhed og hurtig iteration, men ukontrolleret GPU-forbrug, kontinuerlig videostreaming og voksende lagring kan hurtigt puste driftsomkostningerne op.
- Edge-drift flytter omkostningerne fra løbende cloududgifter til en forudgående investering i hardware og giver lavere latenstid, bedre privatliv og forudsigelige langsigtede udgifter til realtidsbrug.
- Indlejret computer vision giver den laveste pris pr. enhed i stor skala ved at køre stærkt optimerede modeller på hardware med ekstremt lavt strømforbrug (men understøtter kun snævre, opgavespecifikke arbejdsbelastninger).
- Hybride arkitekturer klarer sig i stigende grad bedre end løsninger med én driftsform ved at holde realtidsinferens på edge- eller indlejrede enheder og samtidig samle træning, analyse og overvågning i skyen.
- Mærkbare besparelser opnås ved at afstemme krav til latenstid, privatliv og ydeevne med den enkleste driftsmodel, der virker.
Hvad driver omkostningerne ved computer vision?
Overordnet kommer de samlede omkostninger ved at bygge og drive et computer vision-system fra fire hovedområder: udvikling, data, infrastruktur og langsigtet vedligeholdelse.
- Udviklingsprocessen omfatter skræddersyet kode, træning af modeller og problemfri integration af CV i eksisterende systemer.
- Omkostninger til data kommer fra indsamling og mærkning af visuelle datasæt, især når nøjagtighedskravet kræver egne, branchespecifikke data.
- Infrastruktur omfatter den regnekraft og lagerkapacitet, der skal til for at træne og drive modeller, uanset om det sker i skyen eller på enheden.
- Vedligeholdelse omfatter løbende opdateringer, overvågning, MLOps-workflows og at teamet har kapacitet til at understøtte systemet på lang sigt.
Hver af disse komponenter skalerer forskelligt afhængigt af, hvordan og hvor modellerne sættes i drift, især når man vælger mellem edge-enheder og cloudbaseret inferens.
For en komplet gennemgang af hver omkostningskategori, se vores dybdegående guide: Guiden for 2025 til udvikling af computer vision: omkostninger, proces og teknologistak
Sådan vælger du den rette driftsmodel for computer vision: cloud, edge eller indlejret?
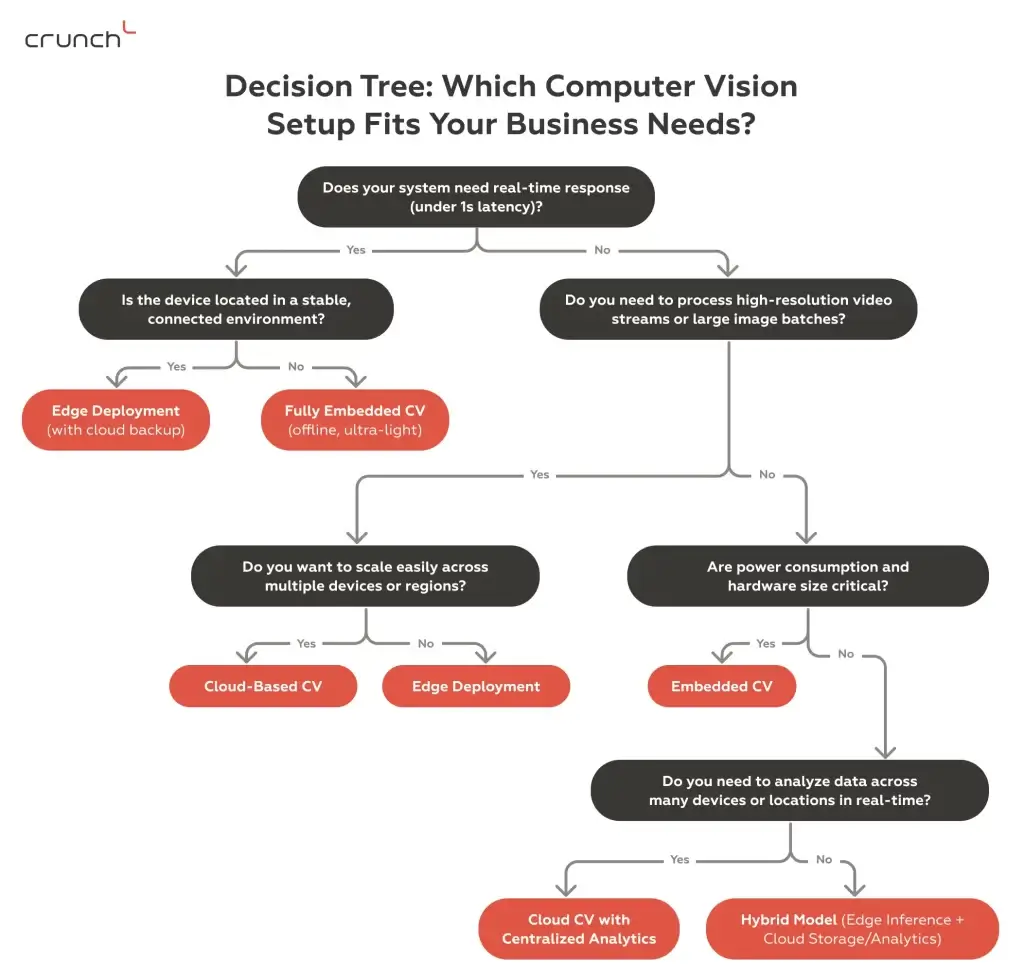
Når du sætter computer vision i drift, kan den valgte arkitektur (cloud, edge eller indlejret) have stor betydning for ydeevne, skalerbarhed og omkostningsstruktur.

Cloudbaseret computer vision er ofte førstevalget for virksomheder, der ønsker skalerbarhed og nem integration. Du kan træne og drive meget komplekse modeller, få adgang til næsten ubegrænset lagring og regnekraft og bruge administrerede tjenester. Fordelene har dog en pris: betaling efter forbrug kan vokse hurtigt med datamængden, især ved kontinuerlig videostreaming, GPU-tid til inferens og lagring.
Edge-drift betyder derimod, at modellerne kører direkte på lokale enheder. Selvom den første hardwareudgift er betydelig, er det en langsigtet investering, der betaler sig hjem takket være lav latenstid og minimale løbende omkostninger til dataoverførsel. Arkitekturen passer godt til CV-applikationer i realtid, såsom kvalitetskontrol på en produktionslinje eller autonom navigation.
Indlejret computer vision (der ofte kører på mikrocontrollere eller specialiserede AI-chips) er den mest omkostningseffektive på lang sigt. Systemerne er bygget til bestemte opgaver med strenge begrænsninger på strøm, hukommelse og modelstørrelse. De egner sig ikke til komplekse arbejdsbelastninger, men er ideelle til enkle, billige opgaver i stor volumen som optælling af objekter, enkel fejldetektion eller stregkodescanning. Der er ingen cloudgebyrer, ingen afhængighed af netværk og næsten ingen latenstid.
Hver tilgang indebærer afvejninger mellem fleksibilitet, ydeevne og omkostningseffektivitet. Derfor bruger mange moderne systemer en hybrid arkitektur, hvor lette opgaver håndteres på edge eller på indlejrede enheder, mens tung træning og analyse foregår i skyen.
Brug dette flowchart til at finde den bedst egnede driftsarkitektur (cloud, edge eller indlejret) ud fra latenstid, strøm, privatliv, skala og begrænsninger i brugsscenariet.
Cloudbaseret computer vision: AWS, GCP, Azure
Cloudbaseret drift af computer vision betyder, at dine AI-modeller – for eksempel til billedgenkendelse, objektdetektion eller videoanalyse – kører på eksterne cloudservere i stedet for lokale enheder. I dette setup sendes visuelle data til skyen, hvor kraftige GPU’er eller TPU’er behandler dem og returnerer indsigt, forudsigelser eller advarsler.
Nedenfor ser du, hvordan computer vision-systemer typisk sættes i drift på de største cloudplatforme som Amazon Web Services (AWS), Google Cloud Platform (GCP) og Microsoft Azure:
AWS til drift af computer vision
Skræddersyede modeller trænes typisk på GPU-drevne EC2-instanser eller Amazon SageMaker og sættes derefter i drift som skalerbare endpoints via SageMaker eller i containere med ECS/EKS. Modelartefakter og datasæt gemmes i S3. Til billed- eller videostreams i realtid kan Rekognition eller Kinesis bruges i hybride setups sammen med egne modeller.
Google Cloud til computer vision-applikationer
Med Vertex AI kan udviklere træne, finjustere og drive computer vision-modeller på fuldt administreret infrastruktur. Modellerne serveres via endpoints og integreres i applikationer med REST-API’er. Google Cloud Storage bruges ofte til at gemme billeddatasæt. CV-modeller kan også kombineres med færdige værktøjer som Cloud Vision API, når der kun er brug for delvis tilpasning.
Azure til skræddersyede computer vision-arbejdsbelastninger
Azure understøtter drift af skræddersyede computer vision-modeller med Azure Machine Learning og Kubernetes Service. Modellerne trænes enten i det Jupyter-baserede ML Studio eller i Docker-containere og gemmes i Blob Storage. Inferens kan ske i skyen eller på edge-enheder med Azure IoT Edge og ONNX Runtime.
Valget af den rette cloud afhænger af projektets krav til latenstid, budget og driftsstrategi (centraliseret vs. edge).
Cloudbaseret computer vision har flere vigtige fordele. For det første gør den stærke skalerbarhed det nemt at behandle store datasæt og betjene mange brugere. For det andet understøtter den øjeblikkelige opdateringer, så modeller og funktioner kan rulles ud uden ændringer i hardwaren. Desuden gør fjernadgang den ideel til globale teams, og problemfri integration med andre cloudværktøjer øger den samlede automatisering.
Hvis du vil se, hvordan vi opnåede over 95 % nøjagtighed i persondetektion og 98 % i ansigtsgenkendelse i et cloudbaseret computer vision-projekt, så læs hele vores succeshistorie.
Tips til omkostningsoptimering af cloudbaseret computer vision
Cloudbaseret CV giver stor fleksibilitet, men kan også medføre betydelige omkostninger, hvis den ikke optimeres korrekt. Her er nogle anbefalinger til bedre omkostningseffektivitet:
1. Brug spot-instanser eller preemptible VM’er
Platforme som AWS og GCP tilbyder regnekraft med store rabatter til ikke-kritiske jobs som modeltræning eller batchbehandling.
2. Forbehandl data på klientsiden
Beskær, nedskaler eller komprimer billeder før upload for at reducere omkostningerne til dataoverførsel og lagring.
3. Brug serverless inferens efter behov
I stedet for at køre GPU’er døgnet rundt kan du bruge serverless endpoints (som AWS Lambda eller forudsigelsestjenesten i Vertex AI), der kun aktiveres efter behov.
4. Arkivér gamle data
Flyt sjældent brugte billed- og videofiler til kold lagring for at spare omkostninger på lang sigt.
Hvad er drift af computer vision på edge?
Edge-drift placerer computer vision-modellen direkte på lokale enheder som kameraer, industrirobotter, droner eller IoT-enheder. I stedet for at sende visuelle data til en central server udføres inferensen i realtid (lige ved kilden).
Denne tilgang er særlig værdifuld, når ekstremt lav latenstid, begrænset forbindelse eller databeskyttelse er afgørende. Brugsscenarier som selvkørende køretøjer, overvågning af industrisikkerhed og mobil robotteknik har ofte ikke råd til at vente på svar fra skyen.
Computer vision på edge er det ideelle valg, når:
- Beslutninger i realtid er nødvendige (en maskine skal stoppes med det samme, når en fejl opdages)
- Forbindelsen er ustabil eller dyr (på fjerntliggende fabrikker, boreplatforme eller marker)
- Regler om databeskyttelse begrænser brugen af skyen (sundheds- eller forsvarsmiljøer)
Trods de langsigtede fordele indebærer det nogle indledende udfordringer at komme i gang med computer vision på edge:
1) Specialiseret hardware. For at køre AI-modeller lokalt kræves kompakte, men kraftige enheder som NVIDIA Jetson Nano/Xavier eller Google Coral Edge TPU. Disse acceleratorer giver GPU-lignende ydeevne i små formater, men hardwaren øger regningen, især når man skalerer til hundredvis eller tusindvis af enheder.
2) Ekstra arbejde med modeloptimering. Ikke alle CV-modeller kører effektivt på edge-hardware uden videre. For at opfylde kravene til hukommelse, strøm og latenstid skal udviklere ofte kvantisere modeller, fjerne unødvendige lag eller neuroner og konvertere til formater som TensorRT, ONNX eller TFLite.
Tips til omkostningsoptimering af computer vision på edge
For at reducere de samlede ejeromkostninger for CV-systemer på edge bør du foretage kloge afvejninger mellem ydeevne, strøm og funktionalitet:
Brug lette modeller
For at optimere effektiviteten og reducere behovet for regnekraft bør du overveje effektive arkitekturer som MobileNet eller YOLO-Nano, der kan køre på billigere edge-enheder.
Brug teknikker til modeloptimering
Med teknikker som kvantisering og beskæring er det muligt at reducere modelstørrelse og strømforbrug markant og samtidig håndtere afvejningerne mod nøjagtighed.
Vælg det rette hardwareniveau
Det er vigtigt at matche hardwaren med de faktiske krav til ydeevne. Overvej, om det er nødvendigt at investere i kraftigere enheder, da mindre boards som Jetson Nano eller Coral kan være tilstrækkelige til opgaven.
Begræns funktionaliteten på enheden
Behold kun de kritiske inferensopgaver på enheden. Flyt ikke-væsentlige arbejdsbelastninger (f.eks. logning og rapportering) væk for at reducere kravene til hukommelse og behandling.
Hvad er indlejret drift af computer vision?
Indlejret computer vision er den mest ressourceeffektive måde at køre visuel intelligens på, med inferens direkte på mikrocontrollere eller chips med ekstremt lavt strømforbrug indbygget i enheder som smarte låse, stregkodescannere og bevægelsesaktiverede sikkerhedskameraer.
Denne tilgang adskiller sig fra den almindelige implementering af edge computing. Det er en teknologi, der gør det muligt at komprimere og optimere maskinlæringsmodeller til enheder med begrænset RAM og regnekraft (TinyML).
Indlejrede systemer til computer vision er ideelle i følgende situationer:
- Strømforbruget skal holdes på et absolut minimum.
- Enhederne er designet til at fungere i offline eller fjerntliggende miljøer.
- Der er kun brug for enkel visuel analyse, som at genkende en simpel form eller et mønster.
- Kommunikation med skyen i realtid er hverken mulig eller nødvendig
Men indlejret CV passer ikke til alle brugsscenarier. Den bytter dybde for effektivitet:
- Kan ikke køre store eller dybe neurale netværk
- Begrænset til enkel klassifikation eller regelbaserede visionsopgaver
- Har svært ved variation i lys, bevægelsesslør eller komplekse baggrunde
- Kræver stærkt optimerede modeller, ofte i formater som TFLite Micro eller CMSIS-NN
Kort sagt egner indlejret vision sig godt til applikationer, der kræver minimal intelligens i stor skala, med lave omkostninger og lavt energiforbrug.
Tips til omkostningsoptimering af indlejret computer vision
For at gøre indlejrede computer vision-løsninger omkostningseffektive og bæredygtige er det afgørende at optimere hvert element:
Udnyt TinyML-frameworks
For at køre ultralette modeller på minimal hardware kan du bruge optimerede frameworks som TensorFlow Lite for Microcontrollers eller Edge Impulse.
Design til én opgave
For at optimere effektiviteten og minimere ressourceforbruget er det vigtigt at holde visionsopgaven snævert defineret, for eksempel stregkodelæsning eller formgenkendelse. Det forenkler modellen, reducerer hukommelsesbehovet og sænker strømforbruget.
Vælg hardware med ekstremt lavt strømforbrug
Vælg mikrocontrollere med indbygget understøttelse af billedbehandling, der giver tilstrækkelig regnekraft til inferens og samtidig minimalt energiforbrug.
Optimer dataflow og lagring
Undgå overdreven buffering eller logning. Behandl billeder løbende, og gem kun vigtige metadata eller hændelser. Det sparer hukommelse og forlænger enhedens levetid.
Hvilken type drift af computer vision bør du vælge i 2025?
I 2025 vinder hybride arkitekturer markant frem ved at kombinere edge computings realtidsrespons med cloudinfrastrukturens kraft og skalerbarhed.
Moderne CV-løsninger foretrækker i stigende grad hybride driftsmodeller:
- Inferensen udføres på edge (smarte kameraer, industrirobotter) for at sikre ekstremt lav latenstid.
- Data overføres sikkert til skyen til central lagring, gentræning, analyse og dashboards.
Kombinationen giver det bedste fra begge verdener: hurtige, lokale beslutninger og strategisk indsigt på lang sigt, samtidig med at cloudomkostningerne reduceres for båndbreddekrævende arbejdsbelastninger som videostreams.
Hvilken computer vision-arkitektur passer bedst til din virksomhed?
- Cloudbaseret CV er ideelt for virksomheder, der håndterer store datasæt, kører komplekse analyser eller skal skalere hurtigt på tværs af geografier. Det vælges ofte af SaaS-platforme til store virksomheder, udbydere af detailanalyse og producenter med flere fabrikker.
- Edge-CV passer godt til brancher, der kræver beslutninger i realtid og høj databeskyttelse, som bilindustrien, medicinsk udstyr og smarte fabrikker. Det fungerer bedst, når der er infrastruktur på stedet (strøm og regnekraft), men internetforbindelsen er ustabil, eller latenstid ikke kan accepteres.
- Indlejret CV passer godt til nicheapplikationer med ekstremt lavt strømforbrug som smarte låse, stregkodelæsere, wearables og IoT-sensorer. Det passer til virksomheder, der har brug for enkel visuel genkendelse i fjerntliggende eller begrænsede miljøer uden at være afhængige af skyen.
Du er ikke forpligtet til kun at vælge én mulighed. Mange af nutidens mest effektive løsninger kombinerer flere driftsmodeller.
Stadig i tvivl om, hvilket setup der passer til dit brugsscenarie?
Vores ingeniører kan hjælpe dig med at vurdere behovene og anbefale den mest omkostningseffektive driftsstrategi. Book en gratis konsultation og få ekspertrådgivning om at bygge skalerbare og effektive systemer til kunstig intelligens og computer vision.
Konklusion
I udvikling af computer vision er driftsarkitekturen et strategisk greb. Valget mellem cloud, edge og indlejret drift kan have større langsigtet betydning for omkostningerne end modellens kompleksitet eller antallet af funktioner.
Ved at afstemme CV-systemets krav til latenstid, databeskyttelse og regnekraft med det rette setup kan du reducere infrastrukturomkostningerne markant uden at gå på kompromis med ydeevne eller skalerbarhed.