Een team van tien mensen, en de helft ervan staat te wachten. De backend-lead wacht op requirements. QA wacht op de backend. De projectmanager besteedt elke standup aan het verzamelen van statussen in plaats van het wegnemen van obstakels. De schatting zei acht maanden, en elke week coördinatie maakt dat getal moeilijker te verdedigen.
Toen een Britse fabrikant ons een project van precies die omvang bracht — een maatwerksysteem, geïntegreerd met SAP, ter vervanging van transportbandprocessen die op spreadsheets draaiden — zou een traditioneel team die acht maanden nodig hebben gehad. Een AI Pod van vier senior specialisten leverde de MVP in drie, terwijl de fabriek de hele tijd doordraaide op haar bestaande SAP- en Google Sheets-data.
Dat resultaat komt voort uit een andere manier om levering te structureren, en dit artikel legt uit hoe dat werkt: wat een AI Pod is, waar de snelheid vandaan komt, wat het kost ten opzichte van een traditioneel team, en waar het model past.
Wat is het AI Pod-model? Een AI Pod is een compact leveringsteam van 3–5 senior specialisten die werken met AI-agents die door de hele softwareontwikkelingscyclus zijn ingebed. De AI in softwareontwikkeling neemt het volume voor haar rekening — codegeneratie, testdekking, documentatie, concept-requirements — terwijl de engineers elke beslissing bezitten: architectuur, review en verantwoordelijkheid voor elke regel die live gaat. Het team blijft klein, waardoor de coördinatielast die met de teamomvang meegroeit nooit ontstaat.
Voor een diepere blik op hoe AI in de afzonderlijke SDLC-fasen wordt ingebed, zie onze gids over AI-gedreven engineering door de hele softwareontwikkelingscyclus.
- Een AI Pod bestaat uit 3–5 senior specialisten die met AI-agents werken gedurende de volledige ontwikkelcyclus. De AI levert volume; de engineers bezitten de beslissingen.
- De snelheid komt voort uit het wegnemen van coördinatieoverhead, niet uit het beheren ervan. Een Pod van vier personen leverde de MVP in 3 maanden op, tegenover een traditionele schatting van 8 maanden.
- De kwaliteit blijft overeind omdat review structureel is ingebouwd. Elke door AI gegenereerde output wordt door een senior beoordeeld voordat die live gaat, en dezelfde discipline heeft een productiemigratie 40% sneller dan de baseline gedragen.
- Het model past bij afgebakende bouw, MVP’s met een deadline en moderniseringswerkstromen. Grote enterpriseprogramma’s met meerdere stromen vragen nog steeds om een andere structuur — en dat zeggen we ook.
Hoe een AI Pod werkt
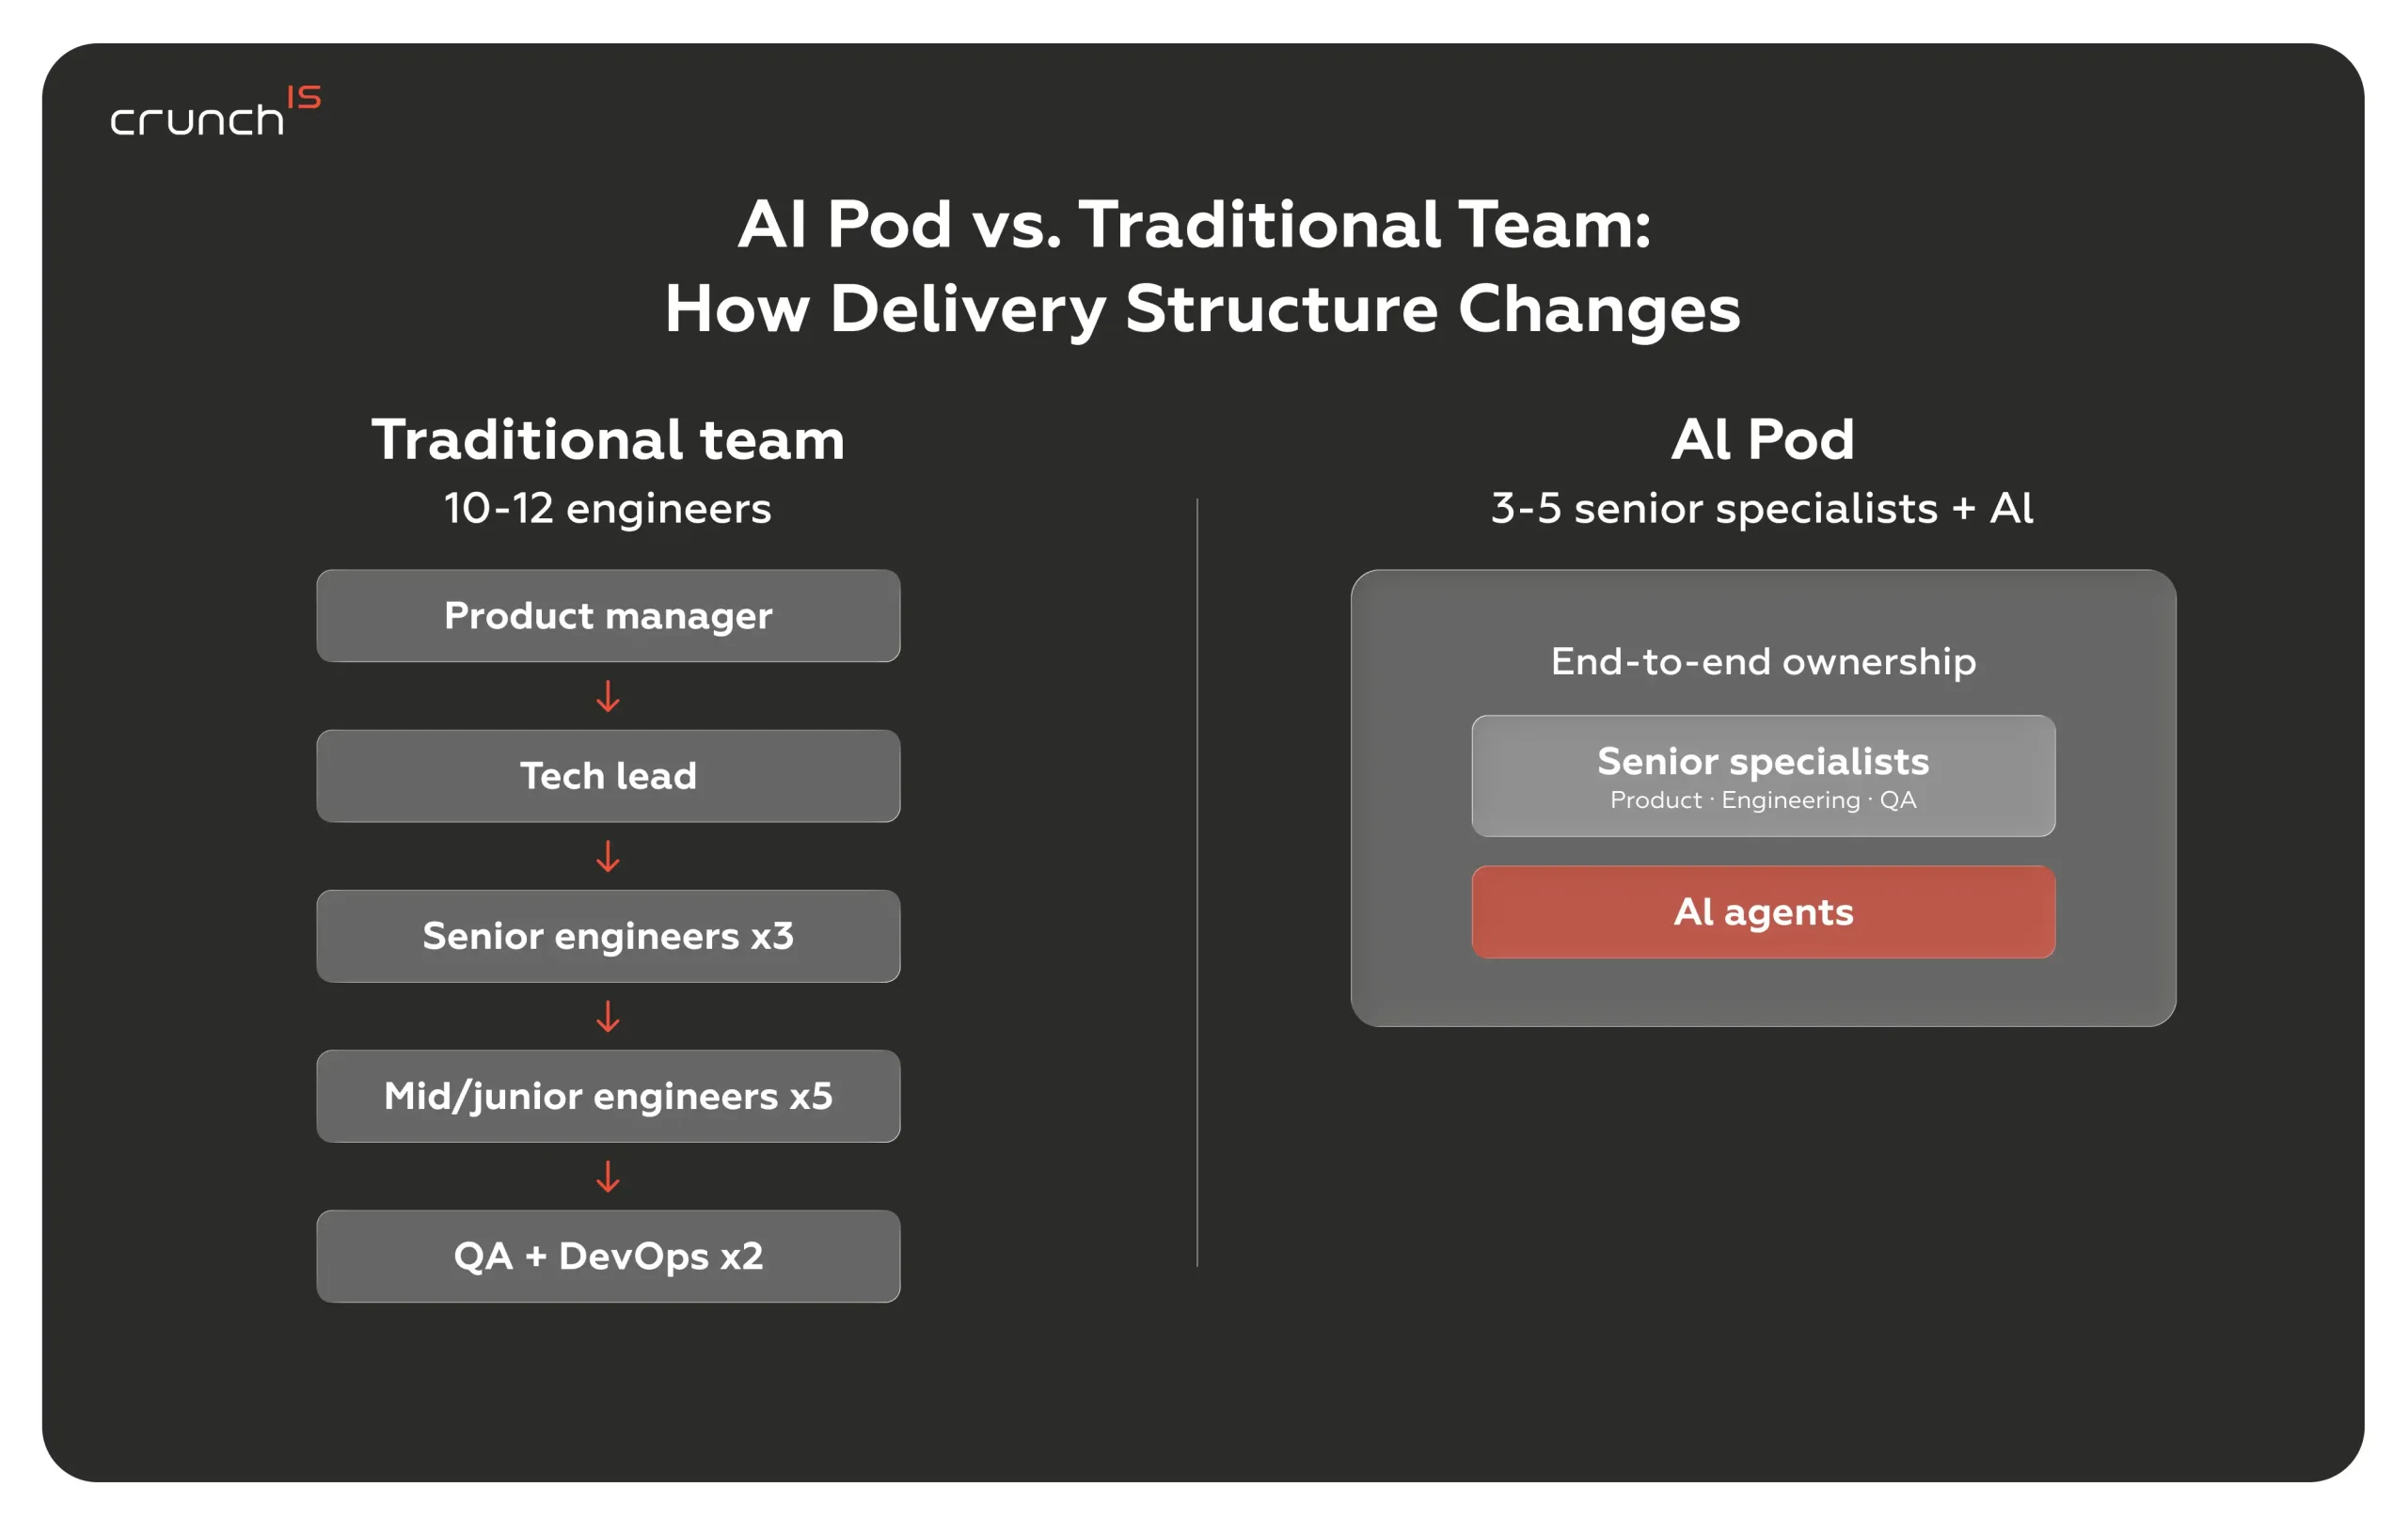
Een Pod is bewust klein: 3–5 senior specialisten, doorgaans een lead architect en engineers waarvan de mix afhangt van het project — backend, frontend, QA, data. Er is geen juniorlaag om aan te sturen en geen aparte documentatie- of rapportagerol, omdat dat werk naar de AI is verschoven.
De AI-agents opereren in elke fase van de levering. Tijdens de scoping stellen ze concept-requirements en randgevallen op uit bronmateriaal, die de lead corrigeert en goedkeurt. Tijdens de bouw genereren ze implementatiecode, produceren ze parallel testdekking en houden ze de documentatie gelijk met de codebase in plaats van erachter. Tijdens de review doen ze een eerste analytische slag, zodat senioraandacht naar ontwerpbeslissingen gaat en niet naar syntaxis.
De engineers doen het deel dat niet gedelegeerd kan worden. Zij maken de architectuurkeuzes, bepalen wat “klaar” betekent voor elk stuk werk, reviewen alles wat de AI produceert en dragen de verantwoordelijkheid voor elke regel die productie haalt. Om de verhouding gaat het: een klein aantal ervaren mensen dat een grote hoeveelheid gegenereerde output aanstuurt, waarbij niets ongereviewd wordt gemerged.
In het dagelijks werk verandert dit de vorm van het werk. Een specialist brengt een feature van requirement naar geteste code zonder die over drie rollen door te geven, en de feedbackloop die vroeger een hele sprint besloeg, sluit nu binnen een dag.
De verborgen kosten van traditionele engineeringteams
Coördinatielast doodt de leveringssnelheid
Een engineeringteam van tien mensen levert niet tien keer de output van één engineer. Het levert eerder drie of vier keer zoveel, en dat gat is coördinatieverlies. Elke overdracht tussen design, development en QA creëert wachttijd. Elke extra belanghebbende in een requirements-discussie vergroot het oppervlak waarop misverstanden ontstaan. Elke reviewlaag voegt vertraging toe voordat code live gaat.
Brooks’s Law beschrijft deze dynamiek in het extreme: mensen toevoegen aan een vertraagd project maakt het nog later. Het onderliggende mechanisme is echter op schaal altijd aanwezig. Grotere teams kosten niet alleen meer om te bemensen — ze kosten meer om te coördineren, en die kosten stapelen sneller op dan de output.
Hoe piramidebezetting de kosten per feature opdrijft
Traditionele leveringsteams zijn gebouwd als piramides: een handvol senior engineers aan de top, een bredere middenlaag en een basis van juniors die onder begeleiding het volumewerk doen. Dat model was logisch toen seniortijd het knelpunt was en junioroutput het betaalbare alternatief.
AI keert die logica om. Piramidestructuren met veel juniors leveren meer code op om te reviewen, meer defecten om op te sporen en meer context-switching voor senioren, die uiteindelijk output beheren in plaats van architectuur aan te sturen. BCG’s onderzoek uit 2026 naar AI-gedreven functietransformatie laat zien dat bij AI-adoptie senior medewerkers hun verantwoordelijkheden en productiviteit uitbreiden, terwijl instapfuncties in reikwijdte krimpen. Het piramidemodel spreidt kosten over het personeelsbestand zonder op kwaliteit te focussen, en de economie ervan wordt alleen maar slechter naarmate AI-ondersteunde softwareontwikkeling de norm wordt.
Hoe het AI Pod-model de leveringseconomie herbalanceert
Een compacte AI Pod — doorgaans 3–5 senior specialisten met AI ingebed in de hele leveringsworkflow — levert output die voorheen teams van twee of drie keer die omvang vereiste. BCG schat dat alleen al AI-ondersteunde augmentatie van ontwikkelaars productiviteitswinsten van 30–50% oplevert. McKinsey -onderzoek, gebaseerd op data van meer dan 600 organisaties, vond dat bedrijven die 80–100% AI-adoptie binnen engineering bereiken, winsten van meer dan 110% rapporteren.
De richting van die verschuiving is zichtbaar in hoe toonaangevende organisaties hun eigen teams opnieuw inrichten. In een McKinsey-webinar uit 2026 over AI-transformatie in ondernemingen omschreef McKinsey senior partner Rob Levin het opkomende model als “het terugbrengen van het two-pizza team van zo’n acht mensen naar twee: een product owner die weet hoe goed eruitziet, en een full-stack engineer die met codeschrijvende systemen kan werken, die code kan debuggen en in de architectuur kan inpassen.”
Pods met alleen senioren: lagere kosten per resultaat
AI Pods draaien op een samenstelling van uitsluitend senioren — niet omdat junior engineers geen waarde hebben, maar omdat AI nu het volumewerk doet dat hun aanstelling rechtvaardigde: boilerplate, testgeneratie, documentatie en eerste codeversies. Wat op Pod-niveau overblijft, vraagt om oordeelsvermogen.
Pods met alleen senioren kosten meer per persoon, maar minder per resultaat. Minder engineers betekent minder salarissen, minder inwerkcycli, minder managementlast en een kortere weg van requirement naar productie. Het kostenmodel verschuift van betalen voor capaciteit naar betalen voor levering.
Traditioneel team versus AI Pod: waar je voor betaalt
Gaat AI-gedreven ontwikkeling ten koste van kwaliteit?
De reflex is om aan te nemen dat kleinere teams output van lagere kwaliteit leveren. Het bewijs ondersteunt dat niet. In een gecontroleerd onderzoek van GitHub onder 243 ontwikkelaars liet code die met AI-ondersteuning tot stand kwam verbeteringen zien in leesbaarheid (3,6%), betrouwbaarheid (2,9%) en onderhoudbaarheid ten opzichte van baselines zonder AI. Ontwikkelaars keurden AI-ondersteunde code in peer review ook 5% vaker goed.
Testen, code review en documentatie gebeuren continu in een AI Pod — ingebouwd in de workflow, niet ingepland voor de week vóór de lancering. Fouten komen boven wanneer ze goedkoop te herstellen zijn, niet nadat ze al live staan. Tegen de tijd dat de code productie bereikt, is die grondiger getoetst dan de meeste traditioneel bemenste teams in een hele sprint doen.
Commercieel is dat van belang. Minder defecten in productie betekenen minder herstelwerk, minder incidentafhandeling en lagere total cost of ownership — voordelen die zich met elke release opstapelen.
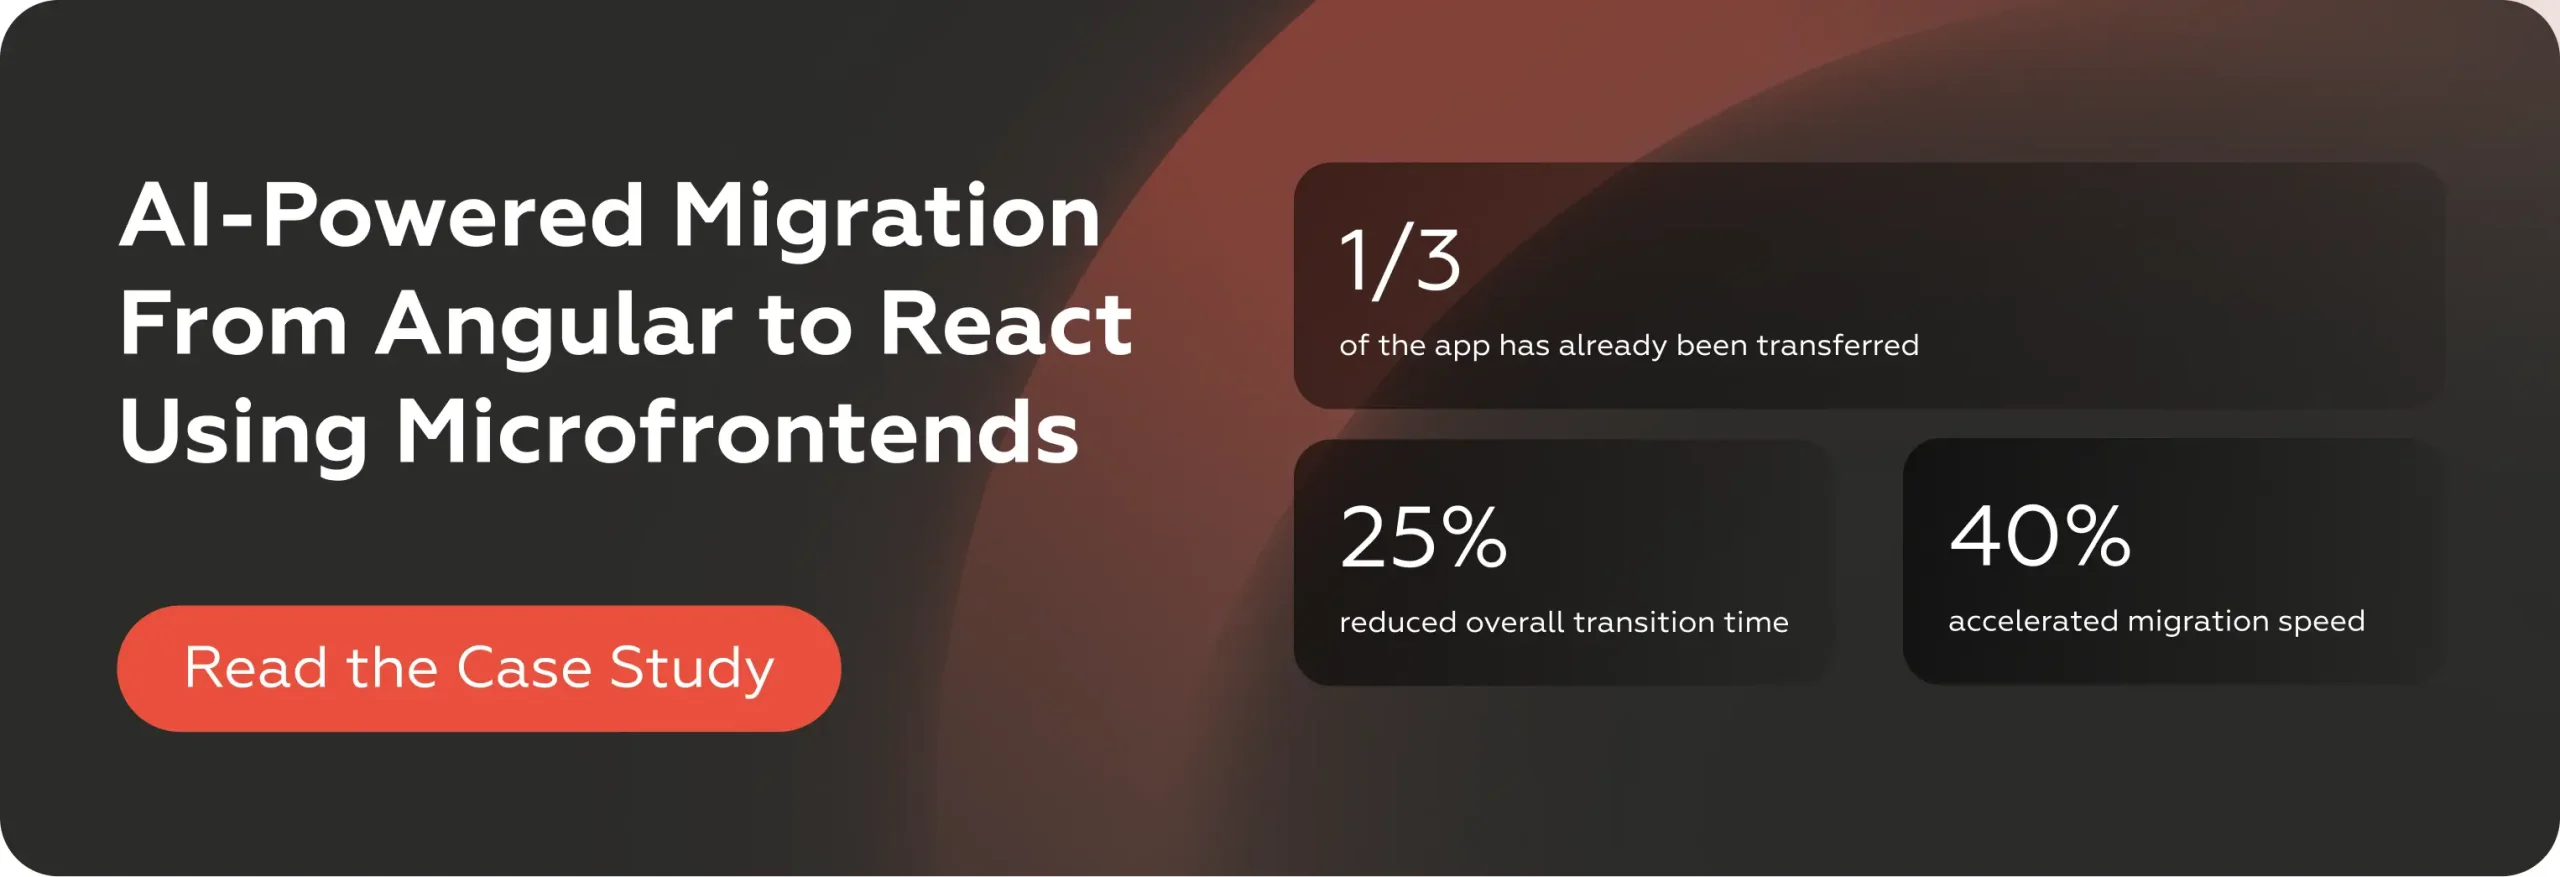
Ons eigen bewijs draait op productieschaal. In een lopende Angular-naar-React-migratie van een productieapplicatie verplaatste de Pod-aanpak 1/3 van de applicatie, en dat 40% sneller dan de baseline van het project van vóór AI — gemeten op dezelfde codebase, met hetzelfde team en dezelfde standaarden.
Waar het model past — en waar niet
Het Pod-model is het sterkst waar de scope gedefinieerd is en de deadline dichtbij: een MVP die de markt moet halen, een systeemvervanging die de bedrijfsvoering niet mag stilleggen, een moderniseringstraject binnen een groter platform, of een nieuwe productlijn die de organisatie wil bouwen zonder daarvoor het organigram uit te breiden.
Het is niet het antwoord op alles. Een enterprise-programma met meerdere parallelle trajecten en zwaar stakeholdermanagement over afdelingen heen heeft nog steeds een grotere structuur nodig, en zo zetten we het dan ook op. Het leveringsmodel op de opdracht afstemmen hoort bij het engineeringwerk.
Conclusie
Kleinere teams leveren sneller wanneer de structuur coördinatie wegneemt in plaats van die te managen. Het AI Pod-model doet precies dat: senior specialisten die AI-gegenereerd volume aansturen, met review ingebouwd in elke stap en resultaten gemeten in productie — een MVP in drie maanden tegenover een schatting van acht maanden, een lopende migratie die draait op 40% boven de baseline.