Industrielle Dateninfrastruktur für die Bereitschaft zum digitalen Zwilling in der Öl- und Gasindustrie

Industrielle Dateninfrastruktur für die Bereitschaft zum digitalen Zwilling in der Öl- und Gasindustrie | Crunch-IS Case Study
Wir richteten eine sichere, wiederholbare Datenpipeline vom isolierten Anlagennetzwerk zu AWS ein, sammelten kontinuierlich ausgewählte Sensor- und SCADA-Daten, strukturierten sie nach physischen Assets und speisten sie in einen AWS-Data-Lake ein. Damit erhielt ein US-amerikanischer Öl- und Gasbetreiber die Datengrundlage, die er für zukünftige Anwendungsfälle des digitalen Zwillings benötigt.
Industrie:

Öl & Gas

Standort:

USA

Teamgröße:

6

Dauer:

5 Monate

Technologies
AWS IoT Core
AWS IoT SiteWise
Amazon S3
AWS Glue
AWS Glue Data Catalog
Amazon Athena
Grafana
Amazon CloudWatch
Litmus Edge
01

Über den Kunden

Der Kunde betreibt eine Anlage zur Verarbeitung und Verdichtung von Erdgas in den Vereinigten Staaten. Die Anlage befasst sich mit der Einlassseparation, der Gaskompression, der Gastrocknung, der Aminbehandlung, der Kondensatspeicherung, der Exportmessung und dem Fackelmanagement – eine dichte Betriebsumgebung, die kontinuierlich Sensordaten über Dutzende von Anlagen generiert.

In der Anlage liefen SCADA-Systeme, SPS, ein lokaler Historian und technische Tabellenkalkulationen. All das war auf das Netzwerk der Anlage beschränkt.
Industrielle Dateninfrastruktur für die Bereitschaft zum digitalen Zwilling in der Öl- und Gasindustrie | Crunch-IS Case Study
02

Herausforderung

Der Kunde verfügte über wertvolle Anlagendaten aus vielen Jahren. Nichts davon war für den digitalen Zwilling geeignet.

Die Kernprobleme waren:

  1. Daten im Anlagennetzwerk eingeschlossen. Sensormesswerte, Historian-Tags und SCADA-Ausgaben waren nur vor Ort zugänglich. Es gab keine Cloud-Infrastruktur. Anbieter von digitalen Zwillingen hatten keinen Zugriff auf die Daten.
  2. Tags ohne Kontext. SCADA- und Historian-Tags waren nicht standardisiert und wurden nicht den physischen Assets zugeordnet. Ein Tag-Wert allein sagte nichts darüber aus, welchen Kompressor, Abscheider oder welches Ventil er beschrieb.
  3. Keine Asset-Hierarchie. Die Ingenieurteams hatten kein sauberes, strukturiertes Modell, das die Sensordaten mit den von ihnen überwachten physischen Geräten verband. Die Daten waren zwar vorhanden, aber sie waren nicht so organisiert, dass eine Modellierung oder Analyse möglich war.
  4. Fragmentierte historische Daten. Historische Aufzeichnungen waren über lokale Systeme verstreut, hatten keine einheitliche Struktur, wiesen inkonsistente Zeitstempel auf und enthielten keine Qualitätskennzeichen. Die Erstellung eines kohärenten Bildes über das frühere Verhalten der Anlage erforderte einen manuellen Aufwand, den das Team nicht aufrechterhalten konnte.
  5. Kein Weg zu Cloud-Analysen. Ohne einen Data Lake gab es keine Grundlage für digitale Zwillingsszenarien, vorausschauende Wartung oder betriebliche Dashboards – unabhängig davon, welche Tools der Kunde später einsetzen wollte.
03

Gelieferte Lösung

Wir bauten eine sichere, strukturierte Dateninfrastruktur auf, die Anlagendaten aus SCADA- und Historian-Systemen in einen cloudbasierten AWS-Data-Lake überführte – organisiert nach Anlagen, standardisiert nach Qualität und bereit für die Nutzung des digitalen Zwillings.

Datenerfassung von OT bis zur Cloud

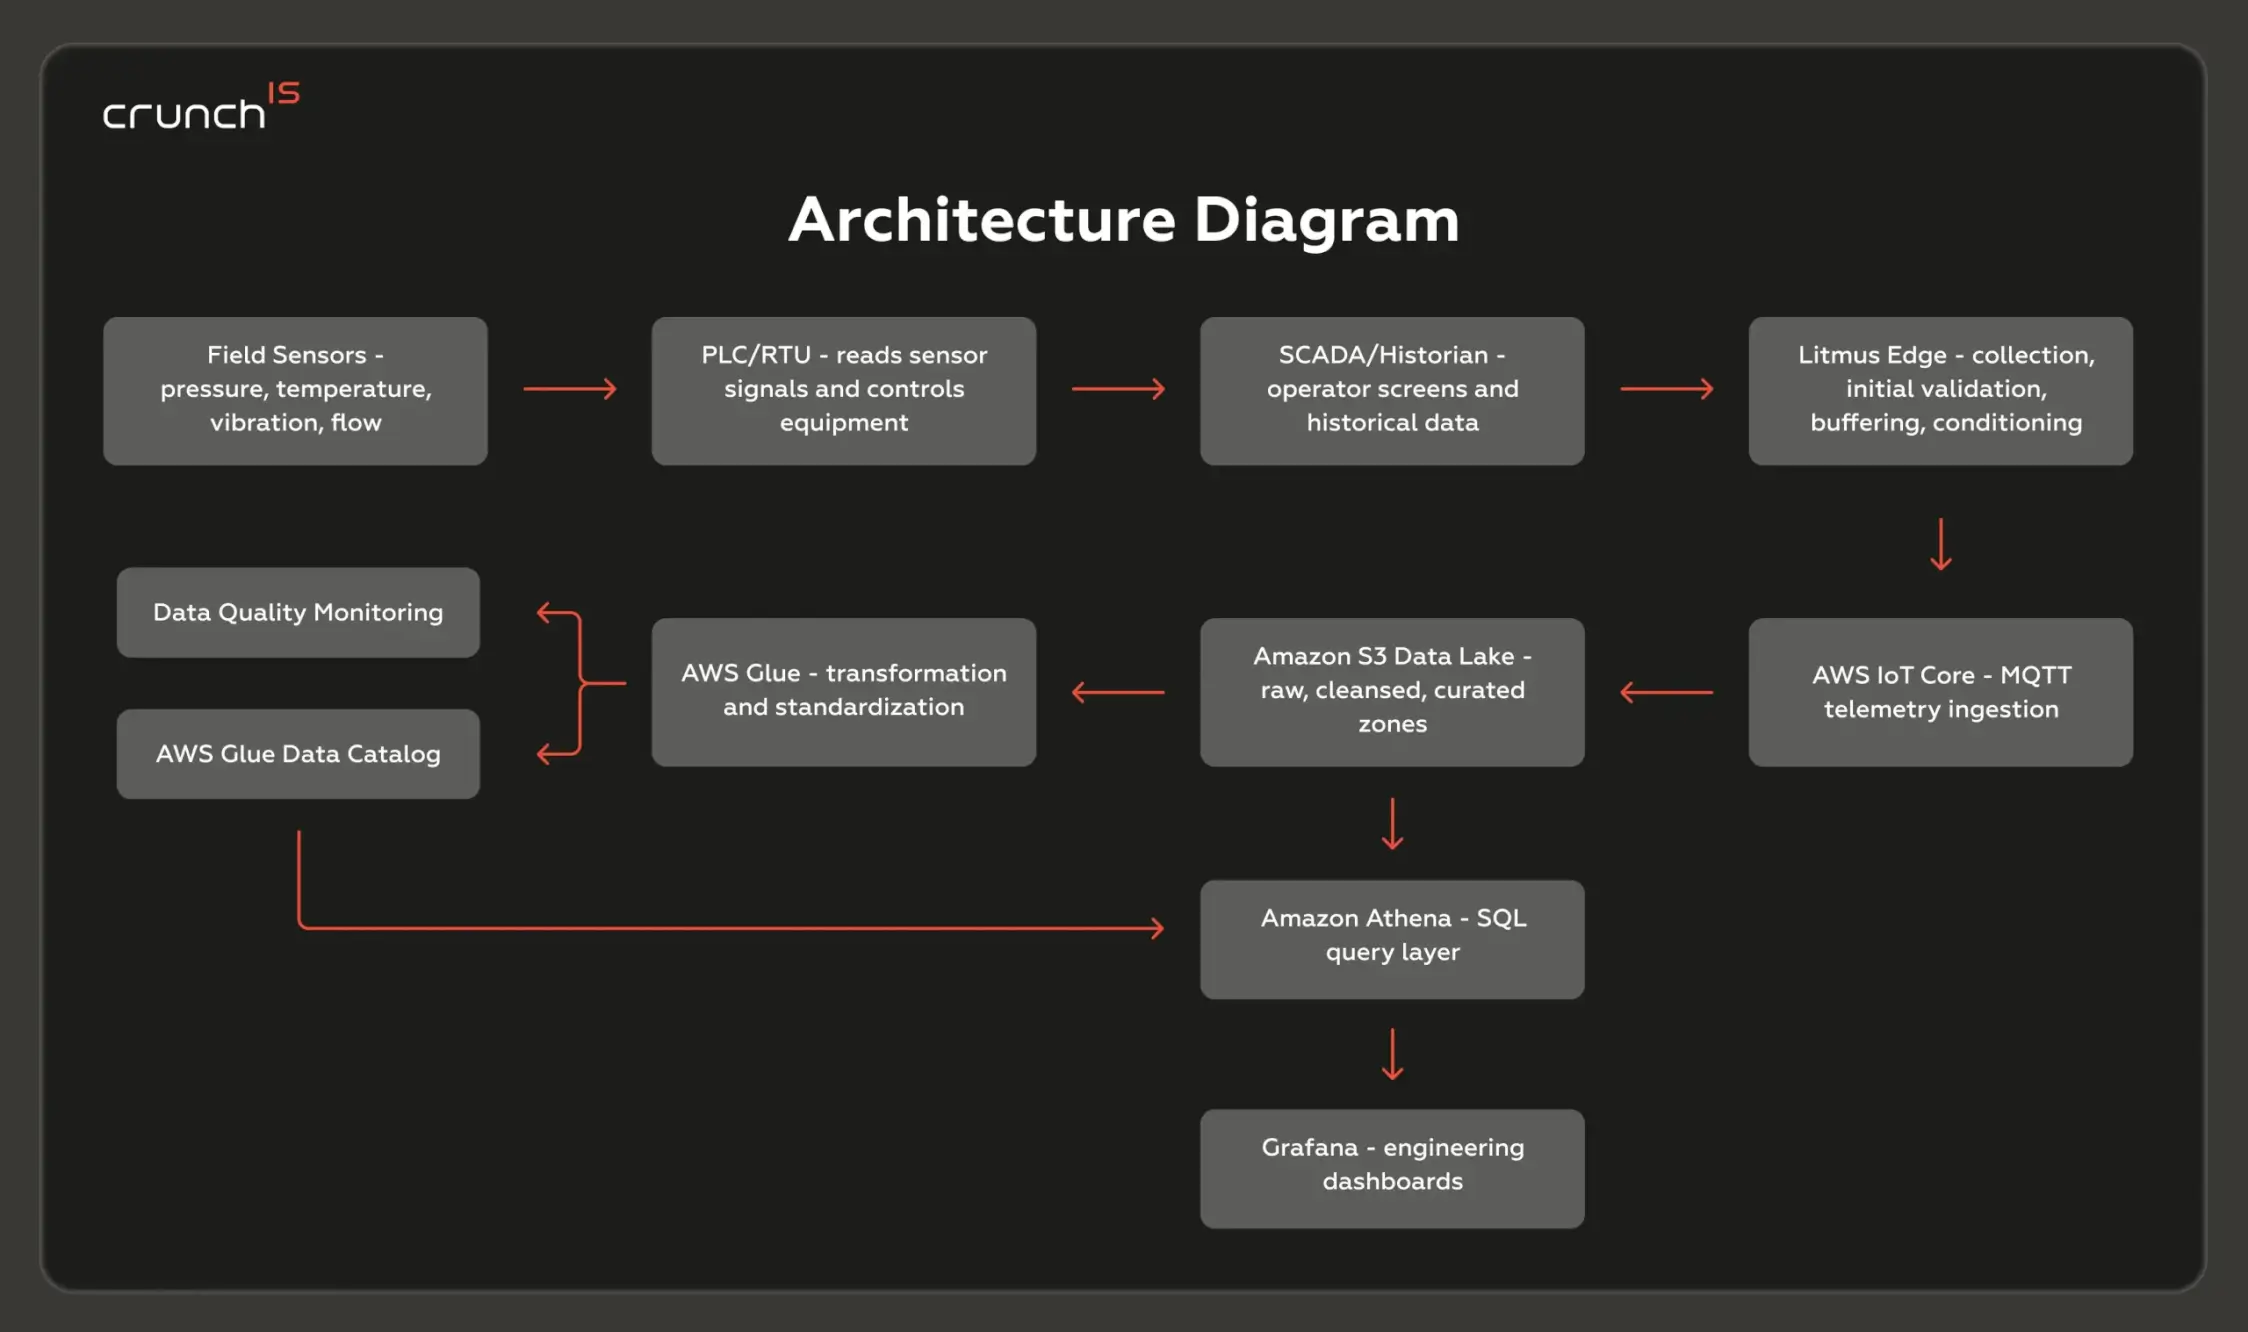
Wir haben einen sicheren Pfad vom Werksnetz zu AWS eingerichtet. Litmus Edge wurde an der OT/IT-Grenze eingesetzt, um eine Nur-Lese-Verbindung zum SCADA-System der Anlage und zum lokalen Historian herzustellen. Es sammelte freigegebene Betriebs-Tags, führte eine erste Validierung und Datenaufbereitung durch, pufferte die Daten bei Bedarf und bereitete die Telemetrie für die Aufnahme in die Cloud vor.

Von Litmus Edge aus wurden ausgewählte Telemetriedaten mit MQTT über TLS sicher an AWS IoT Core weitergeleitet. AWS IoT Core kümmerte sich um die Geräteauthentifizierung, die verschlüsselte Kommunikation und das Telemetrie-Routing von der industriellen Edge-Ebene zu AWS. AWS IoT SiteWise organisierte die eingehenden Zeitseriendaten rund um die physischen Anlagen – Kompressoren, Abscheider, Pumpen, Ventile – und verwandelte die rohen SCADA-Tags in kontextualisierte Daten, die für die nachgelagerten Systeme sinnvoll waren.

Data-Lake-Architektur auf Amazon S3

Rohe, bereinigte und kuratierte Daten wurden in einen strukturierten Data Lake auf Amazon S3 mit drei verschiedenen Zonen geladen. Bei der Rohdatenaufnahme wurden die Quelldaten unverändert übernommen. In der bereinigten Zone wurden standardisierte Zeitstempel, Einheiten, Tag-Namen und Qualitätskennzeichen verwendet. Die kuratierte Zone enthielt verarbeitete Datensätze, die speziell für die Verwendung als digitaler Zwilling und zur Analyse aufbereitet wurden.

Tag-Mapping und Asset-Hierarchie

Wir überprüften und exportierten SCADA- und Historian-Tag-Listen und ordneten dann jedes Sensor-Tag den entsprechenden Geräten und Prozesseinheiten zu. Das Ergebnis war eine saubere Asset-Hierarchie für die Anlage, die jeden Datenpunkt mit dem physischen Asset verbindet, das er beschreibt.

Datenumwandlung mit AWS Glue

AWS Glue hat die Bereinigung, Umwandlung und Vorbereitung im großen Maßstab übernommen. AWS Glue Data Catalog speichert Metadaten, Schemata und Tabellendefinitionen, damit die Datensätze auffindbar und abfragbar sind. Amazon Athena ermöglichte den Technikern den direkten SQL-Zugriff auf die Daten in S3.

Überwachung der Datenqualität

Wir führten eine erste Datenvalidierung durch, um die Vollständigkeit, Genauigkeit und die erwarteten Sensorbereiche in der gesamten Tag-Population zu bestätigen. Die laufende Überwachung – mit Amazon CloudWatch – erkannte fehlende Werte, veraltete Tags, anormale Messwerte und Lücken in der Datenaufnahme in Echtzeit.

Grafana-Dashboards

Grafana wurde als technische Dashboard-Ebene über den kuratierten AWS-Daten verwendet. Damit konnten Betriebs- und Technikbenutzer ausgewählte SCADA-Trends visualisieren, Datenqualitätsmetriken überwachen, Lücken in der Datenaufnahme identifizieren und wichtige Anlagensignale überprüfen, bevor die Daten von zukünftigen digitalen Zwillingsanwendungen genutzt wurden.

Crunch-IS image case study
04

Die Ergebnisse des Kunden

Der Kunde erhielt eine sichere Datengrundlage für die Implementierung des digitalen Zwillings. Die Sensor- und SCADA-Daten der Anlage wurden extrahiert, standardisiert, den physischen Anlagen zugeordnet und in AWS abgelegt. So konnte der Kunde von isolierten Anlagendaten zu cloudbasierten Analysen, digitalen Zwillingsszenarien und zukünftigen Anwendungsfällen für die vorausschauende Wartung übergehen.

Erzählen Sie uns, was Sie entwickeln

Schicken Sie uns eine Skizze, eine Spezifikation oder drei Sätze dazu, wo Ihr System gerade feststeckt. Ein Gespräch reicht in der Regel, um herauszufinden, ob wir zueinander passen.

Individuelle Software, KI & ML, Daten und Analytics, Cloud und Sicherheit – vom ersten Scoping bis zur langfristigen Umsetzung.

  • 170+ Experten
  • 120+ abgeschlossene Projekte
  • 97% rundum zufrieden

    Ich habe die Nutzungsbedingungen und Datenschutzbestimmungen gelesen und akzeptiert *

    Ihre Privatsphäre ist uns wichtig. Wir verwenden Cookies, um Ihr Erlebnis zu verbessern und Inhalte zu personalisieren.